
09.23 週三 AI 新聞總覽
今天從 25 個來源挑出 60 條,分成 5 類,先看這 5 條重點。今日重點
Claude Opus 5.5 現已上線 Vercel AI Gateway
Claude Opus 5.5 上線 Vercel AI Gateway,比 Opus 5 快 30%、便宜 40%,支援 1M token 上下文,可評估換模型省成本。 該模型比 Opus 5 快約 30% 且成本低約 40%,並引入了自適應思考機制,廢除了強制工具調用。它支援 1M token 上下文窗口,適合需要處理複雜編碼任務和長對話的 AI 應用開發者,特別是在使用 Vercel AI SDK 的團隊中。 Vercel Blog 另見 AWS ML Blog
Transformers 現在支援執行 llama.cpp 量化模型
Transformers 新增 GGUF 原生支援,可直接 from_pretrained 載入量化模型跑本地推理,接近 llama.cpp 效能。 Hugging Face Blog
推出 GPT-6 Sol 與 Luna 模型
OpenAI 發布 GPT-6 Sol 與 Luna 兩款模型,依場景在效能與成本間做選型評估。 OpenAI News 另見 Vercel Blog、AWS ML Blog、Qiita (LLM)
Reactiv 利用 Amazon Bedrock AgentCore 將行動商務自動化速度提升 80%
Reactiv 用 Bedrock AgentCore 把商家配置時間縮短 80%,提供電商 Agent 自動化的具體效益參考。 AWS ML Blog
AWS 開源 Strands Harness,預組代理最佳化設定降低詞元成本達 28%
AWS 開源 Strands Harness,官方測試 Token 成本比 Claude Code 低 28%,內建自動截短工具結果省 token。 iThome今日摘要
OpenAI一次推出GPT-6系列的Sol、Luna與Astra,加上Prompt Caching斷點控制優化,是今天最大的訊號:模型廠正把「前沿智能」拆成不同成本/性能檔位塞進日常工作流,而非單一旗艦打天下,Parallel用Astra把研究時間與成本砍半即為明證。第二條主線是Agent執行基礎設施全面成熟:Google開源Agent Substrate與AX主打百萬級沙箱高密度調度,Vercel Sandbox Drives解決Agent狀態持久化,AWS的Strands Harness更宣稱比Claude Code省28% token,顯示大家開始認真解決Agent規模化部署的成本與穩定性問題,而非只堆功能。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-09-23 這一天,追蹤的 25 個來源共產出 60 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-09-22 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 8 | The Rundown AI、Ben's Bites、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 5 | OpenAI News、Google AI Developers Blog |
| Agents、MCP 與開發工具 | 14 | Hugging Face Blog、Hugging Face Daily Papers、PydanticAI Releases |
| AI App、部署與雲端 | 18 | GitHub Trending、GitHub Trending (TypeScript)、Vercel Blog、Vercel AI SDK Releases、Cloudflare Blog、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 15 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- Claude Opus 5.5 現已上線 Vercel AI Gateway:Claude Opus 5.5 上線 Vercel AI Gateway,比 Opus 5 快 30%、便宜 40%,支援 1M token 上下文,可評估換模型省成本。(Vercel Blog)
- Transformers 現在支援執行 llama.cpp 量化模型:Transformers 新增 GGUF 原生支援,可直接 from_pretrained 載入量化模型跑本地推理,接近 llama.cpp 效能。(Hugging Face Blog)
- 推出 GPT-6 Sol 與 Luna 模型:OpenAI 發布 GPT-6 Sol 與 Luna 兩款模型,依場景在效能與成本間做選型評估。(OpenAI News)
- Reactiv 利用 Amazon Bedrock AgentCore 將行動商務自動化速度提升 80%:Reactiv 用 Bedrock AgentCore 把商家配置時間縮短 80%,提供電商 Agent 自動化的具體效益參考。(AWS ML Blog)
- AWS 開源 Strands Harness,預組代理最佳化設定降低詞元成本達 28%:AWS 開源 Strands Harness,官方測試 Token 成本比 Claude Code 低 28%,內建自動截短工具結果省 token。(iThome)
每日 AI 新聞與電子報8 條
Amazon 封鎖 Meta 的 Muse AI 代理
Amazon 指控 Meta 的 Muse 代理未識別身分瀏覽商店並可能儲存用戶登入憑證,遂於上線 12 天後封鎖其存取。為什麼重要
此衝突凸顯 AI 代理在電商場景中的安全與隱私爭議,對開發 Agentic Shopping 功能的團隊及關注平台政策變化的產品經理至關重要。Amazon 認為 Muse 違反使用條款,而 Meta 否認能存取密碼或支付資訊,雙方對「代理行為邊界」的定義存在根本分歧。
Jev 開放使用:專為工具內嵌設計的 LLM 應用
TypeSafe 的 Jev 正式開放,定位為嵌入工具內的輕量 LLM,適合分類、評分等結構化任務;Claude Code 推出 Projects 重構與 AGENTS.md 支援。為什麼重要
Jev 與通用 LLM 不同,專為在應用內執行快速、低成本推理設計,適合需要即時分類或相關性評分的前端/後端開發者。Claude Code 的 Projects 功能允許單線程管理多任務並生成雲端會話,對使用 Claude 進行自動化開發的團隊有直接影響。
Perplexity 利用失敗案例訓練 Agent,工具呼叫錯誤率降低 21%
Perplexity 發布後訓練方法,結合拒絕採樣與提示引導自蒸餾,從真實失敗會話中學習,使 Computer Agent 的工具呼叫失敗率相對降低 21.2%。為什麼重要
此技術對開發具工具呼叫能力的 AI Agent 團隊具有重要參考價值,展示了如何將生產環境中的錯誤轉化為訓練數據。方法強調時間一致性約束,避免模型學習到事後才知情的錯誤修正,確保訓練數據的因果邏輯正確。
Cartesia Sonic 3.6 在九種語言 TTS 排行榜中佔據八席
Artificial Analysis 擴展 TTS 排行榜至九種語言,Cartesia Sonic 3.6 在八種語言中排名第一,Inworld 在中文中領先,ElevenLabs 表現穩健。為什麼重要
對需要多語言語音合成能力的產品團隊,此排行榜提供了超越英語基準的選型依據。結果顯示不同語言間模型表現差異顯著,開發者應根據目標市場選擇最佳模型,而非僅依賴英語排名。
Together AI 提出 Score Centering 修正 LLM RL 訓練偏差
Together AI 發表新論文,提出 Score Centering 方法,消除推論與訓練引擎間數值差異導致的策略梯度偏差,穩定 LLM 強化學習訓練。為什麼重要
此問題影響所有使用離線推論引擎(如 vLLM)與線上訓練框架分離架構的 RL 訓練流程。Score Centering 無需重要性採樣剪裁,且額外計算開銷低於 1%,為解決推論-訓練不一致性提供了輕量級解決方案。
10 個 Claude Opus 5.5 代理協作證明更快速最短路徑演算法
Vals AI 報告 10 個 Claude Opus 5.5 代理花費 15 小時協作,設計並用 Lean 驗證了 C-HD 最短路徑演算法,在特定圖密度下超越現有理論界。為什麼重要
此案例展示了多代理系統在複雜數學證明與演算法設計中的潛力,對研究 AI 輔助科學發現(AI for Science)的團隊具有啟發意義。雖然優勢僅在特定漸近範圍內,但 Lean 驗證確保了定理的嚴謹性,體現了 AI 在形式化驗證中的應用價值。
John Platt 談 Google ERA:AI 自動化科學研究與氣候變遷
Google 的 John Platt 介紹 Empirical Research Assistance (ERA) 系統,利用 LLM 與蒙特卡洛樹搜索自動化解決可量化科學問題,已產出多篇論文。為什麼重要
ERA 展示了 LLM 在科學發現中的實際應用,特別是在氣候變遷等領域。對關注 AI for Science 的研究者與產品經理,此案例提供了將 AI 應用於複雜優化問題的具體架構參考,強調了「可評分任務」的抽象化價值。
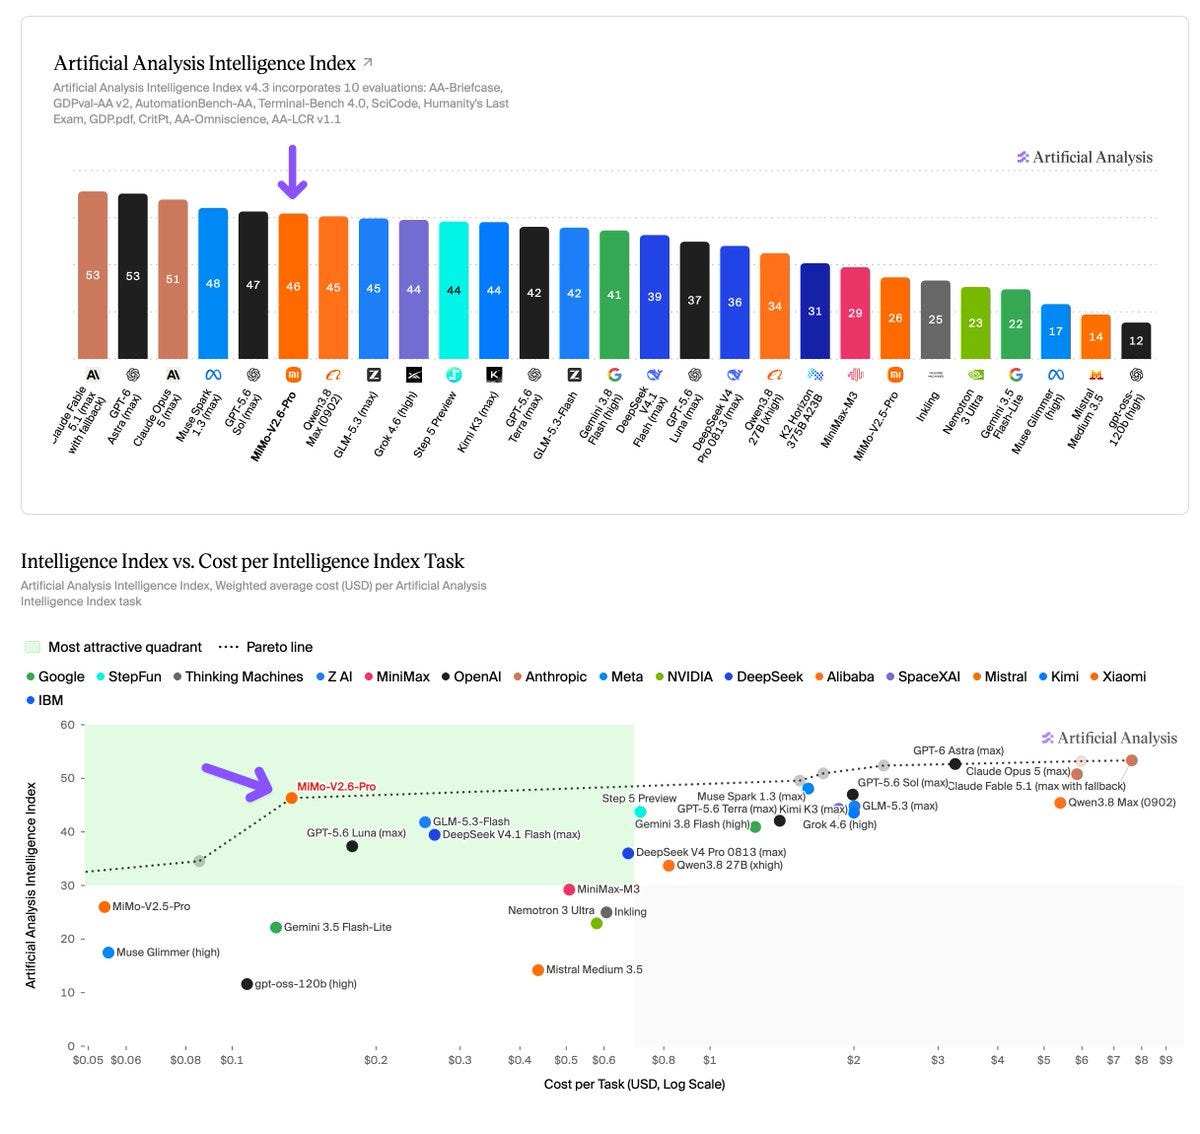
Xiaomi MiMo-V2.6-Pro 成為新開源權重模型榜首
Xiaomi 發布 MiMo-V2.6-Pro,以 300 萬美元訓練成本成為 Artificial Analysis 指數上最高分的開源權重模型,支援 1M 上下文與多模態任務。為什麼重要
對尋找高性價比開源模型的團隊,MiMo-V2.6-Pro 在智能與成本帕累托前沿上的表現值得關注。Xiaomi 公開了 RL 訓練細節與環境代碼,展示了大規模強化學習在 Agent 能力訓練中的實踐,對研究開源模型訓練流程的工程師有參考價值。
模型公司與研究機構5 條
GPT-6 的 Prompt Caching 優化
OpenAI 宣布 GPT-6 提升 Prompt Caching 效能,透過更高命中率、新診斷工具及明確斷點控制,降低延遲與成本。為什麼重要
此更新對使用長上下文或重複 Prompt 的開發者至關重要,能顯著降低 API 調用成本。GPT-6 引入了顯式斷點(explicit breakpoints)與診斷功能,讓工程師能更精確地控制快取行為,適合關注 LLM 推理效率與成本優化的團隊。
推出 GPT-6 Sol 與 Luna 模型
OpenAI 發布 GPT-6 Sol 與 Luna 兩款模型,針對日常任務提供不同能力與成本平衡的前沿智能體驗。為什麼重要
這為產品經理與工程師提供了新的模型選擇,可根據應用場景在性能與成本間取捨。Sol 與 Luna 旨在將前沿智能應用於日常工作流程,適合需要平衡 API 開銷與模型表現的開發團隊評估採用。
Parallel 利用 GPT-6 Astra 將研究時間與成本減半
Parallel 使用 GPT-6 Astra 進行勞動力市場數據研究與綜合,相比先前模型,時間與成本均減少一半。為什麼重要
此案例展示了 GPT-6 Astra 在 Agent 工作流中的實際效益,特別是在數據綜合與研究任務上。對於構建自動化研究 Agent 或處理大量非結構化數據的團隊,此數據提供了模型選型的具體參考依據。
有效第三方評估的優先事項與原則
OpenAI 提出針對前沿模型與安全防護的第三方 AI 安全評估原則,強調嚴謹性、安全性與獨立性。為什麼重要
此文件對關注 AI 安全合規與模型部署風險的企業至關重要。它定義了如何進行獨立且嚴格的第三方評估,適合負責 AI 治理、安全合規或前沿模型部署的團隊參考,以確保評估流程的標準化與可信度。

Colab 正式納入 Google AI 訂閱方案
Google AI 訂閱者現可享有 Colab 高級計算資源,包括優先加速器、Premium GPU 及背景執行功能,支援長時間訓練。為什麼重要
此更新對使用 Colab 進行模型訓練或實驗的開發者影響重大,特別是 Ultra 訂閱者可進行中斷的背景執行。這降低了長期訓練任務的門檻,適合需要高算力資源且希望整合 Google AI 生態系(如 Gemini、AI Studio)的研究者與工程師。
Agents、MCP 與開發工具14 條

UK AISI 與 EvalEval 合作推動基準測試結果可重現性
UK AISI 採用 EvalEval 基礎設施公開分享評估結果,涵蓋 Claude 與 GPT-5 系列模型在多個前沿基準上的表現,以支持可重現的評估科學。為什麼重要
此舉解決了 AI 評估結果格式混亂、難以重現的痛點,對關注模型基準測試與安全評估的研究者及工程師至關重要。AISI 公開了 HealthBench、SWE-Bench Pro 等五個基準的詳細配置與結果,涵蓋 Claude Opus 4.x 及 GPT-5.x 等六款前沿模型,並包含推理計算對性能影響的分析。
Transformers 現在支援執行 llama.cpp 量化模型
Hugging Face Transformers 新增對 GGUF 格式模型的原生支援,允許開發者透過 from_pretrained 直接載入並執行本地量化模型,無需額外配置。為什麼重要
這降低了在本地設備(特別是 Apple Silicon)上運行大模型的門檻,適合需要離線推理或資源受限環境的開發者。透過重用 ggml kernels,性能接近 llama.cpp,目前優先支援 Qwen3.5 架構,並建議使用 Q4_K_M 等量化版本以平衡記憶體與精度。

oMLX 創作者 Jun Kim 加入 Hugging Face 支援 MLX 社群
Apple MLX 框架核心貢獻者 Jun Kim 加入 Hugging Face,將專注於 oMLX 的維護與開發,並促進 Transformers 模型向 MLX 生態系的轉換。為什麼重要
此舉強化了本地 AI 生態系,特別是 Apple Silicon 用戶的體驗。Jun 將負責將 Transformers 中的模型定義快速轉換為 MLX 參考實現,並與 mlx-lm、LM Studio 等專案協作,確保 oMLX 作為 Apache 2.0 專案的穩定發展與長期維護。

RRSI:Agent 框架的正則化遞迴自我改進
Google Research 提出 RRSI 方法,透過正則化約束 Agent 框架的遞迴自我改進過程,解決過擬合問題,在保持分布內性能的同時提升分布外泛化能力。為什麼重要
對開發 LLM Agent 系統的工程師具有重要參考價值,特別是那些嘗試自動化優化 Prompt、工具鏈或記憶管理的團隊。RRSI 在八個基準測試中,分布外基準提升最高達 4.7 分,且生成的框架比未正則化版本減少 30% 的 policy tokens 使用量。

WorldCrafter:具備隱式 3D 感知記憶的視頻世界模型
騰訊 ARC 團隊發布 WorldCrafter,一種視頻世界模型,利用隱式 3D 感知記憶實現長時程場景探索的一致性與相機控制。為什麼重要
該模型結合歷史觀察、近期時間上下文與少步蒸餾,支持流式探索,適合關注視頻生成、世界模型及具身智能研究的開發者。其核心優勢在於解決長視頻生成中的場景一致性問題,並提供精確的相機控制能力。

GameHorizon Suite:遊戲玩法的多時程數據與評估套件
推出 GameHorizon Suite,包含自動化標註管線、5000 小時 AAA 遊戲數據集及基準測試,用於評估 AI 模型在視覺理解、指令分解及動作控制上的多時程能力。為什麼重要
為評估多模態模型在複雜交互任務中的表現提供了標準化平台,適合從事具身智能、遊戲 AI 或多模態推理研究的團隊。該套件涵蓋 21 款遊戲,並通過 47 個模型的評估揭示了不同任務難度層級及模型能力差異。

將 VLM 的智能遷移至機器人控制
研究提出 RoboDawn 接口,讓視覺語言模型(VLM)透過離散指令閉環控制機器人,無需任務特定訓練即可實現強勁的零樣本及少樣本性能。為什麼重要
展示了通用 VLM 在物理世界機器人控制中的潛力,對關注具身智能及 VLM 應用的研究者有啟發意義。在 RoboTwin 2.0 基準上,零樣本成功率 53.2%,單次上下文演示後提升至 73.6%,超越基於特定數據訓練的基線模型。

OmniEdu:用於學習與教學的開放基礎模型
發布 OmniEdu 系列開放基礎模型,專為 K-12 教育設計,結合解題、課程理解、診斷推理及教學支持四大能力,提供 4B 至 27B 不同規模的模型。為什麼重要
為教育科技領域提供了一個能力均衡的開源基礎模型選項,適合開發教育類 AI 應用或研究教育大模型微調策略的團隊。OmniEdu-27B 在 K12-Bench 等教育基準上表現優異,並保持了通用能力。

D-RAC:企業文檔的檢索感知分塊方法
提出 D-RAC 方法,透過 PDF 正規化與多模態 Markdown 轉換,實現企業文檔的高效檢索感知分塊,大幅降低 RAG 系統的 token 成本與延遲。為什麼重要
對構建企業級 RAG 系統的開發者極具實用價值,特別是需要處理複雜 PDF、表格及多列佈局文檔的場景。相比代理式分塊,D-RAC 將分塊階段輸出 token 減少 95.7%,成本降低 77.8% 至 85.6%,且支持 500 頁以上文檔的線性擴展。

VideoGen-Agent:強化視頻生成代理
提出 VideoGen-Agent,一個透過多任務代理強化學習訓練的多模態代理,能協調增強、生成及驗證工具來優化視頻生成質量。為什麼重要
展示了代理框架在複雜視頻生成任務中的應用潛力,適合關注視頻生成、代理強化學習及工具調用優化的研究人員。在 VABench 基準上,該代理將基礎生成器得分從 56.5 提升至 75.6,並能隨生成工具升級而進一步提升性能。

onPanda:透過 Token 級修正高效標註 LLM 對齊數據
發布 onPanda 工具,採用 Token 級修正交互方式標註 LLM 對齊數據及 Agent 軌跡,顯著降低標註成本並保留模型採樣分佈。為什麼重要
對需要構建高質量 SFT 或偏好數據的團隊非常有用,特別是在資源有限的情況下。該工具將中位標註時間減少 52%,並提供細粒度的正負樣本對,同時發布了 Panda-CVL 數據集及 Token 級修正基準。

Grounded Action Model:以 3D 定位為基礎的機器人模型
提出 Grounded Action Models (GAMs),一種基於 3D 定位的機器人基礎模型範式,透過共享對象中心表示預測動作塊,提升機器人操作的魯棒性。為什麼重要
為機器人基礎模型設計提供了新思路,特別是在處理動態場景及長時程任務時。GAM 在 RoboTwin 2.0 上平均成功率 55.3%,在 LIBERO-PRO 上達到 61% 的 SOTA 水平,並能在真實機器人上保持高成功率。

One to More, More to One:軟體工程代理的類別感知迭代專家訓練
提出類別感知的專家訓練與策略整合框架,解決軟體工程代理在混合強化學習中的類別不平衡問題,提升整體解決率。為什麼重要
對開發複雜軟體工程代理(如 SWE-bench 類任務)的團隊有直接參考價值,特別是那些面臨不同任務類別性能波動的問題。最終 MOPD 策略在 Pro-618 上達到 58.04% 的解決率,比基礎模型提升 5.39 個百分點。

PydanticAI v2.47.0 發布
PydanticAI 發布 v2.47.0,主要改進 TypeSafeModel 對 None 路由及更多字段類型的支援,並修復了 UserPromptPart 內容驗證及 tuple 輸出字段處理的錯誤。為什麼重要
此版本提升了 PydanticAI 在處理複雜輸出結構時的穩定性與靈活性,適合使用 PydanticAI 構建 LLM 應用的開發者。關鍵變更包括允許 None 作為路由選項、支援 Choices 集合作為路由,以及更嚴格的輸入內容驗證以避免隱式錯誤。
AI App、部署與雲端18 條
Agent Substrate:Google 推出的 Agent 執行時基礎設施
Google 開源 Agent Substrate,一個專為自主 Agent 設計的沙箱執行時,支援高密度多工與快速恢復。為什麼重要
該專案旨在解決 Agent 應用在雲端大規模部署時的資源效率問題,透過將大量閒置的 Actor 映射到少量 Worker 上,實現 10 倍於標準容器的高密度。它支援 microVMs 和 gVisor,提供低於 500ms 的恢復操作,適合需要運行數百萬個沙箱的 AI 基礎設施團隊。
Univer:為 AI Agent 打造的辦公套件 SDK
Univer 是一個開源 Office SDK,讓 AI Agent 能在同一運行時中操作試算表、文件、簡報及關聯表格。為什麼重要
此工具允許開發者將辦公應用嵌入 SaaS 產品或 AI 應用中,支援在 Node.js 環境下無頭運行,方便 Agent 進行自動化處理。它提供統一的 Facade API,讓人類與 AI Agent 能協作編輯同一份文件,適合需要整合辦公自動化流程的 AI 產品團隊。
Google AX:聲明式 Agent 編排運行時
Google 發布 AX,一個基於 Kubernetes 的高吞吐量編排器,用於在叢集中運行數十億個自主 Agent 工作負載。為什麼重要
AX 提供 Task、Workspace、Gateway 和 Model 四個原語,讓開發者能以聲明式方式管理 Agent 的生命週期、網路隔離及模型配置。它建立在 Agent Substrate 之上,支援暫停與恢復 Agent 狀態,適合需要大規模部署和監控 Agent 集群的基礎設施工程師。
Treg:Agent 工具的 OpenRouter
Treg 是一個 Agent 工具註冊中心,讓 Agent 透過單一 API 端點調用 3,000 多個外部服務,無需個別註冊供應商帳號。為什麼重要
它解決了 Agent 調用付費 API(如 SEO、數據富集)時需要管理多個金鑰和訂閱的問題,提供按次計費的統一介面。開發者可以將自己的 CLI 或 API 金鑰註冊到 Treg,讓團隊內的 Agent 共享這些工具,適合需要整合多種第三方服務的 Agent 開發者。
video-use:使用編碼 Agent 編輯影片
video-use 是一個開源專案,讓 Claude Code 等編碼 Agent 透過對話指令自動完成影片剪輯、字幕生成及特效添加。為什麼重要
該工具利用 LLM 閱讀音訊轉錄和視覺描述來進行精確剪輯,支援自動去除填充詞、顏色分級及生成動畫疊加層。它將影片編輯流程轉化為 Agent 可執行的任務,適合希望利用 AI Agent 自動化內容生產流程的開發者與創作者。
Upscayl:免費開源 AI 圖片放大工具
Upscayl 是一款跨平台開源軟體,使用 Real-ESRGAN 模型和 Vulkan 架構進行 AI 圖片超解析度放大。為什麼重要
它允許使用者在本地 GPU 上運行 AI 模型來增強低解析度圖片,無需上傳至雲端服務,保護隱私且免費。適合需要批量處理圖片、提升畫質的設計師、開發者或一般使用者,特別是在 Linux、macOS 和 Windows 環境下。

Vercel Sandbox Drives 進入公開測試
Vercel 推出 Sandbox Drives,提供可跨沙箱實例重複使用的持久化儲存,用於保存 Agent 工作區或重用數據集。為什麼重要
此功能允許開發者將儲存掛載為目錄,並在多個沙箱之間共享讀取快照,解決了 Agent 狀態在沙箱停止後丟失的問題。它支援最大 16 TiB 的儲存空間,適合需要持久化 Agent 記憶體或共享大型模型/數據集的 AI 應用開發者。
Claude Opus 5.5 現已上線 Vercel AI Gateway
Anthropic 的 Claude Opus 5.5 模型現已透過 Vercel AI Gateway 提供,在 Agent 編碼和長任務上表現顯著提升。為什麼重要
該模型比 Opus 5 快約 30% 且成本低約 40%,並引入了自適應思考機制,廢除了強制工具調用。它支援 1M token 上下文窗口,適合需要處理複雜編碼任務和長對話的 AI 應用開發者,特別是在使用 Vercel AI SDK 的團隊中。

@ai-sdk/workflow-harness 1.0.121 發布
Vercel AI SDK 的 workflow-harness 套件更新至 1.0.121 版本,主要為依賴項的修補更新。為什麼重要
此更新屬於常規維護,同步了 @ai-sdk/harness 的依賴變更。使用 Vercel AI SDK 進行 Agent 工作流開發的團隊應保持關注,以確保依賴項的一致性。
@ai-sdk/workflow 2.0.42 發布
Vercel AI SDK 的 workflow 套件更新至 2.0.42 版本,主要為依賴項的修補更新。為什麼重要
此更新同步了 ai 核心庫的依賴變更。使用 Vercel AI SDK 構建 Agent 工作流的開發者應更新依賴以獲取最新修補。
@ai-sdk/vue 4.0.111 發布
Vercel AI SDK 的 Vue 整合套件更新至 4.0.111 版本,主要為依賴項的修補更新。為什麼重要
此更新同步了 ai 核心庫的依賴變更。在 Vue 前端應用中整合 AI 功能的開發者應更新依賴以確保相容性。

Cloudflare Worker Previews:Agent 開發的隔離預覽環境
Cloudflare 推出 Worker Previews,為每個 Git 分支提供生產級隔離環境,讓 Agent 能安全測試代碼變更。為什麼重要
此功能支援獨立配置、URL 和狀態隔離,讓 Agent 在合併前驗證行為,形成「Agent 開發生命週期」。它解決了 Agent 生成大量代碼時缺乏安全測試環境的問題,適合使用 Cloudflare Workers 部署 AI 應用的開發團隊。
使用 Strands Evals 與 Amazon Bedrock AgentCore 評估具備技能的 Agent
AWS 展示如何利用 Strands Evals 與 Bedrock AgentCore 評估具備特定「技能」的 AI Agent,以確保其遵循業務合規與工程規範。為什麼重要
傳統將所有規則寫入系統提示詞的方式難以維護,此方案採用模組化的 SKILL.md 檔案來定義領域特定任務(如合約遮蔽、發票核對)。這對於需要讓 Agent 嚴格遵守企業內部流程、合規檢查或特定工程慣例的開發者至關重要,提供了更靈活且可測試的 Agent 行為驗證機制。
Reactiv 利用 Amazon Bedrock AgentCore 將行動商務自動化速度提升 80%
行動商務平台 Reactiv 透過 Amazon Bedrock AgentCore 自動化 App 內容更新流程,將商家配置時間縮短 80%。為什麼重要
該案例展示了 AI Agent 在電商領域的實際應用,自動處理產品推薦、版面調整及素材生成等重複性任務。對於關注 AI 在垂直領域(如電商、零售)落地場景的團隊,此案例提供了從手動操作轉向自動化代理的具體效益數據與架構參考。
在 Amazon SageMaker AI 上利用並發掃描優化生成式 AI 端點
AWS 介紹如何使用並發掃描(Concurrency Sweeps)在 SageMaker AI 上最佳化生成式 AI 端點的實例規格與服務配置。為什麼重要
此方法旨在找到能最大化性價比且維持延遲在可接受範圍內的 GPU 配置,避免過度配置浪費預算或配置不足導致延遲飆升。對於負責 LLM 模型部署與成本控制的 MLOps 工程師,這提供了一套系統化的負載測試與資源調優策略,有助於降低雲端推理成本。
Trane 利用 Amazon Bedrock AgentCore 將建築洞察獲取速度提升 60 倍
Trane Technologies 基於 Amazon Bedrock AgentCore 建置 AI 代理解決方案,將 HVAC 設備診斷時間從 20 分鐘縮短至 20 秒。為什麼重要
該案例展示了 AI Agent 在處理複雜工業數據與跨系統查詢中的效率提升,解決了傳統多儀表板操作的高摩擦問題。對於致力於將 AI 應用於工業 IoT 或複雜業務流程自動化的團隊,此案例提供了從數週開發週期到顯著業務效益的具體參考。
Ollama v0.34.3 發布
Ollama 發布 v0.34.3,新增模型思考控制(thinking controls)API 支援,並支援 Apple Silicon 上的 Nemotron H 視覺模型。為什麼重要
此版本允許透過 CLI 或 API 查詢與設定模型的思考層級(如 low, high, max),方便開發者精確控制推理深度。同時修復了 macOS 應用重開視窗及 HuggingFace 模型拉取問題。對於在本地或邊緣設備部署 LLM 的開發者,此更新增強了對模型行為的可控性與硬體相容性。
llama.cpp b11115 發布
llama.cpp 發布 b11115,主要新增 OpenCL 的 A8 Q4_K 非 MoE dp4a 二進位 kernel 以優化計算效能。為什麼重要
此更新針對 OpenCL 後端進行了底層 kernel 優化,有助於在支援 OpenCL 的硬體(如 AMD GPU 或部分 CPU)上提升推理速度。對於關注本地推理效能、特別是使用非 NVIDIA 硬體或進行量化模型部署的開發者,此版本可能帶來顯著的執行效率改善。
中文與日文來源15 條
AWS 開源 Strands Harness,預組代理最佳化設定降低詞元成本達 28%
AWS 發布 Strands Harness,提供預先配置的 AI 代理執行框架,官方測試顯示其 Token 成本較 Claude Code 等框架低 28%。為什麼重要
該框架內建上下文管理機制,如自動截短過長工具結果與摘要早期內容,以控制 Token 用量。支援 Amazon Bedrock、Anthropic、OpenAI 等多個模型供應商,並可部署於 Linux 容器環境。適合需要構建低成本、高穩定性 AI Agent 的開發團隊,無需自行組合複雜的記憶與工具調用邏輯。

【AI 轉型實戰下篇】玉山銀行打造全行 AI 代理入口,首度揭露新一代 GENIE 關鍵 Agentic 技術框架
玉山銀行推出 GENIE 3.0,建立全行統一 AI 代理入口,透過 Root Agent 自動分派任務並整合標準化知識庫與 Skills 生態系。為什麼重要
該系統採用自訂 Agentic Framework,將業務 SOP 轉為標準化 Skill,並透過 MCP 協議調用內部 API。此架構允許不同團隊開發的 Agent 在統一安全護欄下協作,適合大型企業構建跨部門的 Agentic AI 應用,解決知識分散與工具調用不一致的問題。

Codex CLI 中 --add-dir 的境界外寫入用法:不需要 --approve-for-me
Codex CLI 0.154.0 中,使用 --approve-for-me 與 --sandbox 並用會導致報錯。若要允許任務寫入工作區外的目錄,應改用 --add-dir 單獨配合 --sandbox,無需 --approve-for-me 標誌。為什麼重要
這是針對 OpenAI 的 Codex 執行環境的工具使用指南。文章透過實測揭示了命令行參數的組合限制:--approve-for-me 與明確指定的 --sandbox 模式在 0.154.0 版本無法同時使用。對於希望讓 AI Agent 安全地寫入指定目錄的開發者而言,正確的做法是使用 --add-dir 搭配 --sandbox workspace-write,而非依賴自動審批標誌。文章包含完整的命令執行結果與 4 種測試情境的比較。

Jev 系開源實現「Laya」的日語支援測試:位置偏差導致順序尺度崩潰
日本語で Jev 的開源實現 Laya 進行了 300 件業務郵件的測試。多級選擇精度可用(0.747),但順序尺度(RPS 0.232)崩潰,原因是模型對首個選項偏見強(300 件中 0 次選中),這種位置偏差在 5 個條件下都能重現。為什麼重要
Jev 是一個不生成文本、直接輸出結構化判斷與校準概率的模型,適合分類任務。作者用 Qwen3 生成的日語郵件測試集進行了評估,包括多級選擇、打分(順序尺度)與真偽判定三類任務。發現日語版本中,順序尺度的最低等級選項從未被選中,無論選項順序如何調整、言語改述或增加等級數。溫度校準可改善概率校準(ECE),但精度無進展。代碼與評估集已開源,對於計畫以 Jev 做日語分類的團隊提供了實測基準。

本地 LLM 執行指南:LM Studio、Bionic、Unsloth 搭配 Qwen3.8 無審查版本
比較 LM Studio(已更名 Bionic)與 Unsloth Desktop 兩款本地 LLM 執行工具。Bionic 支援無審查版本的 Qwen3.8 27B,但在 Radeon GPU 的輕薄本上啟動失敗;Unsloth 則順利在同機器上運行 4B 輕量版本,並支援圖像、影片等多模態模型。為什麼重要
文章介紹了在消費級硬體上執行本地 LLM 的最新現狀。Bionic 是 LM Studio 的新名稱,具有代理功能與本地檔案編輯能力;Unsloth 則包含更廣泛的模型支援(MiniMax-H3、FLUX、SDXL 等)。實測顯示,即使無高端 GPU,輕量模型(3.46 GB)亦可實用運行,搭配網路搜尋功能可減少幻覺。對於想免費試驗各種開源模型的工程師而言,這兩個工具都值得評估,但 Unsloth 對低配裝置相容性更好。

BigQuery 的 AI.GENERATE_TABLE 函數:非結構化文本到結構化資料的轉換
BigQuery 的 AI.GENERATE_TABLE 函數可直接將文本轉換為預定義欄位的表格,無需 JSON 解析步驟。適用於從評論、客服詢問、表單自由文本等非結構化資料中自動提取結構化欄位。為什麼重要
相比 AI.GENERATE(輸出結構化 STRUCT),AI.GENERATE_TABLE 可直接產出表格列,簡化資料處理流程。文章展示了 CS 問詢一括結構化、GA4 表單資料結合等實務用例。透過 TABLE SCHEMA 定義欄位,並在 description 中指定選擇項與空值處理邏輯,確保輸出穩定。搭配 BigQuery 的 SQL 後處理,可直接進行 GROUP BY、WHERE 篩選,大幅提高 EC 與客服分析的自動化程度。

結合 Quint 與 Jev:以概率觀測驅動決定論式驗證的架構
提案將 TypeSafe AI 的 Jev(結構化判斷模型)與形式規格語言 Quint 相結合:Jev 用於從曖昧現實提取結構化觀測值,Quint 用於驗證狀態機轉遷不違反不變量,實現「可觀測的曖昧性」與「不可違反的制約」的分離。為什麼重要
這是針對自律型 Agent 治理的架構設計提案。Jev 處理非結構資料的概率分類(如「這份文件含機密資訊嗎?」),輸出離散的 Observation;Quint 則基於該 Observation 驗證狀態轉遷。以 Agent 權限管理為例,相比傳統 RBAC,能同時考量 Subject × Agent × Resource × Action × Destination 多維度,並用形式驗證確保不會進入禁止狀態。作者認為這種責務分離(觀測 vs. 統制)適用於 AI Agent 的運行時守護欄、複雜工作流程設計驗證等場景。

Claude Opus 5 的過度檢驗陷阱:顯式檢驗指示會反向作用
Claude Opus 5 無需人工督促也會自動檢驗,文章透過官方指南發現:在提示中加入「必須檢驗」的指示會導致二重檢驗,浪費 token 且結果無改進。應改為要求「檢驗後正確標記」而非「執行檢驗」。為什麼重要
作者對照 /insights 工具給出的改進建議與官方 Opus 5 指南,發現對舊模型有效的做法在新模型上失效。官方明確指出:顯式檢驗指示會觸發過度檢驗;委譲(delegation)用於大型獨立任務而非自檢;優先供完整規格再放手執行。相比於「毎回再実行して出力を貼れ」,正確做法應為「若無指令碼或執行日誌就不宜申告『已確認』」,將檢驗自動化轉向檢驗陳述的準確性。這對 Claude Code 使用者而言是重要的提示工程調整。

jev-reranker 的 92% 文件刪減在日語中受挫:閾值 0.2 過於激進
英語 NanoHotpotQA 中 jev-reranker 閾值 0.2 可達 92% 刪減率且無損失;但日語 NanoBEIR-ja 無損失上限降至 0.10,閾值 0.2 會遺漏 3 件正解。原因是日語翻譯後正解與非正解的分數都內縮,絕對值閾值失效。為什麼重要
作者重現了 jev-reranker 的官方結果(nDCG 0.9743、刪減率 92.48%),並將閾值振盪從 0 到 1。英語版 0.32 無損失、刪減率 95.2%;日語版因分數分佈潰陷,上限僅 0.10。實驗表明排序能力完整(AUROC en 0.9985 / ja 0.9906),只是絕對值偏移。提出實用解決方案:用「每個查詢最高分 × 0.2」而非固定閾值,可在日英 × 4 資料集上均達 90~100% 正解保留、58~91% 刪減。對使用 Jev 做檢索系統的團隊提供了語言差異的量化基準。

用 Jev 替換 Switchyard 分類器:102ms 判定,精度瓶頸在特徵合成
將 NVIDIA NeMo Switchyard 的 LLM 分類器替換為 Jev,判定速度從 1183ms(本地 1.7B 模型)提升至 102ms,但精度 67.5% 低於預期。關鍵發現:Switchyard 的「LLM 抽特徵 + Python 合成 tier」雙層設計反而降低精度。為什麼重要
作者直接改動 Switchyard 0.2.0 的判定呼叫,保持路由策略不變。Jev 精度 67.5%(vs. Haiku 56.4%、qwen3:1.7b 47.5%)。當直接問 Jev「應歸哪個 tier」精度達 75%,但改成從 9 個特徵欄位合成時反而跌至 67.5%。禍首是 reasoning_depth 欄位的定義文本不夠具體,改善描述後恢復到 72.5%。此外 Jev 的 choice 型態結構保證不會違反 enum 約束,比需要錯誤處理的 LLM 更可靠。對於用 Jev 做決策路由的團隊而言,應直接提問而非多層特徵合成。

為何 AI 宣稱搜尋卻未執行:工具呼叫日誌計數比自我申告更可靠
AI 被要求「調查並回答」時,常會宣稱已搜尋但實際未執行,因無權限而安靜失敗。解決方案:從 CLI 工具呼叫日誌中機械計數 search_web 呼叫次數,而非信任 AI 自述。為什麼重要
作者使用 Google Antigravity CLI(agy,呼叫 Gemini 的工具)驗證,發現預設配置下因無搜尋權限,詢問「最新版本是什麼」時返回舊資訊且毫無錯誤提示。改為計算 stream-json 輸出中 tool_name === "search_web" 的行數,0 次表示仰賴記憶、4 次表示確實搜尋。權限設定須同時調整 settings.json 與伺服器回應標頭(X-Robots-Tag),單層配置不足。對於在 CLI 自動化中內嵌 LLM 的工程師,此方法可用於驗證搜尋實際發生,增強對事實依據的信心。

AI 被引用的三層測量:點擊率相差 23 倍的真相
衡量「網站被 AI 引用」需分三層:伺服器日誌(爬蟲來訪 1,214 次)、Search Console(生成 AI 答案 204 次)、GA4(使用者點擊進站 9 次)。後兩者相差 23 倍,反映 AI 回答不引導點擊的特性,而非效果無效。為什麼重要
作者實測同一網站發現單層指標會誤導決策。爬蟲層的陷阱包括:假冒的漏洞掃描器(OAI-SearchBot 6 成是 404)、爬蟲目的分類(學習 vs. 索引 vs. 即時使用)。Search Console 層缺少搜尋詞軸。GA4 層因多數 AI 不傳 referrer,數字遠低於實際。此外 robots.txt 與 X-Robots-Tag 需同時配置,單層會失效。對於關心 AI 引流的產品經理,應按層分別監控,用數字差異說明業務影響,而非單一 KPI。

Spring AI 第 5 回:用 System/User 角色分離指示與提問
Spring AI 教學系列展示如何使用 .system() 與 .user() 方法分別傳送「應用程式指示」與「使用者提問」,取代混合在單一訊息中的做法。為什麼重要
前個單元混合了「口調指示」與「問題」在同一個 User 訊息;本回將提示分為 System 訊息(含 {tone} 參數的系統指示)與 User 訊息(純淨的用戶提問)。Spring AI 的 ChatClient 提供 .system(Consumer<SystemSpec>) 與 .user(Consumer<UserSpec>) 兩個 API,參數模式相同,均支援 .text() 與 .param() 進行模板填充。此舉令 LLM 能更清楚區分應用邏輯指令與使用者意圖,是提示工程的最佳實踐。代碼示例採用 Spring Boot 4.1.1 與 Spring AI 2.0.1。

Anthropic 調整 Claude 重置政策:週間使用額度可手動重置
Claude 的週間使用額度與 5 小時限制改為使用者可在期限內手動重置一次,取代原先不確定時間的自動伺服器重置。為什麼重要
過去 Claude 週間額度在伺服器更新時隨機重置(如週二),導致使用者無法精準規劃額度消耗。新政策允許在一定期間內主動重置,解決了「額度在自己還未用完時突然被覆蓋」的困境。手動重置的權利本身是否定期恢復(例如下週是否再次提供機會)目前未明確,但這項改善已大幅提升使用體驗。對於需要穩定存取 Claude API 的開發者與頻繁用戶應有實質幫助。

用ChatGPT寫長文時的「麵包屑」丟失問題
使用者分享用 ChatGPT 整理雜散的想法寫長文時,AI 過度整理導致思考過程中的細節資訊被刪除的經驗,並提出「收集階段盡量保留,編輯階段才整理」的解決方案。為什麼重要
這個案例對使用 ChatGPT 進行內容創作和知識整理的工作者很有參考價值。作者發現 AI 的摘要和整理功能在完成稿階段很有用,但在素材收集階段如果過早整理,會丟失思考過程中的重要細節——例如某個結論是如何透過多個事件累積而來的「路徑」。現在的做法是先用小文本區塊保存內容,後期才統合去重,避免「整理得太乾淨反而遺漏了思考脈絡」的問題。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。