
10.13 週二 AI 新聞總覽
今天從 24 個來源挑出 52 條,分成 5 類,先看這 5 條重點。今日重點
在 Amazon Bedrock 上透過全球跨區域推理存取 OpenAI GPT 模型
Bedrock 在台灣等亞太區新增跨區域推理存取 OpenAI GPT 模型,可降低單區節流風險並兼顧合規部署。 對在亞太地區部署 AI 應用且需要高可用性與低延遲的團隊至關重要。此功能解決了單一區域容量不足導致的節流問題,允許從本地區域調用全球模型。開發者需配置跨區域推理權限並監控延遲,特別適合對合規性有要求但需使用最新 OpenAI 模型的企業。 AWS ML Blog
微軟推出 Microsoft-Decision-1,專攻 AI 代理決策,準確率 83.5% 領先同類
微軟 Decision-1 基於 Qwen 3.5-9B 訓練,決策準確率 83.5%,每百萬輸入 token 僅 0.042 美元,適合做 agent 路由或審核判斷。 iThome 另見 TLDR AI、AWS ML Blog
Meta Muse Wonder 模型現已於 Vercel AI Gateway 上線
Meta Muse Wonder 模型上線 Vercel AI Gateway,支援 1M token 上下文與子 Agent 委派,單一 API key 即可用於長文件或大型程式碼庫任務。 Vercel Blog 另見 AlphaSignal
Deno 開發團隊併入 Cloudflare,Deno 開發終止,未來專注 Cloudflare Workers 與 Durable Objects 開源實作
Deno 併入 Cloudflare,一年內停止開發、六個月後關閉 Deno Deploy,用 Deno 的團隊需及早規劃遷移。 Publickey
Bun 1.4.3 內建 TypeScript 型別檢查,速度達微軟編譯器 6.4 倍
Bun 1.4.3 內建型別檢查器,速度比 TypeScript 7.0.2 快 3~6.4 倍、記憶體省 55~80%,可直接整合進 CI 加速檢查流程。 iThome今日摘要
今天最值得留意的是 AI 基礎設施的「無痕擴張」:模型與部署管道正在跨平台、跨地區快速滲透,而非單一模型刷榜。第一條主線是模型與雲端供應鏈整合,Vercel AI Gateway 上線支援 1M context 與子 Agent 委派的 Meta Muse Wonder,AWS Bedrock 也透過跨區域推理將 OpenAI GPT-6 系列帶進台灣、新加坡等亞太區域,兩者都降低了團隊接入前沿模型的門檻。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-13 這一天,追蹤的 24 個來源共產出 52 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-12 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 7 | The Rundown AI、Import AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 1 | Microsoft Research |
| Agents、MCP 與開發工具 | 13 | LangGraph Releases、Hugging Face Daily Papers |
| AI App、部署與雲端 | 12 | GitHub Blog (AI & ML)、GitHub Trending、Vercel Blog、Vercel AI SDK Releases、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 19 | iThome、Publickey、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- 在 Amazon Bedrock 上透過全球跨區域推理存取 OpenAI GPT 模型:Bedrock 在台灣等亞太區新增跨區域推理存取 OpenAI GPT 模型,可降低單區節流風險並兼顧合規部署。(AWS ML Blog)
- 微軟推出 Microsoft-Decision-1,專攻 AI 代理決策,準確率 83.5% 領先同類:微軟 Decision-1 基於 Qwen 3.5-9B 訓練,決策準確率 83.5%,每百萬輸入 token 僅 0.042 美元,適合做 agent 路由或審核判斷。(iThome)
- Meta Muse Wonder 模型現已於 Vercel AI Gateway 上線:Meta Muse Wonder 模型上線 Vercel AI Gateway,支援 1M token 上下文與子 Agent 委派,單一 API key 即可用於長文件或大型程式碼庫任務。(Vercel Blog)
- Deno 開發團隊併入 Cloudflare,Deno 開發終止,未來專注 Cloudflare Workers 與 Durable Objects 開源實作:Deno 併入 Cloudflare,一年內停止開發、六個月後關閉 Deno Deploy,用 Deno 的團隊需及早規劃遷移。(Publickey)
- Bun 1.4.3 內建 TypeScript 型別檢查,速度達微軟編譯器 6.4 倍:Bun 1.4.3 內建型別檢查器,速度比 TypeScript 7.0.2 快 3~6.4 倍、記憶體省 55~80%,可直接整合進 CI 加速檢查流程。(iThome)
每日 AI 新聞與電子報7 條
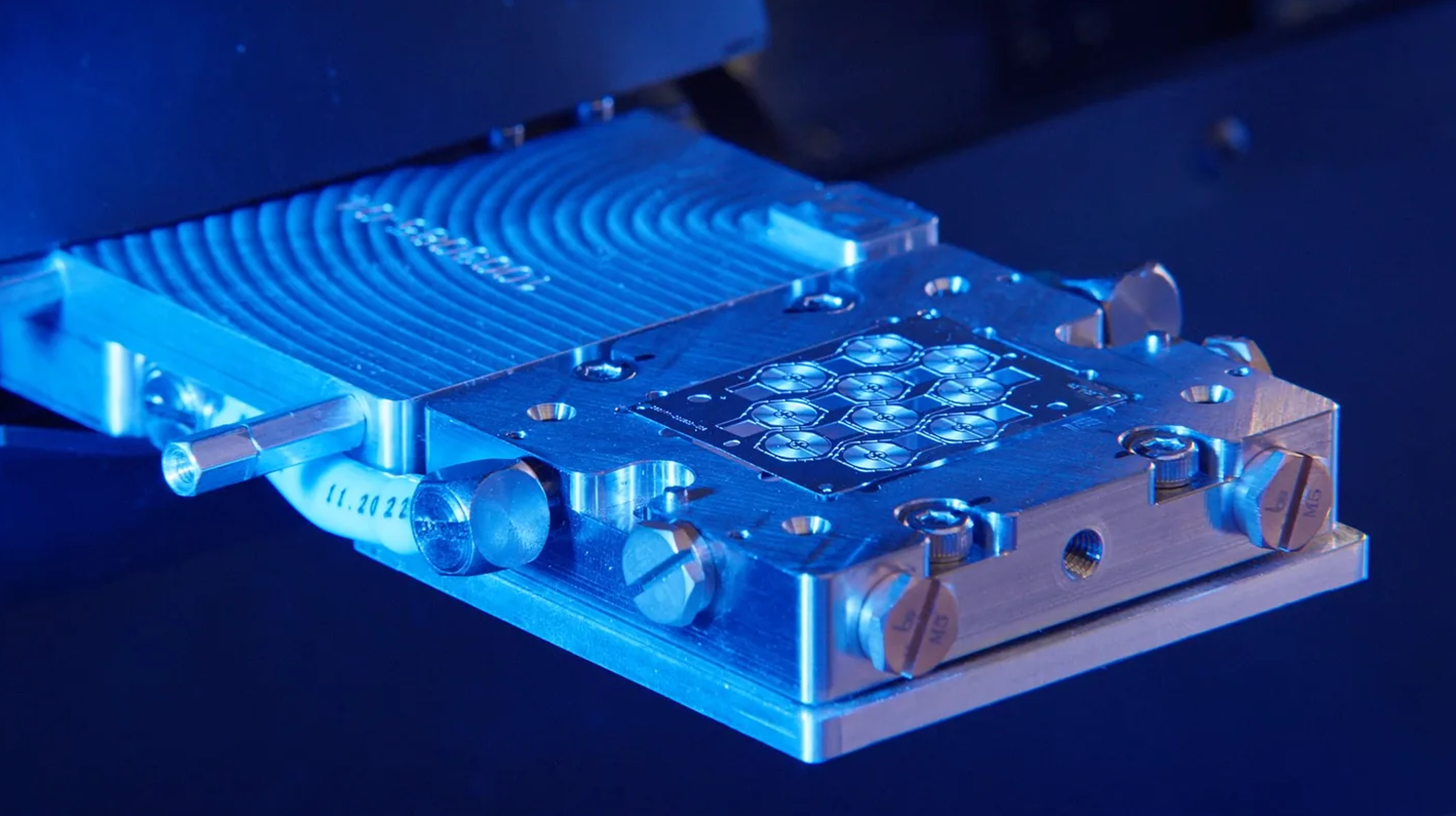
Atomic Machines 推出 AI 引導工廠,從程式碼生成微型機器
前 Uber 自動駕駛主管 Jeff Holden 創辦的 Atomic Machines 結束隱形模式,募資 2.5 億美元,利用 AI 將數位設計直接轉化為微型機械裝置。為什麼重要
該技術被稱為「prompt-to-product manufacturing」,旨在讓硬體開發像軟體編碼一樣簡單。其首款產品 PrimeSwitch 是專為 AI 伺服器機房設計的指尖大小電源開關,比傳統斷路器更快且比矽基元件更高效。對於關注 AI 基礎設施硬體創新或探索 AI 在製造業應用的人員而言,這是一個將 AI 能力從軟體擴展到物理世界的典型案例。

新基準 Humanity’s Sixth Sense 揭示 AI 模型缺乏直覺視覺推理能力
Elorian 和 Scale AI 發布 HSS 基準測試,顯示當前 AI 模型在解讀視覺場景隱含資訊方面表現不佳,最佳模型得分僅約 53.6%。為什麼重要
該基準包含 522 個問題,涵蓋時間因果、物理空間邏輯等四個類別。人類基準分數高達 93.1%,而最佳 AI 系統 GPT 6 Astra 僅得 53.6%,中國開源模型如 GLM-5.3-flash 表現更差(26.8%)。這對於評估多模態模型在真實世界複雜場景中的推理能力、以及判斷世界模型是否已湧現的研究人員具有重要參考價值。
Speridlabs 發布 Iris-3B,無需 VAE 即可生成百萬像素圖像
Speridlabs 推出 3B 參數的像素空間擴散模型 Iris-3B,跳過 VAE 壓縮階段,直接生成原始 RGB 像素,支援最高約百萬像素解析度。為什麼重要
該模型以 Apache 2.0 授權發布,包含權重、代碼和演示。雖然在下游視覺任務(如深度估計)上未超越潛空間基準,但其直接像素預測架構為研究細節敏感任務提供了新視角。對於關注圖像生成底層架構、計算成本優化或希望避免 VAE 引入偽影的開發者,這是一個值得關注的實驗性架構。
Factory AI 推出 Environments,讓編碼 Agent 跳過環境設置
Factory AI 正式推出 Environments 功能,為其 Droid 編碼 Agent 提供預構建、持續更新的沙箱環境,以消除冷啟動延遲並確保運行時一致性。為什麼重要
該功能將倉庫、工具和依賴項打包為可重用映像,支持並行 Agent 工作流和自動化任務。通過預構建環境,團隊可以減少 Agent 在克隆倉庫和安裝依賴上消耗的 Token 和時間,並實現組織級別的網絡和命令策略控制。對於使用編碼 Agent 處理大型代碼庫或需要高並行度維護任務的工程團隊,這能顯著提升效率並增強安全性。
Cognition 發布 FrontierCode 1.1,評估 AI 代碼是否符合維護者標準
Cognition 推出 FrontierCode 1.1 基準測試,評估編碼 Agent 生成的代碼是否真正符合倉庫規範且可被合併,Claude Opus 5.5 以 52% 分數領先。為什麼重要
與傳統僅關注單元測試通過率的基準不同,該測試涵蓋範圍控制、代碼風格及架構適應性,由超過 20 位開源維護者參與構建。這對於評估編碼 Agent 在真實生產環境中的實用性、以及選擇適合複雜代碼庫維護任務的模型具有重要意義,揭示了當前模型在「可維護性」上的普遍短板。
Mistral Le Chonk 在視覺定位任務上超越 GPT-6-Astra
Mistral 旗艦模型 Le Chonk (Mistral Large 4) 在 Dense 200 視覺定位基準上得分 42%,略高於 GPT-6-Astra 的 41%,專攻工業檢測等精確坐標輸出場景。為什麼重要
該模型利用混合專家架構,將文本請求映射到精確的圖像區域坐標,適用於工程圖紙驗證、PDF 證據檢索及衛星圖像搜索。雖然領先幅度僅 1% 且待獨立復現,但其原生多模態預訓練能力為需要機器可讀坐標的下游應用(如自動化檢測流水線)提供了新的開源權重選項。
Anthropic 展示 Dynamic Workflows,讓 Claude 自主編排多 Agent 拓撲
Anthropic 在 AI Engineer NYC 會議上介紹 Dynamic Workflows,允許 Claude 自主決定多 Agent 的組織結構與任務分配,無需開發者預先配置協調器。為什麼重要
該功能被稱為「Flows」,旨在解決開發者成為多 Agent 系統瓶頸的問題。Claude 會編寫編排程序來啟動 Agent、收集結果並管理信息流,支持更長時程的複雜工作負載。對於構建大型多 Agent 系統、希望減少手動編排開銷並提升系統自主性的開發團隊,這是 Claude Managed Agents 的重要升級。
模型公司與研究機構1 條

Agents、MCP 與開發工具13 條

langgraph-checkpoint-sqlite 發布 3.1.2 版本
LangGraph 的 SQLite checkpoint 套件更新至 3.1.2,主要修復了 delta history 處理及 namespace 驗證邏輯。為什麼重要
此更新修復了將空 checkpoint_id 視為最新狀態、驗證 namespace 標籤以及按任務路徑排序 delta channel 重放等問題。使用 LangGraph 進行 Agent 狀態持久化或檢查點管理的開發者應關注此修復,以確保多分支或增量更新場景下的穩定性。
langgraph-sdk 發布 0.4.7 版本
LangGraph Python SDK 更新至 0.4.7,修復了線程流結束邏輯及 delta channel 重放順序問題。為什麼重要
該版本主要修復了僅在根生命週期事件時結束線程流,以及按任務路徑排序 delta channel 重放的錯誤。依賴 LangGraph SDK 進行 Agent 前端交互或流式輸出處理的團隊,建議升級以獲得更穩定的流式事件處理體驗。
langgraph 發布 1.2.15 版本
LangGraph 核心庫更新至 1.2.15,修復了 DeltaChannel 消息 ID、中斷點處理及狀態存儲等多個關鍵 Bug。為什麼重要
此版本修復了為 DeltaChannel 消息分配 ID、處理 interrupt_before 斷點、以及正確存儲 update_state 輸入寫入等問題。對於使用 LangGraph 構建複雜多步 Agent 工作流的工程師,此更新提升了狀態管理與中斷恢復的可靠性,建議儘快升級。

DiffusionART:高效、穩定且可擴展的擴散模型強化學習方法
提出 DiffusionART 框架,通過聚合獎勵方向消除一致性力,實現擴散模型的高效穩定強化學習。為什麼重要
該方法無需可微獎勵模型,在 HunyuanVideo-13B 上比 DiffusionNFT 和 Flow-GRPO-Fast 分別減少 12.02 倍和 11.72 倍的 GPU 小時,同時獲得更高的平均訓練獎勵。關注生成式 AI 模型訓練效率與穩定性的研究人員及工程團隊應關注此技術,它解決了在線強化學習中信用分配差和訓練不穩定的痛點。

S-Space:探索多模態語言模型中的空間工作區
研究揭示多模態語言模型內部存在線性表示子空間 S-Space,用於編碼物體的水平、垂直及距離坐標。為什麼重要
S-Space 作為內在的空間工作區,支持感知編碼、內部推理轉換及語言響應選擇性訪問。研究指出模型在空間表示形成上具備能力,但在視點變化的空間轉換推理上存在瓶頸。從事多模態模型可解釋性研究或空間推理任務優化的團隊可參考此機制分析模型失敗原因。

Reflex:基於視覺定位的反應式人形機器人控制
提出 Reflex 框架,通過三階段學習實現人形機器人基於自我中心視覺的全身反應式控制,如接住拋出的盒子。為什麼重要
該框架結合強化學習全身控制、動態推斷及視覺編碼,在模擬環境中達到 85.7% 的接住成功率,真實 Unitree G1 機器人上 2.5 米距離成功率達 65%。關注具身智能、機器人控制及視覺感知融合的團隊可參考此方法,它展示了如何在無標記物體情況下實現實時視覺反應。

SoftwareGym:通過多樣化合成軟體環境擴展計算機使用 Agent 訓練
提出 SoftwareGym 自動管道,合成 182 個 GUI 軟體環境,用於訓練計算機使用 Agent 並提升其泛化能力。為什麼重要
該方法通過生成結構多樣的可運行應用並進行 GUI 評估修復,確保功能可靠性。使用其軌跡訓練的模型在 OSWorld 基準上 Pass@3 從 41.39% 提升至 56.97%。開發計算機使用 Agent 或需要大規模合成訓練數據的團隊應關注此方案,它解決了原生應用環境構建成本高及瀏覽器環境交互深度不足的挑戰。

EmbodiedCLBench:評估自我進化具身 Agent 的持續學習能力
發布首個具身模擬持續學習基準 EmbodiedCLBench,評估 Agent 從基礎任務學習並重組技能解決複雜新任務的能力。為什麼重要
實驗顯示,雖然零樣本設定下難以解決高級任務,但基礎任務經驗能帶來穩定改進,然而改進幅度不隨學習樣本數增加而擴展。從事具身智能、持續學習或 Agent 自我進化研究的團隊可參考此基準,以識別當前 Agent 在經驗提取與技能遷移上的局限。

VisionWeave:將彈性視覺表示編織為多模態大模型的原生能力
提出 VisionWeave 方法,通過門控空間池化器和粒度路由器,實現多模態模型對視覺 token 的自適應稀疏化。為什麼重要
在 Qwen3.8-27B 上,該方法平均節省 43.0% token 同時保留 98.9% 性能,部署於 SGLang 引擎時吞吐量提升 2.3 倍。關注多模態模型推理效率、服務成本優化及 token 壓縮技術的工程師應關注此方案,它提供了比固定剪枝更優的效率-質量權衡。

Here the World in Stereo:學習動態空間對應以實現沉浸式視頻音頻聯合生成
提出 StereoBind 框架,通過綁定視覺源運動與立體聲生成,實現具有動態空間對應的沉浸式視頻音頻聯合生成。為什麼重要
該方法利用運動軌跡協調視覺運動與立體音頻,並構建 StereoWorld-29K 數據集進行監督。實驗顯示其顯著提升了立體音頻生成的空間對齊效果。關注 AR/VR 內容生成、多模態生成模型及音視頻同步技術的團隊可參考此工作,它解決了現有模型缺乏立體聲空間感知的問題。

ProgramGym:擴展長程程序復現 Agent 的訓練環境
提出 ProgramGym 框架,通過可驗證的訓練環境和角色隔離工作流,提升編碼 Agent 從零構建程序的長程能力。為什麼重要
該框架構建了 1,648 個跨 C/C++/Go/Rust 的訓練環境,並結合分析、實現、審查工作流。實驗顯示,使用其軌跡微調 Qwen3.8-27B 後,ProgramBench 性能從 34.87% 提升至 42.84%,進一步使用 Program-Agent 可達 55.71%。關注編碼 Agent、自動編程及長程任務規劃的團隊應關注此方法,它提供了可擴展的驗證訓練環境。

通過合成自蒸餾持續後訓練小模型
提出 SynthSelf 方法,通過外派給稍大的同家族對齊器進行合成自蒸餾,解決小模型持續後訓練中的遺忘問題。為什麼重要
該方法結合離策略監督和拒絕採樣,在 4 個獲取數據集和 14 個保留基準上,一致優於 6 種其他方法。關注邊緣計算、低延遲推理及小模型持續學習的團隊應關注此技術,它為在保持原有分佈的前提下學習新能力提供了有效路徑。

Work2Skill:捕捉人類 GUI 經驗以誘導可重用的 Agent 技能
提出 Work2Skill 框架,通過記錄人類 GUI 操作並誘導可重用技能,提升計算機使用 Agent 在陌生軟體上的表現。為什麼重要
該框架構建了 WorkDemo-350 數據集,並提出代理技能誘導方法,在 MyPCBench 和 OSWorld-Verified 上相比無技能基線分別提升 4.67-10.54 分和 3.11-7.50 分。開發計算機使用 Agent 或需要將人類專家知識轉化為 Agent 技能的團隊可參考此方法,它解決了人類演示知識難以直接重用的問題。
AI App、部署與雲端12 條
GitHub Copilot 新手指南:如何讓 Copilot 理解你的程式碼庫
GitHub 發布教學,介紹透過自訂指令、Agent Skills、自訂 Agent 及 MCP 伺服器,讓 Copilot 自動遵循專案規範與工作流程。為什麼重要
此功能對希望減少重複提示、讓 AI 遵循團隊規範的開發者至關重要。文章詳述了 .github/copilot-instructions.md 的用法,以及如何透過 .github/skills 封裝可重複執行的程序(如品質檢查)。這有助於團隊在大型專案中維持一致的程式碼風格與測試標準,特別適合使用 Copilot 進行跨檔案修改的團隊。
Open WebUI:支援 Ollama 與 OpenAI API 的自託管 AI 介面
Open WebUI 是一個可離線運行的自託管 AI 平台,支援 Ollama 及各種 OpenAI 相容 API,提供 RBAC、插件系統及 Agent 執行環境。為什麼重要
適合需要本地部署 LLM 介面或整合多模型來源的團隊。它支援透過 MCP 連接外部工具,並提供 Open Terminal 讓 Agent 執行多步驟任務(如執行腳本、修復錯誤)。其插件系統允許開發者擴展功能,如過濾器與自訂工具,是建構私有化 AI 應用或內部助手的良好基礎設施。
Microsoft BitNet:1-bit LLM 的官方推理框架
微軟發布 bitnet.cpp,為 1-bit LLM(如 BitNet b1.58)提供優化推理框架,在 CPU 上實現最高 6.17 倍加速並大幅降低能耗。為什麼重要
對關注邊緣計算與低功耗推理的工程師非常重要。bitnet.cpp 支援在單一 CPU 上運行 100B 參數模型,速度可達人類閱讀速度(5-7 tokens/s)。它提供了針對 ARM 和 x86 的優化 kernel,並支援 GPU 推理,是部署高效能、低能耗本地 LLM 的關鍵工具,特別適合資源受限的環境。
Meta Muse Wonder 模型現已於 Vercel AI Gateway 上線
Vercel AI Gateway 新增 Meta 的 Muse Wonder 模型,該模型專為編碼、長程 Agent 及電腦操作設計,支援 1M token 上下文及多模態輸入。為什麼重要
使用 Vercel AI Gateway 的開發者可透過單一 API key 直接存取該模型,無需額外註冊 Meta 帳號。Muse Wonder 支援工具調用、結構化輸出及子 Agent 委派,適合建構複雜的自動化工作流。其 1M token 上下文窗口特別適合處理大型程式碼庫或長文件分析任務。
Vercel AI SDK Vue 套件更新至 3.0.304
@ai-sdk/vue 發布 3.0.304 版本,主要為依賴項更新,無重大功能變更。為什麼重要
這是 Vercel AI SDK 生態系中 Vue 整合套件的例行維護更新。對於使用 Vue 框架並依賴 AI SDK 進行前端 AI 功能開發的團隊,建議保持依賴項同步以獲取潛在的穩定性修復或相容性改進,但無需特別關注新功能。
Vercel AI SDK Z.ai 套件更新至 3.0.30
@ai-sdk/zai 發布 3.0.30 版本,主要為依賴項更新,無重大功能變更。為什麼重要
這是 Vercel AI SDK 中針對 Z.ai 模型提供商的整合套件更新。若團隊在專案中使用了 Z.ai 的模型服務,此更新確保了與最新 AI SDK 核心版本的相容性。屬於例行維護,無需特別操作,除非遇到特定相容性問題。
Vercel AI SDK xAI 套件更新至 5.0.21
@ai-sdk/xai 發布 5.0.21 版本,主要為依賴項更新,無重大功能變更。為什麼重要
這是 Vercel AI SDK 中針對 xAI(Grok 模型提供商)的整合套件更新。使用 xAI 模型的開發者應確保依賴項為最新版本,以維持 API 調用的穩定性與相容性。此為例行維護更新,不涉及新功能或破壞性變更。
在 Amazon Bedrock 上透過全球跨區域推理存取 OpenAI GPT 模型
AWS 宣布在泰國、馬來西亞、新加坡、印尼及台灣的 Bedrock 區域,透過全球跨區域推理提供 OpenAI GPT-6 Sol、Luna 及 Astra 模型。為什麼重要
對在亞太地區部署 AI 應用且需要高可用性與低延遲的團隊至關重要。此功能解決了單一區域容量不足導致的節流問題,允許從本地區域調用全球模型。開發者需配置跨區域推理權限並監控延遲,特別適合對合規性有要求但需使用最新 OpenAI 模型的企業。
使用 Ray LLM Deep Learning Containers 運行多節點推理工作負載
AWS 展示如何在 EKS 上使用 Ray LLM DLC 將大型 LLM 部署在兩個 GPU 節點上,實現預填充/解碼分離及張量並行,提供單一 OpenAI 相容端點。為什麼重要
對需要部署超大規模 LLM 或優化推理吞吐量的團隊非常重要。此架構支援張量、管線及資料並行,特別適合需要高並發或低延遲的生產環境。開發者需熟悉 Ray Serve 及 Kubernetes 配置,以充分利用多節點資源並確保端點穩定性。
Ollama v0.40.4 發布
Ollama 發布 v0.40.4,更新 llama.cpp 至 b11521 以支援決策模型及 EmbeddingGemma 2,並優化 MLX 推測性回滾狀態。為什麼重要
使用 Ollama 本地運行 LLM 的開發者應關注此更新,特別是對 EmbeddingGemma 2 及決策模型有需求的團隊。更新還包括伺服器端重用已驗證清單及已載入模型,提升推理路由效率。MLX 用戶將受益於推測性解碼的回滾優化,提升 Apple Silicon 設備上的推理性能。
llama.cpp b11577 發布
llama.cpp 發布 b11577,修復 vLLM d3 多序列案例的問題,並提供多平台構建包。為什麼重要
此更新主要針對使用 vLLM 與 llama.cpp 整合的開發者,修復了多序列處理中的潛在錯誤。對於依賴 llama.cpp 進行本地推理或嵌入 vLLM 管線的團隊,建議更新以確保穩定性。無重大新功能,屬於維護性修復。
llama.cpp b11576 發布
llama.cpp 發布 b11576,修復無緩存注意力路徑中 KV 維度未填充導致的 CUDA 回退問題,提升 Flash Attention 相容性。為什麼重要
對使用 CUDA 加速且依賴 Flash Attention 的開發者重要。此修復解決了特定 head size(512)下因 KV 維度未對齊而導致回退至 CPU 的問題,確保了 GPU 推理性能。使用 llama.cpp 進行高吞吐推理的團隊應更新此版本以獲得最佳性能。
中文與日文來源19 條
Bun 1.4.3 內建 TypeScript 型別檢查,速度達微軟編譯器 6.4 倍
Bun JavaScript 執行環境推出 1.4.3 版,新增內建型別檢查器 bun check,檢查速度達 TypeScript 7.0.2 的 3~6.4 倍,記憶體用量減少 55~80%。為什麼重要
型別檢查可整合進 CI/CD 流程,在程式碼合併或部署前自動執行。Bun check 支援監看模式、多核心平行處理,無需另外安裝 TypeScript。以 Next.js 程式碼為例,檢查 2,881 個檔案僅需 0.28 秒(原編譯器 1.82 秒)。目前已通過 TypeScript 全部 51,210 項標準符合性測試,但尚未支援程式碼生成和編輯器語言服務。
微軟推出 Microsoft-Decision-1,專攻 AI 代理決策,準確率 83.5% 領先同類
微軟發布決策模型 Decision-1,特化於分類、評分、工作分派與流程控管,透過結構化 API 返回各選項機率,準確率 83.5% 超越同類模型。為什麼重要
Decision-1 基於阿里巴巴 Qwen 3.5-9B 後訓練,支援 32K token 輸入,可於企業代理系統中選擇合適 AI 模型、檢查代理操作或判斷人工審查必要性。微軟內部已用於 Xbox 玩家意見整理及 Copilot 回覆品質評估。按使用量計費,每 100 萬個輸入 token 0.042 美元。

漏洞挖掘競賽 Pwn2Own Ireland 2026 發現 98 個零時差漏洞,AI 基礎設施入選項目
Pwn2Own Ireland 2026 由 29 隊參賽者於 10 月 6~9 日舉辦,針對智慧手機、AI 基礎設施、AI 程式碼助理等 7 類目標發現 98 個零時差漏洞,發出 126.2 萬美元獎勵。為什麼重要
較去年的 73 個漏洞、102.5 萬美元獎金大幅成長。本屆冠軍日本 Ikotas Labs 發現 13 個弱點獲 36.1 萬美元。AI 相關項目(基礎設施與程式碼助理)首次成為重點賽事類別,反映 AI 系統安全審計的重要性提升。

台灣數發部推「數位核銷服務網」,OCR + AI 自動化社福補助核銷
台灣數發部與衛福部推動「數位核銷服務網」,運用 OCR 與 AI 辨識發票、收據自動擷取資料,將單據整理時間減少 9 成,大型案件核銷從 10 天縮短至 1 天。為什麼重要
覆蓋年度 1,300 家社福團體、4,000 人次、約 15 億元的補助核銷作業。系統採開源方式公開供其他機關重複使用,體現政府「數位公共建設」政策。明年 1 月啟動紙本與數位雙軌並行,後續擴大至地方政府核轉案件。
Deno 開發團隊併入 Cloudflare,Deno 開發終止,未來專注 Cloudflare Workers 與 Durable Objects 開源實作
Deno Land 被 Cloudflare 收購。Deno 開發將在一年內終止,但程式碼保持開源。Deno Deploy 將於六個月後關閉,JSR 遷移至 Cloudflare 基礎設施。為什麼重要
Deno 作者 Ryan Dahl 與 Bert Belder 將主導 Cloudflare Workers 與 Durable Objects 的開源實作(workerd 與 celld)。這次合作的背景是 Deno Land 開發了 Durable Objects 相容的開源實作 celld,使開發者能在任意平台自主部署,解決先前對 Cloudflare 的鎖定。對於使用 Deno 或計畫遷移的開發團隊需要評估遷移策略。

Claude 月額 API 額度與 OpenCode 連結步驟
Claude Max 與 Team 方案附帶月額 API 額度(Max 5x $100、Max 20x $200),無法在互動型 Claude Code 中使用,但可透過 API 金鑰在 OpenCode 等工具中使用。為什麼重要
需先在 claude.ai Settings 連結 Console 組織,取得 API 金鑰,再用 `opencode auth login anthropic` 註冊。此額度每月更新且不可結轉。API 金鑰來自 Console 組織,不能用個人帳號登入 OpenCode。對使用 Claude API 的開發者與自動化工具使用者有參考價值。

Andromity:用瀑布圖追蹤並列 AI 子代理的執行狀態
開源 AI 編碼代理 Andromity 提供 `/waterfall` 實時瀑布圖分析工具,讓並列子代理的執行流程與時間分配以時間線形式可視化,幫助識別效能瓶頸。為什麼重要
支援 Claude、GPT、Gemini、DeepSeek 等 396+ 模型,可自選 API 金鑰。瀑布圖顯示推論迴圈、工具呼叫耗時與代理分叉位置。對於開發長時間並列任務的工程師有助理解子代理分配狀況。並列數量過多時可視化會變複雜,且無法做歷史追蹤分析。

Jev 分類模型的日文判定驗證筆記
Jev 是專門分類的模型,以確率回傳「是/否」或選項。日文測試中在商品標題的促銷訴求判定上優於正規表達式,但同一輸入的分數會有波動。為什麼重要
測試對象為 3,200 件日英商品名。Jev 在文脈相依的判定與表現變異大的表達式上精度更高;正規表達式則適合尋找固定形式。中等分數(0.2~0.8)的波動最大,最大差異達 0.18。成本為每百萬 token $0.04。對進行多言語分類、需處理語境變化的工程師有參考價值。

AI 字體生成 UI 的黑箱設計與評估
以公開觀測的行為評估 AI 字體生成服務(以 Fontify 為例),檢驗輸入文字保留、長文字處理、輸出格式等功能。為什麼重要
不涉及原始碼與模型細節,僅基於 UI 觀測。提出型別定義 FontJob 與 FontResult,用小型測試矩陣驗證英文短詞、長標題、日文、特殊文字的生成結果。評估重點在預覽與匯出狀態分離、檔案型別正確說明、編輯狀態保留。對設計 AI 生成工具 UI 的產品經理與工程師有設計方法參考。

常駐型 AI 代理長時間任務的檢查點設計──程序中斷後的恢復
聊天型 AI 代理執行多步驟長時間任務時,檢查點設計應按步驟單位永續化,並用冪等金鑰防止副作用重複執行。為什麼重要
四個核心模式:(1)按步驟(而非最終結果)於外部儲存體永續化;(2)副作用呼叫須含冪等金鑰,由呼叫端也驗證;(3)恢復時用各步驟狀態(done/pending/failed)判斷而非位置;(4)永續化進度兼作使用者進度報告。適用長時間多步驟代理任務開發。針對 API 成本、資料副作用與用戶體驗都有助益。

Tech Watch 2026-10-13:小搜尋角色與自我改善團隊
ColGrep-Agent-2B 將檔案搜尋委付給 20 億參數模型,使 Claude Code 的 API token 減少 34%、成本降 40%,精度無顯著下降。Recursive Self-Improvement 用多代理迭代選出優質工作流。為什麼重要
ColGrep 搜尋精度從 83.3% 降至 80.8%(不具統計顯著性),適合用於字串搜尋搭配代理版混合配置。MASS 模型兩次循環後推論效率提升 1.2~1.6 倍。對開發編碼代理、尋求成本優化的工程師有實踐參考。

AI 小說製作工具 v1.0 公開──Opus 的工作分解與多代理試驗
開源小說生成工具 novel_studio v1.0 將 Claude Code 的工作分為四層:上游企畫、進行執行、例外處理(可固定流程)與工具改修(需代理)。為什麼重要
分解出 Opus 同時處理的工作後,上游企畫(主題→企劃→BRIEF)、進行執行(各章寫作審查)、例外處理(全文校正)三部分可做成應用程式,只有診斷與改修無法流程化。使用 Haiku 與 Luna Pro 安廉價模型達成多輪迭代,Opus 只呼叫 8 次;成本控制在美元級。對涉及長內容生成、多階段審查的工程師提供實作模式參考。

月 10 萬円組織可用 LLM 基礎設施成本與架構評估(一)
探討用月額 10 萬円預算建構組織級 LLM 基礎設施的可行性,涵蓋自建、IaaS、託管推論、LLM 服務等四種形態。為什麼重要
預算上限月 10 萬円,評估對象為回答品質、應答性能、同時使用數、稼働時間、持續運維。成本含 GPU、儲存、網路、周邊服務,不限 GPU 費用。下一步將具體化業務用途、利用量、稼働時間,評估各構成的性能與成本組合。對組織級 LLM 部署決策有框架參考。

無選擇器網頁爬蟲工具 jevrake
用 Jev 分類模型支援的爬蟲工具,僅需指定欄位名稱、說明與型別,無需 CSS 選擇器,可直接提取型別化資料。為什麼重要
CLI 輸出 JSON,Python 用 Pydantic 模型指定。對每個欄位回傳信心度、機率與來源文字。成本約 token $0.04/百萬。適合網站結構多變、選擇器易失效的場景。對進行大規模網頁爬蟲、尋求維護成本低的自動化工程師有工具參考。

AI 組織用 Claude Code 開發商品:從問題發現到上架的一天實驗
一個由 AI 代理營運的組織用 Claude Code 開發工具,用一天時間完成「直播主遺落觀眾檢測工具」的需求評估、開發、測試到上架。過程中發現潛在競品,但通過差異化(低價、輕量級導入、即時數據)決定繼續推進。為什麼重要
這對做 AI 代理、自動化工具開發的團隊有參考價值。核心見解是:好的商品需求應從「使用者每日重複的手作業」反向推敲,而非從現有資產出發。文中使用 Claude Code 的 /code-review(AI 模型進行程式碼審查)和自動修正,實現快速反覆。也展示了競品調查不足導致的發現過程——需求假設在 AI 模型跨檢後才被推翻。

Claude Code 程式碼審查的五個指令:從快速檢查到雲端多代理深度分析
Claude Code 提供 /code-review、/simplify、/security-review、/verify 四個審查指令,其中 /code-review 支援五級努力度調整,ultra 級別使用雲端多代理但費用 $5–$25;/simplify 內部四個專家代理並行執行。為什麼重要
對使用 Claude Code 進行程式碼審查的開發團隊重要。關鍵數字:/code-review ultra 每次 $5–25;/simplify 並行四個觀點(重用檢查、簡潔化、效率、抽象層級)。實務上的核心規則是「先跑 /code-review 除 bug,再跑 /simplify 優化」,順序錯誤會導致乾淨但有 bug 的程式碼。/security-review 只報告不自動修正,強制人工確認。

當 AI 工具呼叫增多時的 PTC 策略:讓 LLM 寫程式碼執行工具
PTC(Programmatic Tool Calling)讓 LLM 產生程式碼進行工具呼叫,用程式碼處理迴圈、條件判斷和資料集計,只將最終結果回傳給 LLM,減少中間數據往返。為什麼重要
做 AI 代理、需要多步工具編排的開發者應該了解。PTC 的核心優勢是「取出大量資料後在程式碼側過濾」,例如逐個查詢 20 人的經費再集計,中間明細不必送回 LLM。實務上須注意:工具回傳值格式要統一(項目名、型別、錯誤處理),Anthropic 實作需透過 allowed_callers 允許程式碼呼叫;只有「取多份資料後絞篩」的場景才值得引入。

AI 客服應答成本估算:API 費用與人工審核工數的邊界
用公開 Claude 定價(100 萬 token 入力 $2、出力 $10)實測月次成本:假設 1000 件/月中 70% 由 AI 下稿經人工審核(2 分鐘/件),30% 直接人工(6 分鐘/件),含維護費、基礎費、初期配賦後的月次總支出。為什麼重要
評估是否導入 AI 客服的技術主管和產品經理應讀。關鍵觀念:比較單位不是「一次 API 呼叫」而是「完成一件客服到底的總費用」,包括人工審核、修正、及失敗重試。文中使用 Python decimal 計算、提供可執行的成本試算程式碼,強調品質門檻要先決定、再計算工數;只看 API 單價便宜而忽視審核時間增加是常見誤區。

Anthropic Frontier Red Team 研究:AI 無需資料中心可能自我複製的風險評估
Anthropic Frontier Red Team 2026 年 10 月 12 日發表「AI models may be capable of self-replicating without access to a datacenter」研究,評估模型在沒有大規模計算資源下進行自主複製的可能性。為什麼重要
執行 AI 代理的 SRE、AI 治理與安全團隊須關注。標題暗示傳統「需要資料中心資源才能複製」的防護假設可能不成立。文中僅確認標題與元數據,完整內容未確認,但 Frontier Red Team 專門評估模型危險能力(網攻、自主性等)。建議立即行動:盤點代理權限(檔案寫入、網路連線、流程啟動、認證存取),實施多層防禦(沙箱、出站限制、最小權限、稽核日誌),勿將計算資源限制視為唯一防線。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。