
10.17 週六 AI 新聞總覽
今天從 24 個來源挑出 49 條,分成 5 類,先看這 5 條重點。今日重點

Reflection 發布 501B 參數開放模型 Beam
Reflection推出501B參數、23B活躍參數的Beam模型,支援1M上下文、Apache 2.0授權,可自建編碼Agent基礎設施。 Beam 是首個由美國實驗室 Reflection 發布的開放前沿模型,擁有 23B 活躍參數,適合在自有基礎設施上部署。其原生支持 vLLM、SGLang 及 Rust 推理框架,並提供 SFT 與 RL 訓練配方,對希望自託管高性能編碼 Agent 的團隊具有重要價值。 Hugging Face Blog 另見 Vercel Blog、AWS ML Blog、Ollama Blog、llama.cpp Releases
PydanticAI v2.57.0 發布
PydanticAI v2.57.0新增Harness ApprovalReviewer,可讓模型在人類介入前自動審批低風險工具調用,降低Agent誤操作風險。 PydanticAI Releases
Vercel Shop 正式發布:讓 AI Agent 成為 Shopify 商店的一級消費者
Vercel Shop用Universal Commerce Protocol把產品頁轉成Agent可讀結構,電商團隊可直接讓AI購物助手搜尋、加購、結帳。 Vercel Blog
TypeSafe 擴充 Jev 決策模型,支援圖片判斷與物件定位
TypeSafe決策模型Jev 1.14新增圖片物件定位與26.2萬詞元長上下文,但官方提醒影像判斷尚未達生產可靠度,部署前需自行驗證。 iThome 另見 Qiita (LLM)
Ubuntu 26.10 全面採用 Rust 核心工具,強化後量子密碼與企業登入
Ubuntu 26.10全面改用Rust版coreutils與Sequoia PGP驗證更新,維運團隊需先測試既有備份、部署腳本相容性再升級。 iThome今日摘要
Reflection 開源的 Beam(501B MoE、23B 活躍參數、1M 上下文、Apache 2.0)是今天最值得關注的事:這是首個由美國實驗室發出的開放前沿模型,原生支援 vLLM、SGLang,專攻編碼與 Agent 場景,給想自託管高性能編碼 Agent 的團隊多了一個不受供應商綁定的選項。圍繞 Agent 工具鏈這條主線也很熱鬧:Cursor 雲端 Agent 啟動加速 5 倍並支援 500 個 Repo,PydanticAI v2.57 加入工具調用審批機制,Perplexity 開源 Firecracker 沙箱 SPACE,顯示大家都在補齊 Agent 從開發到生產的最後一哩路。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-17 這一天,追蹤的 24 個來源共產出 49 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-16 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 7 | TLDR AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 3 | OpenAI News、Google Cloud AI / ML Blog |
| Agents、MCP 與開發工具 | 14 | LangGraph Releases、Hugging Face Blog、Hugging Face Daily Papers、PydanticAI Releases |
| AI App、部署與雲端 | 9 | GitHub Trending、Vercel Blog、Vercel AI SDK Releases、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 16 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- Reflection 發布 501B 參數開放模型 Beam:Reflection推出501B參數、23B活躍參數的Beam模型,支援1M上下文、Apache 2.0授權,可自建編碼Agent基礎設施。(Hugging Face Blog)
- PydanticAI v2.57.0 發布:PydanticAI v2.57.0新增Harness ApprovalReviewer,可讓模型在人類介入前自動審批低風險工具調用,降低Agent誤操作風險。(PydanticAI Releases)
- Vercel Shop 正式發布:讓 AI Agent 成為 Shopify 商店的一級消費者:Vercel Shop用Universal Commerce Protocol把產品頁轉成Agent可讀結構,電商團隊可直接讓AI購物助手搜尋、加購、結帳。(Vercel Blog)
- TypeSafe 擴充 Jev 決策模型,支援圖片判斷與物件定位:TypeSafe決策模型Jev 1.14新增圖片物件定位與26.2萬詞元長上下文,但官方提醒影像判斷尚未達生產可靠度,部署前需自行驗證。(iThome)
- Ubuntu 26.10 全面採用 Rust 核心工具,強化後量子密碼與企業登入:Ubuntu 26.10全面改用Rust版coreutils與Sequoia PGP驗證更新,維運團隊需先測試既有備份、部署腳本相容性再升級。(iThome)
每日 AI 新聞與電子報7 條
神經網路已足夠乾淨、梯度即協方差、Agent RL 的回合問題
Goodfire 提出神經網路多義性多為遞迴泛化而非疊加,可直接研究;另探討 RL 梯度性質與 Agent 後訓練複雜度。為什麼重要
對做可解釋性(Interpretability)與對齊(Alignment)的研究者極具價值,挑戰了傳統認為網路權重糾纏需先解纏的觀點。文章指出 Qwen-32B 中 90% 神經元功能單一,且 RL 梯度可視為協方差,有助於理解 Agent 在長程任務中的離策略(off-policy)問題。
Cursor 雲端 Agent 支援 500 個 Repo 且啟動速度提升 5 倍
Cursor 更新雲端 Agent,新增可分享互動儀表板、Environments API,並支援跨 500 個 Repo 的環境,啟動速度提升 5 倍。為什麼重要
對使用 Cursor 進行自動化開發或 CI/CD 集成的團隊重要。Environments API 允許透過程式碼管理 Agent 執行環境,適合需要標準化 Agent 設定、審計或從 Webhook 觸發任務的場景。
xAI Grok Bot 任務速度提升 3 倍並開放第三方 Connector
Grok Bot 更新後電腦操作任務速度提升 3 倍,新增 X 觸發、Email 路由及 Robinhood、eToro 等金融 Connector。為什麼重要
對開發 Agent 應用或關注 MCP 生態的開發者重要。開放第三方 Connector 提交意味著更多服務可透過 MCP 標準接入 Grok Bot,但金融類 Connector 涉及高權限操作,需注意安全審計。
Pika 將完整創意工作室嵌入 ChatGPT
Pika 推出 ChatGPT 插件,讓用戶在對話側邊欄直接生成與編輯圖像、影片及音訊,資產同步至 Pika 庫。為什麼重要
對使用 OpenAI Plugin Extensions 的開發者具有參考價值,展示了如何利用 MCP 與 UI SDK 在 ChatGPT 內構建互動式應用。此舉也顯示 AI 助手正成為創意工具的新分發渠道。
Perplexity 開源 SPACE:基於 Firecracker 的 Agent 代碼沙箱
Perplexity 開源 SPACE,一個基於 Rust 和 Firecracker microVM 的平台,用於安全執行不受信任的 Agent 代碼。為什麼重要
對需要自託管代碼執行環境的團隊重要,可作為 E2B 或 Modal 的替代方案。SPACE 提供 HTTP 和 SSE 接口,支持沙箱、生命週期操作及命令流的獨立管理,適合長時 Agent 會話。
Anthropic Claude Mythos 5 將量子電路門數減少 17 倍
Anthropic 報告 Claude Mythos 5 在 8 項量子電路基準測試中優於已發表設計,部分任務資源需求降低超 10 倍。為什麼重要
對量子計算研究者及關注 LLM 在科學發現中作用的團隊重要。該研究展示了 LLM 透過「生成-評估-修訂」循環優化複雜約束問題的能力,特別是在橢圓曲線點加法等關鍵操作上。
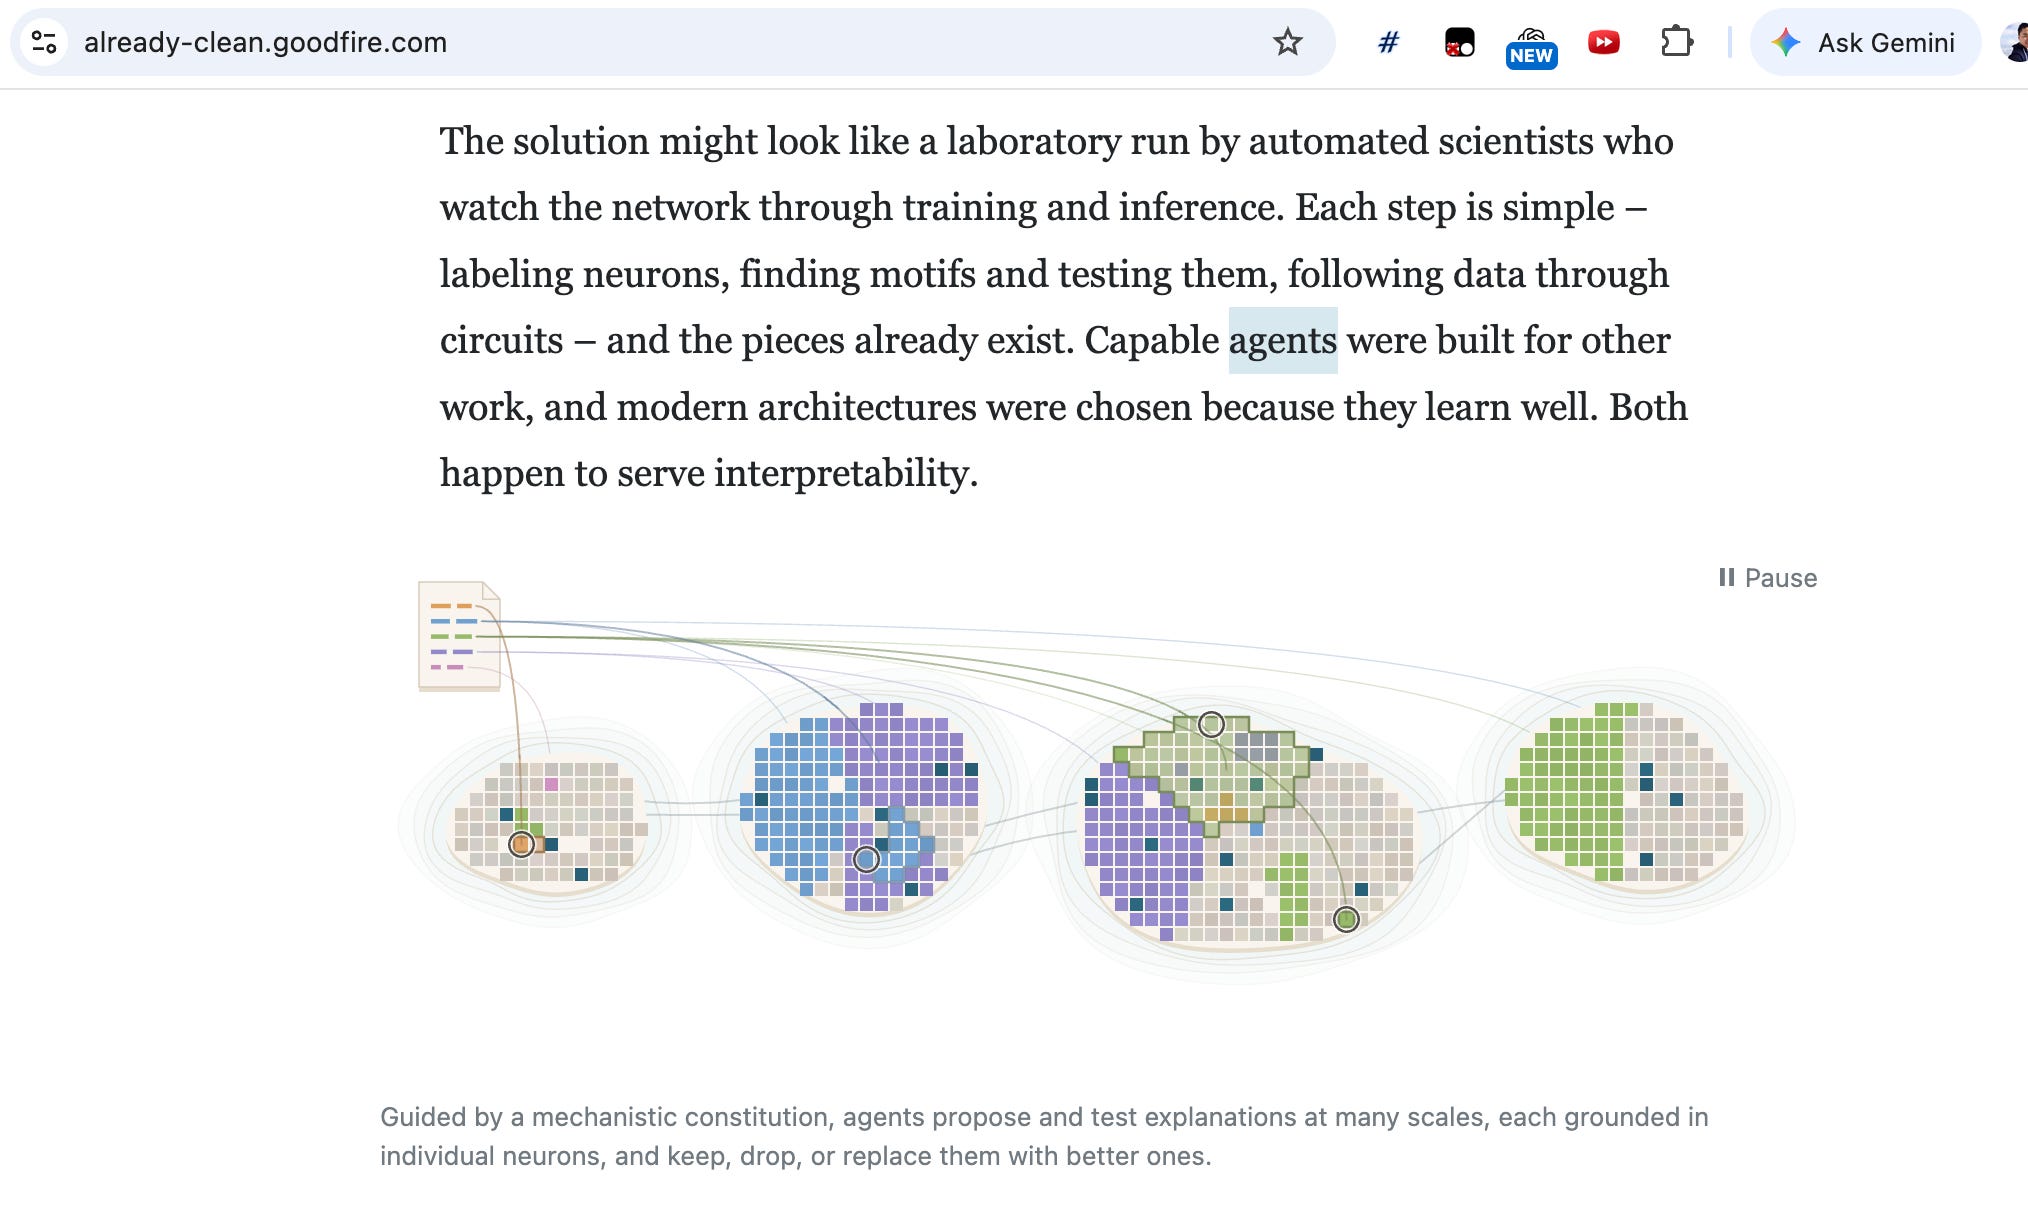
Agent 證偽多義性;Meta 發布 Muse Spark Open
Goodfire 論文證偽神經網路多義性,認為可直接研究神經元;Meta 發布 816B 參數的 Muse Spark Open 模型。為什麼重要
對 AI 安全與可解釋性領域是重大進展,暗示對齊問題可能比預想更容易解決。Meta 的新模型支援 1M token 上下文及多模態輸入,適合長程 Agent 任務,但權重授權需歸屬標註。
模型公司與研究機構3 條
Stack Overflow for Agents 透過 ChatGPT 外掛使註冊量三倍成長
Stack Overflow 推出專為 AI Agent 設計的開發者平台,利用 ChatGPT 外掛將註冊量提升三倍,並帶動 Agent 創建量最高成長 10 倍。為什麼重要
此案例展示了 LLM 生態系中「Agent 基礎設施」的商業潛力。對於開發 AI 工具或建構 Agent 工作流的團隊而言,這提供了將現有開發者社群資源轉化為 Agent 服務入口的參考範例。關鍵在於透過 ChatGPT 等主流入口整合,能顯著降低開發者使用門檻並加速採用。

建構生物科技領域高算力、受治理 Agent 的架構設計模式
Google Cloud 提出針對生物科技的 Agent 架構,結合 ESMFold 與 GenMol 模型,利用 GKE 上的 NVIDIA GPU 處理長時程、有狀態的高算力模擬任務。為什麼重要
此架構解決了通用 LLM 無法處理長時程、高算力科學計算(如蛋白質摺疊)的問題。適合在生物資訊學或藥物發現領域建構 Agent 的工程師參考。關鍵技術包括使用 NVIDIA Inference Microservices (NIMs) 部署在 GKE G4 VM 上,並透過預載模型權重至 VRAM 來解決容器冷啟動延遲,同時確保專有數據不離開企業安全邊界。

從建構 Agent 外掛中學習的四個評估工程經驗
Google 分享建構 Agent 外掛的評估工程經驗,強調需同時執行「實時運行」與「僅規劃」測試,並建立基於完整系統行為的黃金基準集(Golden Sets)。為什麼重要
對於建構生產級 Agent 系統的團隊,此文章提供了避免「一次性演示」陷阱的具體方法。重點在於評估應涵蓋 Agent 的完整執行軌跡(思考、命令執行、結果),而非僅看最終輸出。建議使用專家定義的黃金基準集作為持續整合測試的一部分,以應對模型更新帶來的不確定性,確保 Agent 在權限管理與多步驟互動中的可靠性。
Agents、MCP 與開發工具14 條

LangGraph 發布 1.2.16 版本
LangGraph 發布 1.2.16 版本,主要修復了 resume 機制下的多個 Bug,並為 PostgresSaver 新增 prune 功能。為什麼重要
此更新對使用 LangGraph 構建 Agent 的開發者重要,修復了無效 resume 值導致任務卡死、子圖重複執行等穩定性問題。同時 checkpoint-postgres 升級至 3.2.0,新增數據清理功能,有助於長期運行 Agent 的資源管理。

NVIDIA 與 IIT Madras 發布 2.8 兆 Token 印度語預訓練數據集
NVIDIA 與 IIT Madras 發布 Nemotron-pretraining-Indic-v1,包含 22 種印度語言的 2.8 兆 Token 數據及開放源生成管線。為什麼重要
此發布為多語言 LLM 開發者提供了高質量的印度語預訓練資源,涵蓋數學、代碼等技術領域。開放的 GPU 加速數據生成管線允許開發者自定義提示詞與質量檢查,適用於需要構建或微調支持印度語模型的團隊,解決了該領域數據稀缺問題。
Reflection 發布 501B 參數開放模型 Beam
Reflection 發布 501B 參數 MoE 模型 Beam,支持 1M 上下文,專注於編碼與 Agent 場景,採用 Apache 2.0 授權。為什麼重要
Beam 是首個由美國實驗室 Reflection 發布的開放前沿模型,擁有 23B 活躍參數,適合在自有基礎設施上部署。其原生支持 vLLM、SGLang 及 Rust 推理框架,並提供 SFT 與 RL 訓練配方,對希望自託管高性能編碼 Agent 的團隊具有重要價值。

OmniCompass:全模態視頻定位與理解基準測試
OmniCompass 發布包含 820 個視頻的基準測試,評估 50 個 MLLM 在時間/空間定位及問答上的表現,揭示開源與閉源模型差距。為什麼重要
該基準測試涵蓋文本與圖像兩種輸入規範,重點評估精確的時空定位能力。研究發現開源模型在音視頻理解上落後於閉源模型,且視覺參考並非總是提升性能。對於開發多模態視頻理解應用的團隊,此測試提供了評估模型細粒度感知能力的重要參考。

Waypoint-OPD:通過門控在線策略蒸餾轉移 RL 策略偏移
提出 Waypoint-OPD 方法,利用同一 RL 運行中的中間教師檢查點,比較學生模型訪問前綴下的早期與晚期相對動作偏好變化。為什麼重要
該方法旨在解決強化學習中策略漂移問題,通過門控機制在線蒸餾策略偏移。對於從事 LLM 強化學習訓練或策略優化研究的工程師,此技術提供了更穩定的策略轉移路徑,有助於提升模型在複雜任務中的學習效率與穩定性。

OpenGCUA:通用計算機使用 Agent 的完全開放棧
OpenGCUA 發布通用計算機使用 Agent 開放棧,整合視覺與程式化接口,在 OSWorld-v2 上將平均部分得分提升 19.6 分。為什麼重要
該項目定義了通用計算機使用 Agent (GCUA),允許模型選擇觀察、行動及工作組織方式。通過代碼執行與決策轉移,顯著提升了 GPT-6 Astra 等模型在真實設備上的任務效率。對於構建 Computer Use Agent 的開發者,其開放的 Harness 與 SDK 提供了重要的架構參考與實戰數據。

FDE-Gym:評估 AI Agent 在真實客戶交付場景中的能力
FDE-Gym 發布包含 95 個端到端交付任務的基準測試,揭示 AI Agent 在澄清模糊需求與發現未言明約束方面的顯著性能差距。為什麼重要
與傳統明確規格的基準不同,FDE-Gym 模擬真實客戶環境,要求 Agent 與利益相關者互動並操作生產級系統。測試顯示最佳配置僅解決 14% 的任務,主要瓶頸在於發現未言明約束。對於部署企業級 AI Agent 的團隊,此測試揭示了從實驗室到生產環境的「最後一英里」挑戰。

RoTA-Bench:通過交互式投影對齊評估 3D 空間推理
RoTA-Bench 評估 VLM 將 2D 觀察轉化為 3D 旋轉控制的能力,發現 GPT-5.6-Sol 成功率僅 17%,遠低於人類。為什麼重要
該基準測試要求模型通過連續旋轉恢復目標投影,強調精細控制與視覺反饋。研究顯示模型在姿態對齊上易出現偏差,且移除交互歷史會大幅降低成功率。對於開發具身智能或 3D 操作 Agent 的研究者,此測試揭示了當前 VLM 在精確空間控制上的核心弱點。

Self-Evolving Agent Harness:自演化 Agent 框架
提出 Self-Evolving Agent Harness 框架,通過反饋驅動修訂與演化優化,在固定模型權重下提升 Agent 性能並提供理論泛化保證。為什麼重要
該框架允許 Agent 自動修訂提示詞、記憶、工作流及可執行組件,並通過 PAC 學習理論保證可靠性。對於構建長期運行 Agent 的團隊,此方法提供了無需重新訓練模型即可持續優化系統性能的技術路徑,特別適用於需要適應任務分佈變化的場景。

MJev-Spatial:基於原生注意力匹配的 System 1 空間智能模型
MJev-Spatial 基於 Qwen3.5-4B 構建,通過直接候選分類統一空間問答與定位,比自回歸基線快 5.6 倍。為什麼重要
該模型利用預訓練注意力 Q/K 投影進行評分,實現零 Token 生成的快速空間決策。在 12 個基準測試中平均得分 65.64%,領先 7 個。對於需要低延遲空間理解能力的應用(如機器人導航、AR),此模型提供了高效且輕量化的解決方案。

Learning Where to Split:動態頻帶分割用於音源分離
提出動態頻帶分割 (DBS) 框架,學習音源分離中的頻率軸分割點,在 DnR v2 上將 BSRNN 的 SI-SDR 從 7.69 提升至 9.07 dB。為什麼重要
DBS 適配 BSRNN、TIGER 等現有模型,通過端到端學習優化頻帶邊界。對於從事音頻處理、語音分離或音樂信息檢索的開發者,此方法提供了無需修改底層架構即可提升分離質量的有效手段,特別適用於複雜混合音頻場景。

InfiniSplat v2:分析與改進任意視角的 Feed-Forward 3DGS
InfiniSplat v2 旨在改進任意視角下的前饋式 3D 高斯噴灑 (3DGS) 重建性能,提升多視角一致性。為什麼重要
該工作針對 3D 場景重建中的視角泛化問題,優化前饋式 3DGS 模型。對於開發 3D 內容生成、虛擬現實或機器人視覺的團隊,此技術有助於從有限視角獲得更穩定、高質量的 3D 表示,減少對多視角數據的依賴。

3DCodeVerse:以代碼探索 3D 世界
3DCodeVerse 提出僅通過代碼生成 3D 世界的方法,無需圖像/視頻/3D 擴散模型,支持靜態、關節物體及動畫。為什麼重要
該方法將 3D 內容生成轉化為代碼生成任務,利用 LLM 的代碼能力構建場景與運動。對於希望以程序化方式生成可控 3D 資產的開發者,此技術提供了比傳統擴散模型更精確、可編輯的替代方案,特別適用於遊戲開發與模擬環境構建。
PydanticAI v2.57.0 發布
PydanticAI 發布 v2.57.0,新增 Meta Muse 模型支援與 Harness ApprovalReviewer 功能,並優化 GPT-Live 與 Gemini Live 的即時歷史處理。為什麼重要
此版本對使用 PydanticAI 構建 Agent 的開發者重要,特別是涉及多模型整合與工具調用審批的團隊。關鍵變更包括新增 MetaProvider 以支援 Meta Muse 模型,以及引入 Harness ApprovalReviewer 讓模型在人類介入前審批低風險工具調用。此外,修復了 token 壓縮保留歷史過少、OpenAI 工具選擇錯誤等多個 Bug,並增強了 MCP Apps 工具結果向 AG-UI 和 Vercel AI 前端的轉發能力。
AI App、部署與雲端9 條
Android Skills:優化 AI Agent 的 Android 開發指令庫
Google 推出 Android Skills 倉庫,提供模組化 Markdown 指令,幫助 LLM Agent 執行符合最佳實踐的 Android 開發任務。為什麼重要
針對 LLM 在特定 Android 工作流中表現不佳的場景,該專案提供 SKILL.md 規範以增強模型領域知識。開發者可透過 Android CLI 或作為 Claude Code/Codex 插件安裝,讓 Agent 自動識別並應用相關技能。適合使用 AI 輔助 Android 開發的工程師。
Vercel Shop 正式發布:讓 AI Agent 成為 Shopify 商店的一級消費者
Vercel 與 Shopify 推出 Vercel Shop,提供機器可讀的產品資訊與 Universal Commerce Protocol,讓 AI Agent 能直接搜尋、加購並結帳。為什麼重要
此模板基於 Next.js 和 Hydrogen SDK,將產品頁面轉化為 Agent 可讀取的結構化數據,並支援 MCP 協議進行互動。適合電商開發者構建對 AI 友好的購物體驗,或希望整合 AI 購物助手的團隊。
Perplexity Decider V1.2 模型上線 Vercel AI Gateway
Perplexity 發布 Decider V1.2 27B 與 Flash 4B 多模態決策模型,支援內容分類、請求路由及評分,現已於 AI Gateway 可用。為什麼重要
這些模型透過概率回答 Boolean、Choice 和 Score 類問題,適用於支援工單路由、產品損壞標記等場景。適合需要自動化內容過濾或決策路由的應用開發者,可透過單一 API 鍵調用並監控成本。
@ai-sdk/zai 發布 3.0.33 版本
Vercel AI SDK 的 zai 提供者發布 3.0.33 補丁版本,更新依賴項以同步 provider 與 utils 庫。為什麼重要
此為常規維護更新,主要涉及 @ai-sdk/provider 和 @ai-sdk/provider-utils 的版本升級。使用該 SDK 的開發者建議同步更新以確保相容性。
@ai-sdk/xai 發布 5.0.24 版本
Vercel AI SDK 的 xai 提供者發布 5.0.24 補丁版本,更新依賴項以同步 provider 與 utils 庫。為什麼重要
此為常規維護更新,主要涉及 @ai-sdk/provider 和 @ai-sdk/provider-utils 的版本升級。使用該 SDK 的開發者建議同步更新以確保相容性。
@ai-sdk/workflow-harness 發布 1.0.154 版本
Vercel AI SDK 的 workflow-harness 發布 1.0.154 補丁版本,更新依賴項 @ai-sdk/harness。為什麼重要
此為常規維護更新,主要涉及 @ai-sdk/harness 的版本升級。使用該 SDK 進行工作流開發的開發者建議同步更新以確保相容性。
使用 Amazon Bedrock AgentCore 構建 AI Agent 生產級評估框架
AWS 發布部落格文章,介紹如何利用 Amazon Bedrock AgentCore 建立生產就緒的 AI Agent 評估框架,以解決 Agent 在生產環境中靜默降級的問題。為什麼重要
文章強調 Agent 失敗往往是「軟性」的(看似自信但錯誤),傳統軟體測試無法覆蓋。該框架旨在持續驗證 Agent 行為,確保其符合預期並維持用戶信任。適合正在部署生產級 AI Agent 的架構師與工程團隊。
Ollama 發布 v0.40.6 版本
Ollama 發布 v0.40.6,修復 Windows 孤立運行時問題,新增 q2_0 張量類型,並在雲端推出 clef 功能。為什麼重要
此版本還優化了 --ask 模式的問題鍵識別符。適合使用 Ollama 進行本地 LLM 推理的開發者,特別是關注 Windows 穩定性與新量化格式支援的使用者。
llama.cpp b11700 發布:支援 IBM Granite Switch 決策模型
llama.cpp 發布 b11700 版本,新增對 IBM Granite Switch 模型的決策(decision)模式支援,允許模型同時處理對話與決策任務。為什麼重要
此更新讓開發者能在本地部署中利用 Granite Switch 的雙重能力,特別適合需要即時內容過濾或安全決策的應用場景。主要變更包括轉換腳本、伺服器端參數透傳及文件更新,由 IBM 工程師 Gabe Goodhart 貢獻。
中文與日文來源16 條
Ubuntu 26.10 全面採用 Rust 核心工具,強化後量子密碼與企業登入
Ubuntu 26.10 完成 coreutils 從 GNU 遷移至 Rust 實作、改用 Sequoia PGP 驗證軟體更新、升級至 OpenSSL 4 支援後量子密碼技術,並強化 Microsoft Entra ID 企業帳號登入功能。為什麼重要
這次發行對維護 Linux 系統的工程師很重要。Rust 核心工具能減少記憶體錯誤漏洞,但管理員需測試既有的備份與部署腳本確保相容性。Ubuntu 26.10 非 LTS 版本,支援期限至 2027 年 7 月。軟體更新驗證從 GnuPG 轉向 Rust 開發的 Sequoia PGP,為後量子安全做準備;OpenSSL 4 支援更多後量子密碼技術與網站名稱加密。

Docker Hub 修補重大身分驗證漏洞 GhostPat,curl 修補 HTTP/2 RCE 漏洞
Docker Hub 身分驗證機制被揭露重大弱點 CVE-2026-105445(CVSS 9.4),curl 發布 8.23.0 修補 HTTP/2 上傳功能高風險漏洞 CVE-2026-92392(CVSS 8.1)。為什麼重要
使用 Docker Hub 的開發團隊應立即檢查個人帳號轉換為組織帳戶是否受影響;使用 curl 做資料傳輸的系統應升級至 8.23.0。其他重要更新包括 Next.js 修補兩個 RCE 漏洞(CVSS 9.5)、GitLab 修補滿分漏洞 CVE-2026-97229、Ivanti Connect Secure 遭 UTA0576 串連三個零時差漏洞利用。

微軟 MSVC 14.52 開放 C++23 正式標準支援
微軟發布 MSVC Build Tools 14.52 候選版,新增 /std:c++23 編譯選項讓 C++23 語言標準進入正式開發階段,並改善程式碼最佳化與 C++ 模組處理。為什麼重要
使用 MSVC 的 C++ 開發者可透過 /std:c++23 啟用新標準;編譯階段數學計算功能需手動指定 /Zc:cmath 啟用。新版改善迴圈最佳化、向量運算與 Arm64 架構支援,穩定版預計 2026 年 11 月推出。
TypeSafe 擴充 Jev 決策模型,支援圖片判斷與物件定位
TypeSafe 發布決策型 AI 模型 Jev 1.14.0,新增圖片輸入與 Box 物件定位功能,可回傳位置座標與信心分數;同步開放實驗性長上下文功能,支援最多 26.2 萬詞元。為什麼重要
Jev 是決策模型而非聊天模型,開發者提供資料後直接回傳判斷結果與機率。新版支援圖片分類、比對與物件定位,適合需要自動化決策判斷的應用。官方提醒影像功能尚未達生產環境可靠度;長上下文功能預設支援 6.4 萬詞元,啟用後提升至 26.2 萬。Jev 1.14 預計一周內切換至最新版,綜合分數從 1.13 的 58.9 提升至 60.0。

Claude Code 入門與逆引手冊:7 步基本操作與 22 項應用技巧
Zenn 教學指南,涵蓋 Claude Code 的基本 7 步設置、Skills、hooks、MCP 等 22 項應用功能,提供實際操作影片與詳解文章。為什麼重要
針對 AI 程式碼編寫工具 Claude Code 新手設計,教學內容包括安裝、常見問題排解與進階使用判斷。每章節均有配套影片示範,章末提供深入解說文章連結,適合想系統性學習 Claude Code 的開發者。
Claude Code 應用編第 4 部:/goal、輸出樣式、快速鍵、設定除錯與提交簽名
進階教學涵蓋 /goal 終止條件設定、輸出樣式自訂、快速鍵配置、設定問題除錯與 Git 提交簽名等 5 個主題,以實際操作示範說明。為什麼重要
針對日常使用 Claude Code 的開發者,文章記錄在 Claude Code v2.1.292 Linux 環境的實測結果。/goal 功能可自動執行任務直到條件滿足;輸出樣式支援自訂 Markdown 預設格式;涵蓋全系列 20 集的目錄索引與各項實踐技巧。

郵件下草稿修正實驗:要求 AI 寫明理由後,連件名都改對了
實測顯示,要求 LLM 在修正文章時「寫明理由」,比單純「直接修正」更能觸發深度修改,包括件名與核心內容的調整。為什麼重要
同一份三段式道歉信下草稿,條件 A(直接修正)只改表層措辭;條件 B(要求附註理由 15 字)則同時修正件名與含糊理由。實驗結論:「寫理由」這項額外要求會改變 AI 的自我評估基準,使其觸及更多需判斷的問題。但若資訊原本缺失,即使要求寫理由也無法補充。

Tech Watch 2026-10-16:記憶可追蹤與獨立監查機制
Zenn AI 科技動態週報精選 10 條新聞,聚焦 Anthropic 接受獨立評估、Sakana Chat 新增記憶可視化功能 My Fish、Meta Muse Spark Open 與 Apertus 1.5 等模型發展。為什麼重要
My Fish 功能展示 AI 記憶的使用次數與來源會話,支援追蹤記憶的根據;Anthropic 允許 METR 6 人獨立進行風險評估並公開發表;Meta Muse Spark Open 提供 816B 參數稀疏模型,支援文本、圖像、音聲與影片輸入,最大 100 萬 token 文脈,強調代理編程用途。

VRM 轉換 AI 參考圖卡瀏覽器工具:VRM 角色高解析度自動匯出
開發者創建瀏覽器工具,可直接從 VRM 檔案匯出固定構圖的高解析度 PNG 供 AI 影片生成模型使用,支援全身、胸部與臉部 6 種預設構圖。為什麼重要
解決 VRoid Studio 預設匯出低解析度(235px 寬)導致 AI 參考影像精度不足的問題。工具支援快速調整構圖、背景色、匯出尺寸,全程在瀏覽器完成,VRM 不上傳。實測用高解析度臉部參考圖後,AI 影片生成結果(MiniMax H3 Max、Kling)的角色五官相似度明顯提升。

同一記錄,四種讀法:無記憶 AI 模型面對相同對手紀錄的差異
個人開發者測試 4 個 LLM(Jev、Gemini、luna、Haiku)在德州撲克中,使用相同對手紀錄時的決策差異。結果顯示每個模型對對手數據的利用程度與方式都不同。為什麼重要
對 4800 手牌的測試表明:去除對手紀錄後,Jev 答案變化 49%,Gemini 43%,luna 30%,Haiku 27%;相比重複提問同一問題的 3-12% 變化幅度。模型對對手強手 vs 詐唬行為的反應不一致;Haiku 是唯一針對詐唬多的對手增加跟注頻率的模型。記錄使用率最高的 Jev 因過度依賴全 in 策略而效能不佳。
程式碼可視化:活用決定性計算剖析代碼庫
介紹用靜態分析工具(ripgrep、ast-grep、Serena、CodeQL)作為根據,引導 AI 代理進行可重現的代碼調查,減少幻覺並提高分析品質。為什麼重要
面對龐大陌生代碼庫時,直接餵給 AI 會溢出 token。本文建議用決定性計算輸出作為引據,由 AI 解讀而非生成。ripgrep 適合全局搜尋,ast-grep 擅長語法匹配,Serena 提供型別解析,CodeQL 支援複雜資料流分析。實驗發現:AI 也會自己撰寫分析腳本;多個工具驗證可找出誤差;靜態工具結合 LLM 讀解比單純工具輸出更有價值。

OpenCode Go 月額度最優化調查(3):同樣 $10 額度下,各模型成本效益分析
分析 OpenCode Go 訂閱內多個模型的成本效率。發現月額度上限計算方式非模型個別限額,而是用單價 ÷ 月上限算出權重。為什麼重要
OpenCode Go 月費 $10 固定,模型選擇影響可用的開發次數。關鍵發現:料金表的單價($/百萬 token)與月上限($15-$60)共同決定額度消耗比例;Luna 單價看似最便宜($0.1/0.5),但月上限只有 $15,使用權重為 0.67%,反而比月上限 $60 的 DeepSeek($0.15/0.60 對應 0.25%)消耗更多額度。經計算 Claude Code 開發場景(98% 快取讀取),Luna 與 DeepSeek 月額度消耗比約 4-5 倍。

AI 日報 2026-10-17:Meta 開源 816B、ChatGPT 入侵瀏覽器、Anthropic 接受外部監查
精選 7 條 24 小時內 AI 新聞,強調本週「開放」主題:Meta Muse Spark Open、NVIDIA Nemotron 3.5、OpenAI 瀏覽器整合、Anthropic 獨立評估機制。為什麼重要
Meta Muse Spark Open 816B 參數稀疏模型支援多模態與 100 萬 token;NVIDIA Nemotron 3.5 Super VL 120B 模型在單 GPU 推論性能領先;OpenAI ChatGPT 新增瀏覽器標籤讀取與互動功能;Anthropic 允許 METR 獨立評估團隊完整進場權限與公開發表結果;Google ChatGPT Study Mode 推出循序問答機制;Sakana Chat My Fish 追蹤記憶來源;Apertus 1.5 提供 262K token 文脈與可重現評估。

Claude Code 中 CLAUDE.md 與 auto memory 的使用時機
說明 Claude Code 兩種跨會話知識保留機制的差異與選擇標準:CLAUDE.md 供團隊共享版控,auto memory 記錄個人角色與進度。為什麼重要
CLAUDE.md 由人撰寫、每次開啟讀入、可 git 共享,適合團隊規範與跨路徑規則。auto memory 由 Claude 自動生成、僅本機存放、適合角色偏好與進行中工作。判斷標準:要給團隊守約→ CLAUDE.md;自己的角色好惡→ auto memory;絕不省略的流程→ hooks。實例:autoMemoryEnabled 可在 settings.json 關閉;/memory 指令可檢視與編輯各存放位置。

指示書一丟入「自動修復迴圈」就行:151 個巨集精簡到 120 個,夜間無人自律除錯實錄
開發者用 Claude Gemini 打造 VBA 巨集系統「秀コンボ」,AI 自動統廢合 151 個巨集、定義新工具、建立夜間自律修復迴圈,整個過程無人工複製貼上。為什麼重要
核心三層結構:單發「棚」(原子巨集)、組合「食譜」(工作流)與新增「棚工廠」(動態生成)。大棚卸作戰中,AI 先誤認棚工廠為食譜工廠;團隊堅守「殺手巨集」(入金消反、二重計上檢查、ABC 分析)不刪;最終從 151 精簡至 120。夜間自律迴圈透過實機測試自動發現問題、自行修正、重新測試,全程無人工干預。強調與 AI 協作時「清除過時用語」與「分清強制(hooks)vs 記憶」的重要性。

【趁免費還能用的時候!】用 OpenCode 2.0 試試 GLM、DeepSeek、Nemotron
介紹 OpenCode 2.0 開源編碼代理的新功能與免費模型。OpenCode 2.0 新增子代理機制、Git Worktree 操作、變更差異顯示等功能,支援 GLM-5.3-Flash、DeepSeek V4.1 Flash、NVIDIA Nemotron 3.5 Super VL 等模型。為什麼重要
適合想探索開源編碼代理且關注成本的開發者。OpenCode 與 Claude Code、Codex 不同之處在於工具與 AI 模型分離,可自由切換模型供應商。2.0 更新包括 CLI 套件改為 `@opencode/cli`、內置 Build/Plan/Explore/General 代理、支援多工作目錄並行開發。文章並提供 Windows 安裝步驟(需先裝 Node.js 與 npm)。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。