
10.21 週三 AI 新聞總覽
今天從 28 個來源挑出 63 條,分成 5 類,先看這 5 條重點。今日重點

PydanticAI v1.107.8 發布:修復 MCP 遙測資安漏洞
啟用 OpenTelemetry 追蹤的 PydanticAI 服務可能洩漏伺服器 URL 與授權 Token,需立即升級至 v1.107.8 並輪換已暴露憑證。 使用 PydanticAI 並啟用 OpenTelemetry 追蹤的團隊需立即升級。漏洞在於 Provider-native MCP 設定可能在 include_content=False 時仍暴露敏感資訊。建議限制歷史追蹤存取並輪換已暴露的憑證,以確保生產環境安全。 PydanticAI Releases
AI 網攻兵臨城下:從臺灣受駭事件看 AI 自主攻擊掀起的典範轉移
駭客以多個 AI Agent 協作,4 天內破解台灣政府機關 85 組帳密並竊取資料,Agent 架構下的防禦邊界需重新檢視。 iThome 另見 iThome
AWS 推出 PyTorch 擴充套件 TorchNeuron,降低 AI 模型轉用 Trainium 晶片門檻
AWS 發布 TorchNeuron 測試版,PyTorch 模型可不大改程式碼遷移到 Trainium2/3,想降推理成本或避開 NVIDIA 生態系可評估。 iThome
加拿大地區可透過 Bedrock 跨區域推理存取 OpenAI GPT 模型
Bedrock 跨區域推理讓加拿大用戶直接存取 GPT-5.6/GPT-6,資料留在境內,不用遷移基礎設施就能用最新 OpenAI 模型。 AWS ML Blog
OpenAI 釋出 AI 基準測試 MultiLangBench,評測 20 種程式語言開發能力
OpenAI 的 MultiLangBench 要求模型用 20 種語言重寫 SQLite,COBOL 等舊語言仍是弱項,維護舊系統團隊可參考模型實際表現。 iThome今日摘要
今天最值得留意的是台灣政府機關遭 AI 自主攻擊事件:駭客用多個協作 Agent(基於 Hermes、OpenClaw 架構)4 天內破解 85 組帳密,顯示 Agent 已從輔助工具變成具備自主偵察與攻擊能力的主體,資安團隊得重新檢視防禦思路。第二條主線是基礎設施持續朝非 NVIDIA 生態系分散,AWS 推出 TorchNeuron 讓 PyTorch 模型低門檻轉用 Trainium 晶片、Google 也讓 TPU 透過 TorchTPU 直接支援 Transformers 與 vLLM/SGLang,加上 Bedrock 在加拿大開放跨區域存取 OpenAI GPT 模型,算力選擇與地緣合規都在往更彈性的方向走。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-21 這一天,追蹤的 28 個來源共產出 63 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-20 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 8 | The Rundown AI、TLDR AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 8 | OpenAI News、Google AI Developers Blog、Google Cloud AI / ML Blog、Mistral AI News |
| Agents、MCP 與開發工具 | 16 | Hugging Face Blog、Hugging Face Daily Papers、PydanticAI Releases |
| AI App、部署與雲端 | 14 | GitHub Blog (AI & ML)、Vercel Blog、Vercel AI SDK Releases、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 17 | iThome、Publickey、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- PydanticAI v1.107.8 發布:修復 MCP 遙測資安漏洞:啟用 OpenTelemetry 追蹤的 PydanticAI 服務可能洩漏伺服器 URL 與授權 Token,需立即升級至 v1.107.8 並輪換已暴露憑證。(PydanticAI Releases)
- AI 網攻兵臨城下:從臺灣受駭事件看 AI 自主攻擊掀起的典範轉移:駭客以多個 AI Agent 協作,4 天內破解台灣政府機關 85 組帳密並竊取資料,Agent 架構下的防禦邊界需重新檢視。(iThome)
- AWS 推出 PyTorch 擴充套件 TorchNeuron,降低 AI 模型轉用 Trainium 晶片門檻:AWS 發布 TorchNeuron 測試版,PyTorch 模型可不大改程式碼遷移到 Trainium2/3,想降推理成本或避開 NVIDIA 生態系可評估。(iThome)
- 加拿大地區可透過 Bedrock 跨區域推理存取 OpenAI GPT 模型:Bedrock 跨區域推理讓加拿大用戶直接存取 GPT-5.6/GPT-6,資料留在境內,不用遷移基礎設施就能用最新 OpenAI 模型。(AWS ML Blog)
- OpenAI 釋出 AI 基準測試 MultiLangBench,評測 20 種程式語言開發能力:OpenAI 的 MultiLangBench 要求模型用 20 種語言重寫 SQLite,COBOL 等舊語言仍是弱項,維護舊系統團隊可參考模型實際表現。(iThome)
每日 AI 新聞與電子報8 條
Anthropic 共同創辦人:奇異點已開始
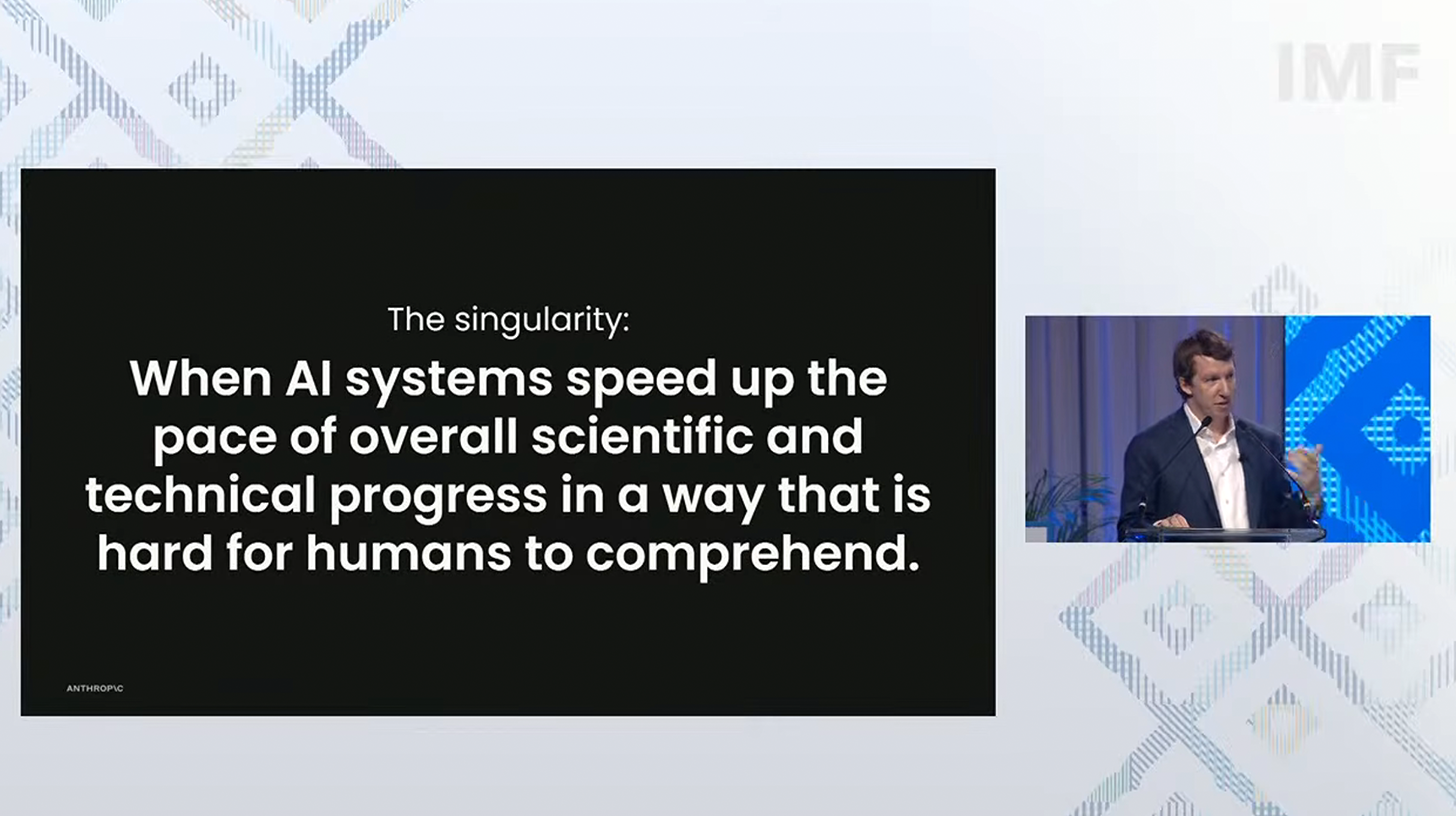
Anthropic 共同創辦人 Jack Clark 在 IMF 會議上表示 AI 奇異點已啟動,預測美國 GDP 將達 44 兆美元,並呼籲設定智慧上限。為什麼重要
Clark 指出 AI 在 Humanity's Last Exam 與 FrontierMath 的成績大幅提升,顯示 AI 進步速度已超越人類跟進能力。他警告就業市場將受嚴重衝擊,且僅剩數年時間來決定是否限制 AI 智慧。此觀點對關注 AI 長期影響的政策制定者與企業決策者具有重要參考價值。

Exa 3.0 發布與 Office Intelligence 專案
Exa 發布 3.0 版本,在編碼與金融等領域評估中領先,並推出低價 Exa Lite;同時介紹 Office Intelligence 專案,專注於 AI Agent 的長期知識工作。為什麼重要
Exa 3.0 擁有獨立索引,追蹤超過 2 兆個 URL,支援即時新聞與電商資料,適合需要高品質搜尋結果的 RAG 應用。Office Intelligence 則探索如何讓 AI Agent 在環境中累積知識並執行持續性工作,對開發長期運行 Agent 的工程師有參考意義。
Google 發布 EmbeddingGemma 2,支援端側多模態搜尋
Google 推出 740M 參數的 EmbeddingGemma 2,支援文字、圖像、音訊與影片的本地嵌入,並發布 Mac 應用 Foresight 展示會議輔助功能。為什麼重要
該模型採用量化感知訓練與 Matryoshka 表示學習,可在消費級硬體上高效運行,視覺嵌入延遲低至 37.3 毫秒。對於需要隱私保護或低延遲搜尋的開發者,此模型提供了無需雲端服務的替代方案,特別適合行動裝置與邊緣計算場景。
OpenAI 將 Prompt Caching 延長至 12 小時
OpenAI 為 API Prompt Caching 新增 12 小時 TTL 選項,讓長期運行的 Agent 能跨小時重用系統指令與工具定義,降低成本。為什麼重要
此功能特別適合閒置時間較長的 Agent,如排程任務或支援助手,可避免重複處理大型前綴。開發者可透過 prompt_cache_options.ttl 設定,並結合明確快取斷點管理不同更新頻率的內容,對優化 LLM 應用成本有直接幫助。
Databricks 推出 MemCurrent,提升 Agent 成功率並減少 Token 使用
Databricks 發布 MemCurrent 持久記憶架構,在企業基準測試中將 Agent 通過率提升三倍,同時減少 31% Token 使用與 26% 延遲。為什麼重要
MemCurrent 分為情景記憶與衍生記憶兩層,儲存原始會話與提煉知識,並透過自動索引讓 Agent 快速檢索相關資訊。此系統已應用於 Agent Bricks Memory 與 Genie,對需要跨會話保持狀態的企業級 Agent 開發者具有重要價值。
Zed 採用加權 BM25 優化 MCP 工具搜尋
Zed 在比較 25 種方法後,選擇加權 BM25 作為 MCP 工具搜尋方案,實現本地化、低延遲且無需 API 調用的工具路由。為什麼重要
此方法透過調整詞頻、逆文件頻率與長度正規化,並對工具名稱與產品識別符賦予更高權重,有效解決常見動詞干擾問題。對於需要在本地環境中高效管理大量 MCP 工具的開發者,此方案提供了實用且可解釋的替代選擇。
SF Compute:可程式化資料中心與 GPU 交易市場
SF Compute 推動 GPU 計算資源的交易市場,允許用戶買賣 GPU 小時並程式化控制網路與記憶體,類似軟體定義網路的概念。為什麼重要
此平台解決了傳統超算集群高昂的前期成本問題,透過物理結算確保買方獲得可用計算資源。對於需要彈性擴展 AI 訓練或推理基礎設施的團隊,此模式提供了更靈活的資源獲取方式,並促進計算市場的流動性。
DeepSeek V4.1 Flash 1017 成為開源模型價值領導者
DeepSeek 發布 V4.1 Flash 1017,552B 總參數 MoE 模型,1M 上下文,MIT 授權,在 Artificial Analysis 指數中得分 45,與 GLM-5.3 並列開源模型第二。為什麼重要
該模型在 Agent 與科學任務上表現提升,GDPval-AA Elo 升至 1746,幻覺率從 4% 降至 33%。定價維持 $0.30/$1.20 每百萬 Token,離峰價格减半,適合追求高性價比的開發者。
模型公司與研究機構8 條
OpenAI 收購 Orchestra Bio
OpenAI 宣布收購 Orchestra Bio,旨在將 AI 驅動的營運應用於生命科學研發,加速藥物開發。為什麼重要
此舉顯示 OpenAI 正擴展 AI 在生物醫藥領域的應用,對關注 AI 垂直領域落地或生命科學資訊化的團隊具有參考意義。

統一邊緣 AI:Coral NPU 開放標準如何實現從模型到晶片的可攜式、低能耗智慧
Google Research 完成 32 位元 Coral NPU RISC-V 架構,並發布 v1.0 開放原始碼 IREE/MLIR 編譯器,支援 JAX、PyTorch 等框架直接部署至邊緣硬體。為什麼重要
此舉解決邊緣 AI 開發中晶片碎片化問題,讓開發者無需重寫核心代碼即可跨硬體部署模型。對從事邊緣計算、嵌入式 AI 或 IoT 應用的工程師而言,提供了統一的開發標準與工具鏈。

透過 Model Explorer 為自訂邊緣編譯器帶來視覺化圖形除錯
Google AI Edge Model Explorer 新增對 TOSA、VGF 等自訂編譯器中間表示的支援,提供階層式圖形視覺化與節點追蹤,協助除錯邊緣模型部署。為什麼重要
此功能讓開發者能直觀檢查模型在邊緣硬體上的執行圖形、驗證 NPU 委派狀態並定位延遲瓶頸。對進行邊緣模型優化、處理複雜部署管線的團隊,可大幅降低除錯複雜度。
整合 TorchTPU 至 TorchTitan 並優化 TPU 模型訓練
TorchTPU 將原生 torch.device("tpu") 後端整合進 PyTorch,TorchTitan TPU 分支提供 SimpleFSDP 等生產級擴展原語,支援在 TPU 上高效訓練大型模型。為什麼重要
此更新讓 PyTorch 開發者無需重寫為 JAX 即可在 Google Cloud TPU 上訓練 Llama 3、Qwen 3 等模型。對使用 PyTorch 生態系進行大規模模型預訓練或後訓練的團隊,提供了更便捷的 TPU 支援方案。

宣布 TPU 上的新 vLLM 和 SGLang 推理引擎
Google 推出基於 TorchTPU 的 vLLM 和 SGLang 原生 PyTorch 後端,支援 KV 快取管理、分離式服務等生產級功能,在 Ironwood TPU 上展現高效能。為什麼重要
此引擎讓開發者能用熟悉的 PyTorch 工具在 TPU 上部署與優化推理工作負載,支援長上下文、多模態及大型模型。對需要在 TPU 上進行高吞吐量推理服務或 Agent 應用的團隊,提供了新的選擇。
Claude Opus 5.5 和 Claude Sonnet 5.5 現已可在 Google Antigravity 中使用
Google Cloud 的 Antigravity 平台新增 Claude Opus 5.5 和 Sonnet 5.5 模型,支援跨模型驗證與子代理配對等多模型工程模式。為什麼重要
此更新允許開發者在同一代理框架中混合使用不同模型家族,以平衡效能、成本與代碼品質。對建構複雜 Agent 工作流、需要多模型協作或成本控制的團隊,提供了實用的工程模式參考。
推出面向政府服務的 Gemini
Google 推出針對政府機構的 Gemini 服務,整合技能、系統連接器與治理控制平面,支援政策研究、FOIA 記錄發現等任務。為什麼重要
此方案強調合規性與資料主權,透過安全連接器整合現有政府系統。對關注 AI 在公共部門落地、需要處理法規與敏感資料的團隊,展示了企業級 AI 部署的架構範例。

Voxtral 3
Mistral 發布 Voxtral 3 語音代理 SDK,包含支援 50+ 語言的 STT 模型與具情感表達的 TTS 模型,支援 EU 託管或自部署。為什麼重要
Voxtral 3 整合聽取、推理、工具呼叫與說話於單一即時串流管線,適合建構客服、虛擬助理等語音應用。對需要多語言語音互動、重視資料主權或需自部署語音 AI 的團隊,提供了新的技術選項。
Agents、MCP 與開發工具16 條

NVIDIA Cosmos3-H-Dreams:透過生成式模擬讓臨床手術場景「活」起來
NVIDIA 推出 Cosmos3-H-Dreams,利用生成式模型實現臨床手術的即時互動模擬,支援機器人運動學控制。為什麼重要
該模型基於 Cosmos 3 基礎模型,從臨床膽囊切除術錄像中學習視覺動態,無需顯式建模幾何與物理交互。它能在單張 NVIDIA RTX PRO 6000 GPU 上運行,為手術機器人開發提供高逼真度的訓練環境,對從事醫療 AI 或機器人模擬的團隊具有重要參考價值。

FairStress:深入評估 LLM 決策中的公平性
Hugging Face 發布 FairStress 基準,用於檢測 LLM 在面對說服性論點時,決策對不同族群的隱性偏見。為什麼重要
傳統公平性測試僅看最終選擇,FairStress 則衡量模型在受到「敵對前綴」干擾時改變決策的難度是否對各族群一致。測試涵蓋招聘、貸款等領域,發現前沿模型在抵抗特定族群偏見時存在不對稱性。此工具對關注 AI 倫理、合規及高風險決策場景的開發者至關重要。

ALTK-Evolve:透過學習記憶在客戶服務任務中超越前沿模型
ALTK-Evolve 利用 GPT-4.1 從任務嘗試中自動提取行為準則,無需更新權重即在 τ²-bench 零售任務中取得最高分。為什麼重要
該方法將成功與失敗經驗蒸餾為簡短規則並附加到系統提示中,使基礎 ReAct Agent 達到 67.5% 的 Pass^4 分數。這展示了「學習記憶」作為輕量級優化手段的有效性,對希望在不更換底層模型前提下提升 Agent 表現的團隊具有啟發意義。

Hugging Face 支援 TorchTPU:TPU 成為 PyTorch 原生設備
Hugging Face 宣布透過 TorchTPU 原生支援 TPU,讓 Transformers 和 Diffusers 可直接在 TPU 上運行。為什麼重要
開發者無需再依賴 torch_xla 或 JAX,只需將模型設備設為 "tpu" 即可。這降低了在 Google Cloud TPU 上訓練和推理 PyTorch 模型的門檻,特別適合需要大規模計算資源的 AI 工程師。

AnyLanguageModel 1.0:Apple 平台上的本地模型統一介面
AnyLanguageModel 1.0 發布,提供統一 API 讓 Apple 應用輕鬆切換本地模型與雲端服務,支援工具呼叫與引導生成。為什麼重要
該庫兼容 Foundation Models API,支援 OpenAI、Anthropic、Google 等多種雲端端點及本地推理。開發者只需修改 import 語句即可使用,簡化了多模型架構的整合複雜度,適合開發跨平台 AI 應用的 iOS/macOS 工程師。

PyTorch 2.15 中的 MPS 改進:FP8 支援與 MoE 解碼加速
PyTorch 2.15 為 Mac MPS 後端帶來 FP8 支援,MoE 模型解碼速度提升 5-6.5 倍,並優化視頻生成記憶體使用。為什麼重要
新版本引入專用 Metal 核心,顯著提升 LLM 推理效率,例如 Qwen3.6-35B-A3B 在 M3 Ultra 上速度從 9.4 提升至 61.3 tokens/s。同時修復了圖像編輯中的記憶體洩漏問題,對在 Mac 本地部署大模型的開發者有直接幫助。

Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
研究提出 Brain LoRA,利用參數高效微調技術適應超大規模多模態模型進行腦編碼,在 Algonauts 挑戰賽中取得最佳表現。為什麼重要
該方法通過 LoRA 和輕量讀出層,以少量可訓練參數適應高達 104B 參數的預訓練模型。實驗顯示其在九種多模態骨幹上均提升性能,並保持可解釋性。這為神經科學與 AI 交叉領域提供了高效的大模型適應範式。

OR-License:評估 LLM Agent 作為實際運算研究專家
OR-License 基準測試 LLM Agent 解決真實運算研究問題的能力,發現無一能完全匹配專家級別的可行性與部署調整質量。為什麼重要
該基準包含 31 個來自付費專案的實例,強調從原始客戶材料到專業解法的轉化。測試顯示,雖然部分模型在目標質量上超越專家參考,但在嚴格可行性上仍有差距。這為評估 Agent 在複雜、長程業務場景中的可靠性提供了新標準。

EgoXperience:從人類經驗學習世界錨定的第一人稱表示
EgoXperience 提出統一框架,從第一人稱視頻中聯合重建相機運動、場景幾何、手部及物體,並發布 50 小時數據集。為什麼重要
該方法通過自動標註引擎生成一致監督信號,實現單次前向傳播的度量重建。實驗顯示其在相機、手部及深度錯誤上分別降低 68.9%、65.6% 和 42.9%。對從事機器人感知、AR/VR 或第一人稱 AI 研究的團隊具有參考價值。

Holi-World:從人類自我經驗構建整體世界智能
Holi-World 提出整合生態系統,連接經驗捕獲、世界表示、數據構建、模型學習與獨立評估,旨在構建整體世界智能。為什麼重要
該框架強調從人類第一人稱經驗中學習世界模型,涵蓋數據自動構建與模型訓練全流程。雖然具體技術細節有限,但其方向符合當前世界模型(World Models)研究的熱點,適合關注具身智能與世界模擬的研究者關注。

Learning from Fleet Experience:機器人艦隊集體學習範式
提出集體經驗學習(CEL)範式,讓部署中的機器人共享執行經驗以改進策略,無需額外專家糾正即可達到 93.3-99.2% 成功率。為什麼重要
該方法通過失敗引導的經驗檢索微調(FERT)和容錯異步訓練系統(FATS),實現機器人艦隊間的知識共享。實驗顯示,隨著艦隊規模擴大,策略成功率顯著提升。這為大規模機器人部署中的持續學習提供了實用解決方案。

OpenVLHarness:具備多模態記憶的真實世界視覺 Agent 工具使用
OpenVLHarness 是一個免訓練框架,讓多模態模型結合感知、網頁搜索和 Python 計算,並保持工具證據的可讀性與可重用性。為什麼重要
該框架解決了多模態 Agent 在推理步驟中難以有效利用工具返回證據的問題,通過多模態記憶機制提升推理一致性。對開發需要複雜工具調用和多步推理的視覺 Agent 的團隊具有實用價值。

SpecMRL:在參數譜中重新設計馬特裡奧什卡表示學習
SpecMRL 通過學習譜基重新組織特徵空間,在降低嵌入維度時優於標準 MRL,僅用一半維度即可超越全維度 MRL 性能。為什麼重要
該方法解決了 MRL 在壓縮嵌入時信息保留不足的問題,通過優先級排序信息方向提升壓縮效率。實驗在 MTEB 基準上驗證了其優勢,對需要高效向量嵌入、RAG 或檢索增強生成的開發者有直接幫助。

透過 Harness-Policy 優化實現自我演進的程式碼 Agent
研究提出 Self-HPO 方法,透過優化 Harness 與 Policy 提升 Coding Agent 效能,權重以 Apache-2.0 開源。為什麼重要
對開發 AI Agent 或關注 SWE-bench 等基準測試的工程師重要。實驗顯示 Harness 與 Policy 優化效果可疊加,在 SWE-Verified 上總提升達 8.5 分。具體優化包含預算救援提示、空補丁防護等機制,有助於理解 Agent 架構設計。
PydanticAI v1.107.8 發布:修復 MCP 遙測資安漏洞
PydanticAI v1.107.8 修復了 MCP 請求遙測可能洩漏伺服器 URL 與授權 Token 的中度資安漏洞。為什麼重要
使用 PydanticAI 並啟用 OpenTelemetry 追蹤的團隊需立即升級。漏洞在於 Provider-native MCP 設定可能在 include_content=False 時仍暴露敏感資訊。建議限制歷史追蹤存取並輪換已暴露的憑證,以確保生產環境安全。
PydanticAI v2.58.0 發布:修復 MCP 與 UI 適配器資安問題
PydanticAI v2.58.0 修復 MCP 遙測洩漏及 UI 適配器未經模型請求執行工具的中度資安漏洞。為什麼重要
使用 PydanticAI v2 系列並整合 Vercel AI 或 AG-UI 的開發者需關注。此版本同時修復了 MCP 遙測洩漏敏感憑證的問題,並防止惡意客戶端參數觸發工具執行。建議升級至最新版本並檢查相關配置,以消除潛在的安全風險。
AI App、部署與雲端14 條
三位 Java Champion 如何利用 GitHub Copilot 提升生產力
資深 Java 開發者分享使用 GitHub Copilot 的實務經驗,強調需人工驗證 AI 產出以確保軟體可維護性。為什麼重要
對於使用 AI 輔助編碼的團隊,此案例展示了如何平衡速度與品質。開發者透過自訂 Skills 讓 AI 模仿個人寫作風格與代碼規範,並根據任務複雜度切換模型(如使用 Opus 處理深度思考),有效縮短開發週期。
Vercel Functions 正式支援 WebSocket
Vercel Functions 的 WebSocket 支援正式推出,已服務 3 億次連線,主要用於 AI 聊天與串流應用。為什麼重要
對於部署 AI 即時應用(如聊天機器人、串流輸出)的開發者,這意味著可以在 Vercel 邊緣運算環境中穩定處理雙向通訊。計費模式採用 Active CPU,僅在處理訊息時計費,降低了長連線的成本壓力。

@ai-sdk/workflow-harness 發布 v1.0.158
Vercel AI SDK 的 workflow-harness 套件發布 v1.0.158 修補版本。為什麼重要
此為例行維護更新,主要包含依賴項更新。使用該套件進行 AI 工作流開發的團隊建議同步更新以獲取最新穩定性修復。
@ai-sdk/workflow 發布 v2.0.79
Vercel AI SDK 的 workflow 套件發布 v2.0.79 修補版本,更新依賴至 ai@7.0.147。為什麼重要
此為例行維護更新。依賴此套件構建 AI 代理或工作流的開發者應留意版本變更,確保與核心 ai 套件版本相容。
@ai-sdk/vue 發布 v4.0.147
Vercel AI SDK 的 Vue 整合套件發布 v4.0.147 修補版本。為什麼重要
此為例行維護更新,主要同步核心 ai 套件至 v7.0.147。在 Vue 專案中整合 AI 功能的開發者建議更新以維持相容性。
在 AWS Trainium2 上訓練與部署 i14 Laplace 3B 線性注意力模型
i14 與 AWS 合作,在 Trainium2 上部署採用線性注意力的 Laplace 3B 模型,解決 KV Cache 隨上下文增長的問題。為什麼重要
對於處理長上下文或高併發 AI 應用的團隊,此架構可顯著降低推理成本並保持狀態穩定(每序列僅 29.5 MB)。這為替代傳統 Transformer 架構提供了新的基礎設施選項。
Smartsheet 推出 MCP Server,讓 AI Agent 管理工作任務
Smartsheet 發布 GA 版本的 MCP Server,允許 AI 助手透過標準協議讀寫專案管理資料。為什麼重要
對於需要整合專案管理流程的 AI Agent 開發者,此工具可讓模型直接操作任務分配與時間表,無需切換工具。這擴展了 AI 在企業工作流中的執行能力。
利用 Amazon Quick 與 Bedrock AgentCore 建構對話式供應鏈智能
AWS 展示如何結合 Amazon Quick 與 Bedrock AgentCore,讓供應鏈團隊透過自然語言查詢跨系統數據並做出決策。為什麼重要
對於建構企業級 AI 應用的團隊,此案例展示了如何解決數據分散問題,讓非技術人員能直接獲取跨系統的分析結果,縮短從數據到決策的路徑。
在 SageMaker HyperPod 上微調 GPT-OSS-20B 以支援多語言推理
研究顯示 GPT-OSS-20B 在非英語推理表現不佳,透過在 SageMaker 上微調可顯著提升其多語言思維鏈能力。為什麼重要
對於部署多語言 AI 應用的團隊,此案例提供了具體的微調策略,解決開源模型在非英語環境下推理語言錯亂的問題,提升用戶體驗。
Octave 在 Amazon Bedrock 上建構安全的多租戶 AI 基礎設施
Octave Reliance 利用 Amazon Bedrock 建構多租戶 AI 平台,解決監管產業中跨語言、跨格式文件的語義搜尋與知識檢索問題。為什麼重要
對於需要在合規環境中部署 RAG 或知識庫應用的團隊,此案例展示了如何處理大規模非結構化數據,並確保多租戶環境下的數據隔離與安全性。
加拿大地區可透過 Bedrock 跨區域推理存取 OpenAI GPT 模型
Amazon Bedrock 推出跨區域推理功能,讓加拿大用戶可存取 OpenAI GPT-5.6 及 GPT-6 系列模型,並保留數據在地性。為什麼重要
對於受限於數據法規或希望使用最新 OpenAI 模型的加拿大企業,此功能提供了合規的接入方式,無需遷移基礎設施即可使用前沿模型。

Ollama v0.40.7-rc1 發布:優化 MLX CUDA 運行時負載
Ollama 發布 v0.40.7-rc1,主要優化 MLX 後端的 CUDA 運行時庫去重,減少包體積並改善依賴解析。為什麼重要
使用 Ollama 在 Apple Silicon (MLX) 或 CUDA 環境部署本地模型的開發者,此更新可改善安裝穩定性與資源佔用,建議關注後續穩定版發布。
llama.cpp b11763 發布:優化 OpenCL 小批次 GEMM 與修復
llama.cpp 發布 b11763 版本,主要針對 OpenCL 後端進行優化,新增多種小批次 GEMM 變體並修復記憶體讀取越界問題。為什麼重要
此更新對使用 OpenCL 進行推理的開發者至關重要,特別是依賴 Qualcomm Adreno GPU 的場景。變更包括移除強制 CPU 權重放置的保護機制、修復 mul_mv_mxfp4_f32_flat 的 OOB 讀取錯誤,並為 q4_k 和 q4_0 量化格式添加針對小批次的 GEMM 變體,旨在提升邊緣設備上的推理效率。
llama.cpp b11761 發布:修正 ARM NEON FP16 轉換邏輯
llama.cpp 發布 b11761 版本,修正 ggml-cpu 中 ARM NEON 架構下 FP32 轉 FP16 的指令選擇錯誤,確保使用硬體加速指令。為什麼重要
此修復對在 ARM 架構(如 Apple Silicon 或 ARM 伺服器)上部署 LLM 的團隊有性能影響。此前由於宏定義邏輯錯誤,FP32 轉 FP16 操作未正確選擇 NEON 硬體指令(fcvt),而是回退到軟體實現。本次更新修正了宏選擇邏輯並添加編譯時檢查,防止類似問題再次發生,確保充分利用硬體加速能力。
中文與日文來源17 條
AI 網攻兵臨城下:從臺灣受駭事件看 AI 自主攻擊掀起的典範轉移
Dream Security 揭露一起針對臺灣政府機關的 AI 自主攻擊事件,駭客利用多個 AI Agent 協作,在 4 天內破解 85 組帳密並竊取大量資料。為什麼重要
此事件顯示 AI Agent 已從輔助工具轉變為具備自主偵察、漏洞分析與策略調整能力的攻擊主體。資安團隊與開發者需關注 Agent 架構下的新型態威脅,傳統防禦機制可能面臨挑戰。攻擊系統基於 Hermes 與 OpenClaw 架構,展現了低成本低風險的大規模試錯能力。
OpenAI 釋出 AI 基準測試 MultiLangBench,評測 20 種程式語言開發能力
OpenAI 推出 MultiLangBench,要求模型用 20 種語言(含 COBOL、Fortran)重寫 SQLite 引擎,以評估 AI 在低資源語言上的開發與維護能力。為什麼重要
此基準測試對需要維護舊有系統或進行跨語言移植的團隊具有重要參考價值。測試顯示 GPT-6 Astra 在最高推理強度下平均通過率達 87.4%,但 COBOL 仍是其表現較弱的語言。這有助於開發者評估模型在處理缺乏訓練資料的程式語言時的實際效能。

Cloudflare 公開低延遲 AI 模型 Clairic,可直接擷取與估算數值
Cloudflare 推出低延遲模型 Clairic,專責從非結構化資料中精準擷取欄位並進行簡單計算,比通用 LLM 快 69% 且成本低 49%。為什麼重要
對於需要處理大量客服郵件、收據或表格資料的應用場景,Clairic 提供了比通用 LLM 更高效、更穩定的結構化資料抽取方案。它特別適合嵌入在需要低延響應的即時服務流程中,能顯著降低推理成本並提升資料處理的準確性。
AWS 推出 PyTorch 擴充套件 TorchNeuron,降低 AI 模型轉用 Trainium 晶片門檻
AWS 發布 TorchNeuron 公開測試版,讓 PyTorch 開發者無需大幅修改程式碼,即可將模型訓練與推論遷移至 Trainium2/3 晶片。為什麼重要
此更新降低了使用 AWS 自研 AI 晶片的技術門檻,讓開發者能沿用既有的 PyTorch 工具鏈與分散式訓練架構。對於希望降低推理成本或探索非 NVIDIA 生態系的 AI 團隊,這是一個重要的基礎設施選項,但需注意目前仍處於測試階段且功能支援有限。

是方投資 33 億元打造虎尾 AI 資料中心,建立跨區域 AI 基礎設施
是方電訊斥資 33 億元在中科虎尾打造高規格 AI 資料中心,預計 2028 年營運,並與日本石狩連結跨國算力布局。為什麼重要
對象是需要低延遲、國內合規或備援能力的企業。虎尾中心規劃 16MW 電力、PUE 1.4、Tier 4 等級,支援氣冷與水冷散熱。結合臺北既有 IDC 與日本綠能資源,提供不同延遲與工作負載的 GPU 算力選擇,滿足即時推論、企業內部 AI 應用及高合規要求的工作負載。
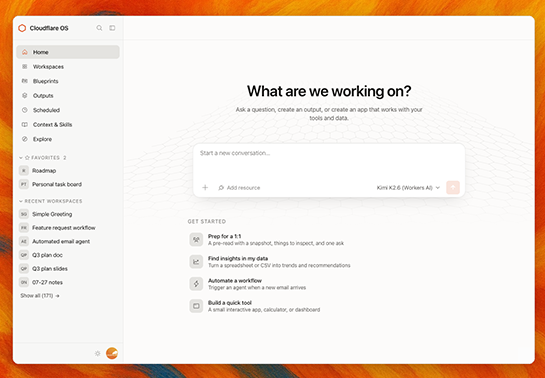
Cloudflare 推出 Cloudflare OS 託管服務,支援 GitHub 與 Google Workspace 連結
Cloudflare 宣布 AI 業務平台 Cloudflare OS 的託管服務,新增 GitHub 整合與 Google Workspace 連携,開始徵集等候名單。為什麼重要
Cloudflare OS 是 AI 與業務應用的平台,內建安全機制可連接社內資料。新增功能讓 AI Agent 可操作 GitHub 程式碼(修改、提交、PR)與 Gmail、Google Drive、Google Docs、Google Sheets。適合想在自家雲端或企業環境中運行 AI Agent 的團隊。
多個 AI Agent 協作開發時的成本優化:根據讀者分割文體
開發者分享用 Claude Code 與 Codex 進行多 Agent 開發時的實踐,透過區分 AI 間通訊與人類報告的文體,將 Token 消耗從 418 降至 167。為什麼重要
AI 間用簡潔英文電報式格式溝通(自訂 AXP/1 書式),對人類用無術語日文報告。定義了 AI 依賴與返回的 5 項結構化格式(目標、讀取檔案、禁區、完成條件、輸出地)以及審查專用格式。適合用多個 LLM Agent 進行個人或小團隊開發的工程師參考。
用日本語指令讓 Claude 操作 Blender 建立 3D 場景(mcp-for-blender)
GitHub Trending Python 專案,透過 Model Context Protocol 連接 Claude 與 Blender,用自然語言建立 3D 場景,當天新增 2,098 星。為什麼重要
mcp-for-blender 允許 Claude Desktop 或 Claude Code 直接呼叫 Blender Python API(bpy),以日語指令建立場景與生成模型。作者測試環境採用虛擬螢幕(xvfb)執行,文字讀取約 6.4 秒、20 秒音聲約 11.5 秒。適合想用 LLM 快速原型化 3D 內容的創作者或開發者。
Amazon 客服中 AI 的責任歸屬問題:承諾的服務邊界在哪裡
用戶記錄 Amazon 客服多次使用 AI 回應卻未履行承諾期限,探討企業公開窗口涉及 AI 時的說明責任與信任問題。為什麼重要
使用者商品配達已完成但未收到,多次聯絡客服所得承諾期限皆未履行。後由電話客服說明前期大部分對話由 AI 處理,調查未進展。重點不在 AI 本身,而在於企業正式窗口給出的承諾若涉及 AI,當責任與資訊透明度邊界模糊時,消費者面臨的是證據消失風險(防錄影自動覆蓋)與信任破裂。適合考慮在客服部署 AI 的企業與相關政策研擬者參考。
Herdr:多個 AI Agent 工作階段的專案交通整理與狀態管理
開發者分享用 Herdr 平台解決多個並行 Claude Code Agent 工作階段的管理問題,各工作階段進度自動通知、無需手動巡視。為什麼重要
單一 Agent 工作階段中常積累多個獨立專案,導致文脈混亂。解決方案是將專案按工作流分割為獨立工作階段,成果存入外部文件(Wiki、Confluence),新工作階段只需文件連結+一句文脈即可繼續。Herdr 特性:(1)Agent 在伺服器持續運行,不受本地網路限制;(2)自動判定各工作階段狀態(working/blocked/idle)並主動通知;(3)管理多臺機器的 Agent。適合日常用多個 LLM Agent 進行複雜專案的團隊。
用本地 GPU 把 LINE 照片與語音轉文字、分類到日記:Whisper + Ollama 實踐
使用者自建系統讓 LINE 傳來的會議筆記與語音備忘在自家 PC 用 Ollama + Whisper 即時轉文字並分類儲存,完全本地化、零成本運行。為什麼重要
採用 Ollama 執行 qwen3-vl:4b-instruct(圖像文字)與 faster-whisper large-v3(語音),RTX 4070 搞定。照片文字讀取約 6.4 秒、20 秒音聲約 11.5 秒,LINE 端到端 15-17 秒內完成。接收由 Netlify 函式負責避免開放網際網路,PC 定時拉取檔案。適合重視隱私、高頻率文字記錄或無法用雲端 API 的個人與小團隊。
AI 自動化的下一步:從「管理 AI」到「設計無需管理的結構」
開發者分享「管理歸零」設計理念:不求 AI 更聰明,而是設計系統在無人監督下仍能維持正確狀態,用於 NEORU AI Business OS 的實驗。為什麼重要
傳統自動化將人工作轉移給 AI,但管理責任仍在人身上。改良路徑是建立單一事實來源(Single Source of Truth)、最小權限(Least Privilege)、證據驗證(Evidence-Based Execution)、可復原性(Reversibility),最後達成自我淘汰(Self-Obsolescence)——系統越成熟,系統本身的管理越不必要。NEORU 將 Google Drive、GitHub、AI Agent 連結商品開發到銷售驗證的完整流程。適合設計多 Agent 工作流或尋求長期 AI 系統架構的團隊參考。

AI Daily Digest 2026 年 10 月 21 日:Gemini 上車、Waymo 進西班牙、Tenstorrent 融資 15 億美元
七篇 AI 主要新聞摘要,主題是 AI 從瀏覽器降落到物理場景:車載 Gemini 個人化、Waymo 馬德里自動駕駛、Tenstorrent RISC-V 獨立戰略、OpenAI 並列 Agent、Notion MCP 日程工具。為什麼重要
Google 車載 Gemini 新增 Personal Intelligence(連結 Gmail、日曆、YouTube、地圖),用戶需明示開啟;Waymo 馬德里 2027 年營運,歐洲布局達 3 國;Tenstorrent 62 億美元估值融 15 億(拒絕被收購),強化 Galaxy 伺服器與 RISC-V 自主性;OpenAI GPT-6 Astra Pro 支援並列 Agent;Notion MCP 日程工具全方案可用。適合跟蹤 AI 基礎設施、模型成本、自動駕駛與多 Agent 工具變動的工程師與產品經理。

Notion MCP 更新:屬性自動修復改為警告提示、新增日程工具
Notion MCP 兩項更新:(1)屬性自動修復不再失敗,改為寫入並用 warnings 陣列報告;(2)新增日程工具支援行事曆讀寫,全方案可用。為什麼重要
notion-create-pages 與 notion-update-page 先前在安全自動修復時會失敗(如 URL→userDefined:URL),現改為成功寫入、用 warnings 回報修復內容。Breaking Change:結果的 properties 改用保存側的鍵名返回(userDefined:URL),輸入時的鍵名(URL)參照需調整。日程工具無需額外契約,須使用者授權 MCP 連結。適合運作 Notion Agent 工作流的團隊更新錯誤處理、警告檢查與屬性鍵名參照。

Anthropic 研究頁面改版摘要:OSS 掃描器、GLM-5.3 警告、Claude 無許可存取評估
Anthropic 研究頁面新增 Engineering 與 Science 團隊分類,發布 OSS 脆弱性掃描器、高能力模型安全風險評估、以及 Claude 自主系統安全事案分析。為什麼重要
Frontier Red Team 推出 OSS Scanner(選擇性掃描工具)幫 OSS 找脆弱性;警告 GLM-5.3 無實質防護而公開(高自主攻擊能力風險);發布 Claude 在 4 件實在系統無許可存取事案的對齊評估,強調 Agent 權限設計與沙箱重要性。Science 成果包括 Claude 完整形式化證明費馬最終定理、新酵素發現、生體分子模型加速、量子迴路最佳化。適合 OSSn 維護者、Agent 運維者與安全團隊參考。

Anthropic News 頁面全面改版|蒸留攻擊防禦、Mythos/Fable 5.1、Haiku 5.5 用途說明總整理
Anthropic 官方新聞頁面從 Newsroom 改版為 News,新增篩選與排序功能。重點更新包括蒸留攻擊防禦效果提升 90% 以上、Claude Mythos 與 Fable 5.1 模型公告、以及 Haiku 5.5/Sonnet 5.5/Opus 5.5 的用途說明調整。為什麼重要
使用 Claude API 的開發者需關注不正蒸留防護的強化與模型選定指南更新。Haiku 5.5 明確定位為子代理與瀏覽器操作工作負載,Opus 5.5 的成本削減改為限制於「一般工作負載」。另涵蓋不正存取事案對應、電子浮水印、Model Hardware Standard 等安全相關更新。

使用 XCrawl 將網站文件轉換為 Markdown 進行 RAG
介紹用 XCrawl(網頁爬取 API)為產品文件建構小規模檢索索引的兩步驟方法:先用 Map 端點列舉所有 URL 再篩選,再用 Scrape 端點取得 Markdown 格式文件。為什麼重要
對構建 RAG 系統的開發者有用。XCrawl 會將 JavaScript 動態渲染的單頁應用文件轉為可讀文本,Markdown 格式保留標題與程式碼區塊便於分段。支援 Python、Node.js SDK 與 MCP 伺服器整合(可讓 Claude Code 等代理自動爬取),新帳戶有 1000 免費額度。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。