
10.23 週五 AI 新聞總覽
今天從 28 個來源挑出 56 條,分成 5 類,先看這 5 條重點。今日重點

Anthropic 將 Agent Skills 標準捐贈予智能體 AI 基金會
Agent Skills 標準捐贈 Linux Foundation,已有70+平台、100萬個Skills、2.8億次安裝,可直接沿用而非重造輪子。 對使用 Agent 框架的開發者和工具廠商重要。Agent Skills 是教導 AI Agent 特定任務與工作流的開放標準,通過捐贈予中立基金會確保社群驅動與供應商中立。已有成熟的生態:數千個開源 Skills、多個 Agent 平台整合、完整的版本管理與安全指引路線圖。 Anthropic News
Google Cloud API Gateway 支援實時串流:為 AI 工作負載優化
Cloud API Gateway 公開預覽支援SSE、WebSocket、gRPC串流,最長連線1小時,可接Gemini、Claude、OpenAI統一管理不用改API規格。 Google AI Developers Blog
Anthropic 推出主動式 AI 代理 Claude Duet,可離線執行任務
Claude Duet以Opus 5.5為底、接6000+連接器,能在使用者離線時自動處理Gmail、Slack等任務,美國Pro/Max用戶可先申請預覽。 iThome 另見 Qiita (AI)
OCRia-1:文件解析最佳視覺語言模型
OCRia-1只有40億參數,文件解析分數87.4分、贏第二名12.1分,做RAG或文件自動化可直接拿來換掉現有OCR模型。 LlamaIndex Blog
甲骨文緊急修補 Java 重大漏洞 CVE-2026-91403,與 eMudhra 中介憑證外洩相關
Java漏洞CVE-2026-91403達CVSS 9.1分且免互動可遠端攻擊,牽連eMudhra中介憑證外洩,用Java做網路服務要盡快檢查版本並修補。 iThome今日摘要
Anthropic 今天同時打出三張牌:把 Agent Skills 標準捐給 Linux Foundation 旗下的 Agentic AI Foundation、推出能在用戶離線時主動幹活的 Claude Duet,又在 Google Cloud 上線原生服務,這代表 Anthropic 正從賣模型轉向建生態與基礎設施卡位,開發者要留意「用哪個管道接」會直接影響帳單與功能可用性。第二條主線是成本與效能的精算風氣:日本工程師實測 Antigravity CLI 比 Claude Code 省下大量輸入 Token,Graphify 知識圖化與 AKV 快取工程也各自拿出可觀的成本下降數據,顯示「同模型不同包裝層」已成新戰場。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-23 這一天,追蹤的 28 個來源共產出 56 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-22 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 9 | TLDR AI、Ben's Bites、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 8 | OpenAI News、Anthropic News、Google AI Developers Blog、Google Cloud AI / ML Blog、Microsoft Research |
| Agents、MCP 與開發工具 | 10 | LlamaIndex Blog、Hugging Face Blog、Hugging Face Daily Papers |
| AI App、部署與雲端 | 11 | GitHub Trending (TypeScript)、Vercel AI SDK Releases、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 18 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- Anthropic 將 Agent Skills 標準捐贈予智能體 AI 基金會:Agent Skills 標準捐贈 Linux Foundation,已有70+平台、100萬個Skills、2.8億次安裝,可直接沿用而非重造輪子。(Anthropic News)
- Google Cloud API Gateway 支援實時串流:為 AI 工作負載優化:Cloud API Gateway 公開預覽支援SSE、WebSocket、gRPC串流,最長連線1小時,可接Gemini、Claude、OpenAI統一管理不用改API規格。(Google AI Developers Blog)
- Anthropic 推出主動式 AI 代理 Claude Duet,可離線執行任務:Claude Duet以Opus 5.5為底、接6000+連接器,能在使用者離線時自動處理Gmail、Slack等任務,美國Pro/Max用戶可先申請預覽。(iThome)
- OCRia-1:文件解析最佳視覺語言模型:OCRia-1只有40億參數,文件解析分數87.4分、贏第二名12.1分,做RAG或文件自動化可直接拿來換掉現有OCR模型。(LlamaIndex Blog)
- 甲骨文緊急修補 Java 重大漏洞 CVE-2026-91403,與 eMudhra 中介憑證外洩相關:Java漏洞CVE-2026-91403達CVSS 9.1分且免互動可遠端攻擊,牽連eMudhra中介憑證外洩,用Java做網路服務要盡快檢查版本並修補。(iThome)
每日 AI 新聞與電子報9 條

OpenClaw 創作者花費 1,000 萬美元 Token 成本
OpenAI 技術人員 Peter Steinberger 月度 Token 花費超過 1,000 萬美元,展現無限制預算下的 AI 工作流程差異。為什麼重要
Steinberger 在 Cloudflare Connect 2026 研討會分享經驗。月度超千萬美元的 Token 投入讓他能以與業界其他開發者完全不同的方式工作。對探索大規模 LLM 使用成本與優化策略的團隊具參考價值。
Claude 個人助理 Agent 應用
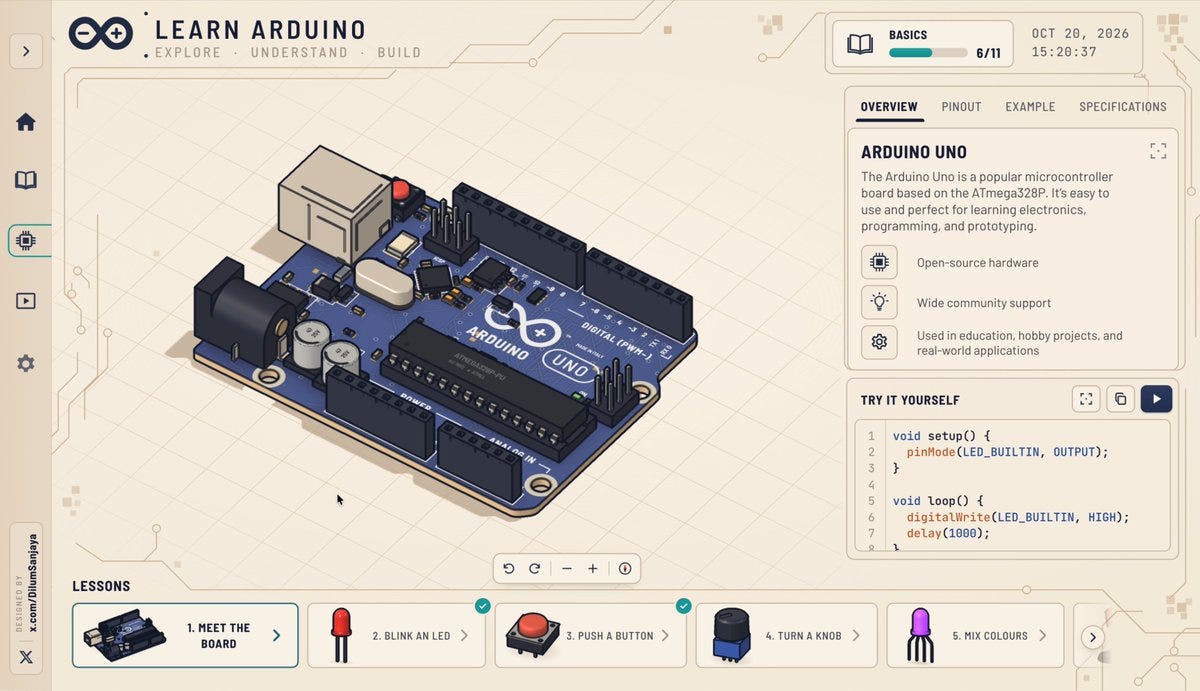
Claude 展示用 Opus 5.5 模型驅動的個人助理功能,包括書籤整理、影片生成(如水獺搭飛機用 WiFi 的場景)與城市像素地圖製作。為什麼重要
一個用戶利用 Claude Agent 自動生成倫敦大規模等角像素地圖資料集,微調 Qwen 影像 LoRA 適配器,執行多日推論並開發高效瓦片檢視器。展示 Claude Opus 5.5 在多步驟工程應用中的能力。對構建自主工具與資料處理工作流的團隊參考價值。
xAI 的 Grok 整合手機日曆、聯絡人與提醒
Grok 行動應用新增系統級存取權限,可讀取 iOS 和 Android 裝置上的日曆、提醒與聯絡人,朝全方位助理靠近。為什麼重要
與先前需要帳號登入的遠端服務連接器不同,新整合利用作業系統權限存取手機本地資料。用戶授權後 Grok 可建立行事曆事件、整理任務。此舉擴大 Agent 對用戶資訊的可見度,但安全文件尚待完善。對構建行動 Agent 與個人助理的團隊重要。
Anthropic Claude 為 239 個開源套件證明無當機:揭露模糊測試盲點
Anthropic 與 Theorem 用 Claude 為 123 個開源套件產生機器驗證的無當機證明,發現歷經數兆次模糊測試仍未發現的缺陷。為什麼重要
研究團隊用 Claude 生成 Rocq 證明指令碼,在組件層級建立形式驗證。過程自動化產生 180 百萬行證明代碼,而人工僅供應模型、工具與驗證設計。此方法將形式驗證(原本限於微核、密碼學等專業領域)變為實踐工具,對發布開源套件與關鍵軟體的團隊極具價值。
Anthropic Claude 直接登陸 Google Cloud,支援同步功能
Anthropic 在 Google Cloud 推出原生 Claude 服務,支援日零功能同步、Google Cloud IAM、計費與承諾用量抵扣。為什麼重要
此服務由 Anthropic 運營(非 Google 代理),使用者可透過 Google Cloud Marketplace 購買,合併帳單並套用 Google Cloud 承諾支出。包含 Claude Opus 5.5 快速模式、程式碼執行、Agent Skills API、受管 Agent 測試版、電腦使用及 Advisor Strategy 測試版等功能。模型涵蓋 Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5。對使用 Google Cloud 的團隊實現同步更新的最大價值。
OpenAI GPT-6 Astra 物理基準測試達 83.1%:CritPt v2 新領袖
GPT-6 Astra 在修訂的 CritPt v2 物理研究基準測試中得分 83.1%,遠勝 GPT-5 在 v1 的 32%;v2 新增代碼沙箱與修正的提示。為什麼重要
CritPt v2 修正了原始資料集中的欠規格提示、事實錯誤與筆誤(獨立審計 56 題發現 21 題有缺陷)。新版給予模型離線 Linux 沙箱中的程式碼執行工具,許可 Python 符號代數、數值模擬。四個配置突破 75% 門檻。此基準由物理學家設計測試研究助理能力,涵蓋 11 個現代物理分領域。對評估模型在科學計算與推理任務表現的團隊重要。
humans& 推出 Boba 群聊 AI:訓練於模擬社會的社交克制模型
humans& 推出 Boba 文字助理,執行於 Ampersand 模型,擅長跨週月的多人協作,可管理行程、建立提醒、追蹤承諾。為什麼重要
Boba 透過強化學習自模擬反饋(RLSF)訓練:在模擬社群中與數千模型人物互動跨百萬模擬日。獨立用戶模型 Persimmon 生成變異參與者行為。此法培養社交克制,使 Boba 在閒聊時沉默、有用訊息時貢獻。早期用戶交換超百萬條訊息。內部調查 290 回應中 70% 愛用、25% 喜歡。對構建群組協調 Agent 與長期交互工作流的團隊參考價值。

為何 AI 計算以矩形出現:Modal CEO Erik Bernhardsson 談基礎設施經濟
Modal CEO Erik Bernhardsson 在 Series D 後分享基礎設施見解:公司達 10 億年化收入、融資 7.5 億美元估值 160 億,部署近 30 億沙箱。為什麼重要
典型容量合約給固定 GPU 數量固定期限(矩形)。Modal 的賭注為「期限轉換」:跨千客戶統籌需求、下層鎖定容量、讓各客戶依需彈性使用。沙箱成長至營收約三分之一(創辦時未預期)。代碼生成 Agent、背景 Agent、強化學習驅動新需求。環境啟動與恢復延遲成為 Agent 體驗關鍵。對優化 GPU 成本與 Agent 基礎設施的團隊具重要參考。
OpenAI 補丁行星計畫與 Wiz 發現 PHP2Shell 漏洞:影響全球 70% 網路
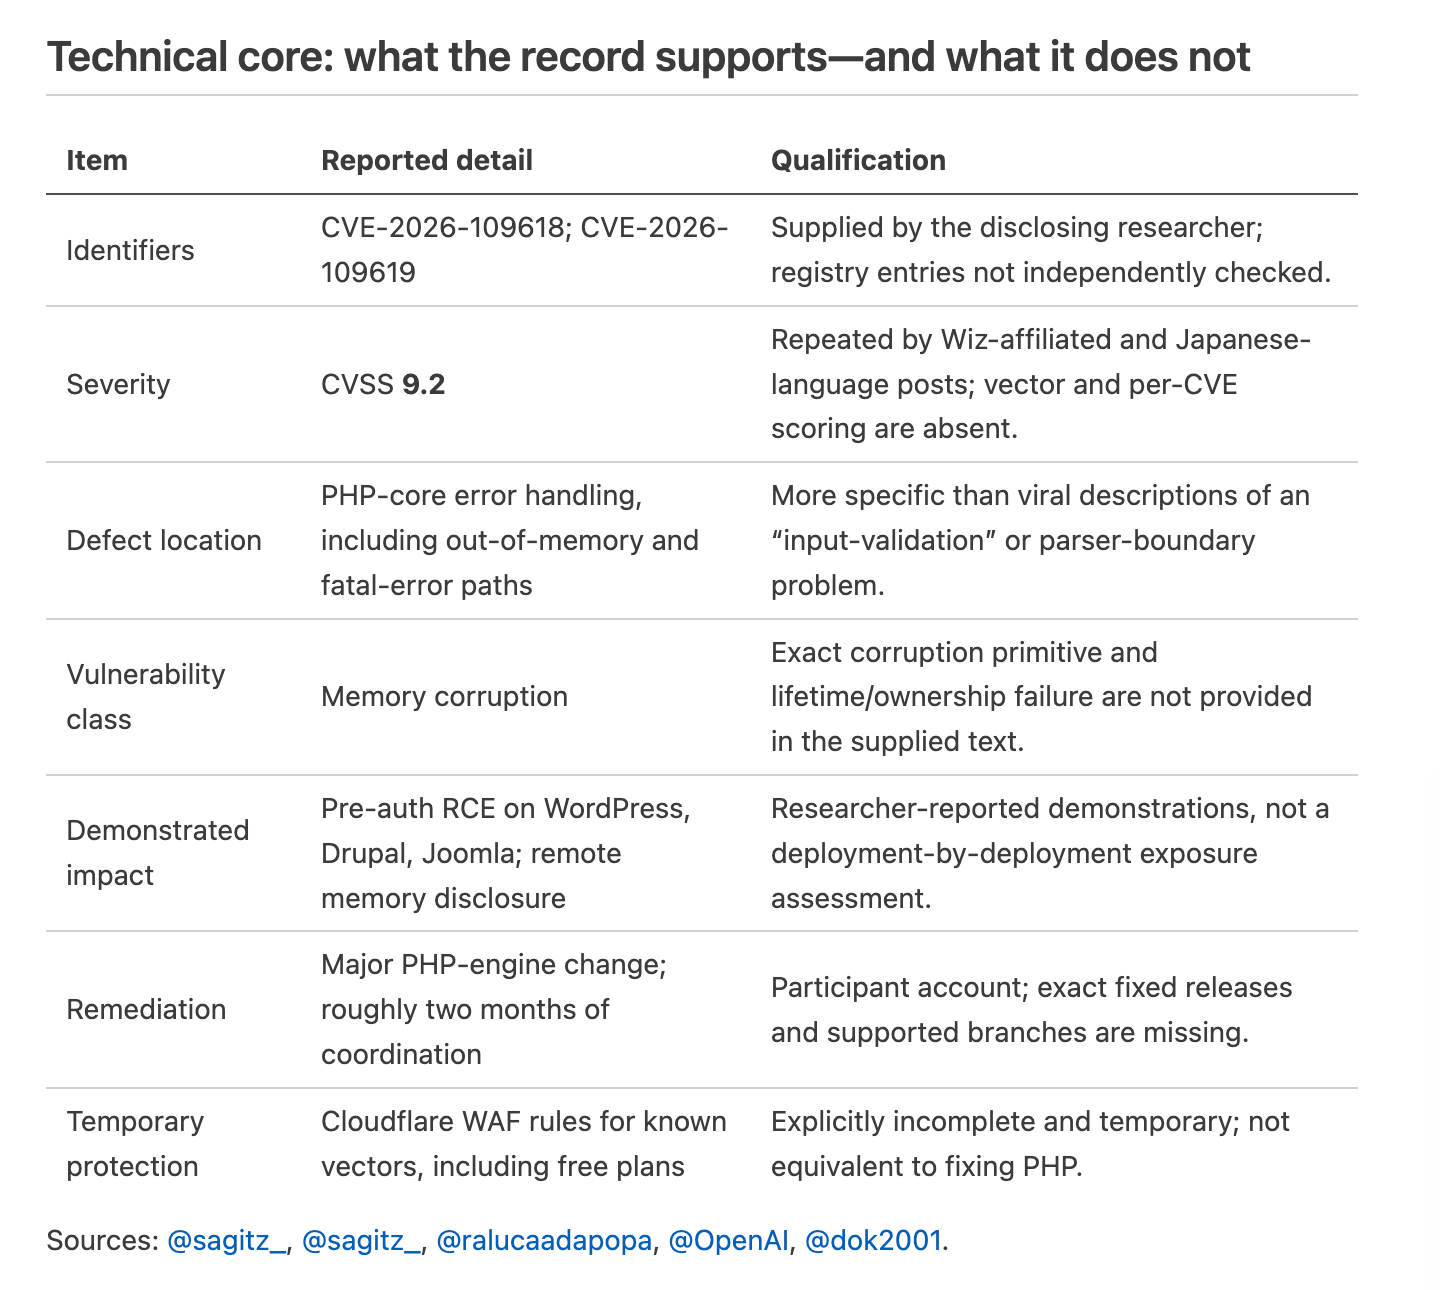
OpenAI 的 Daybreak 網路模型支援下,安全公司 Calif 與 Google 旗下 Wiz 分別以 GPT-5.6 Sol 與 Gemini 4 Argon 發現 PHP 引擎的兩個內存損壞漏洞(CVE-2026-109618、CVE-2026-109619),可遠端執行無驗證代碼。為什麼重要
漏洞位於 PHP 處理記憶體不足與致命錯誤邏輯,影響 WordPress、Drupal、Joomla。Calif 於 8 月 5 日發現,Wiz 隨後獨立驗證。OpenAI 與 PHP 基金會協調兩個月發布補丁。展示 AI 模型在大規模基礎設施安全審計的實際作用。對運維 PHP 應用與參與 Patch the Planet 計畫的團隊至關重要。
模型公司與研究機構8 條
Decisions API:為應用程式提供快速且低成本的決策
OpenAI 推出 Decisions API,讓應用程式可以進行快速、專注且成本低廉的決策。這是一項新的 API 功能,擴展 OpenAI 平台的使用場景。為什麼重要
適合需要在應用中做出快速決策的開發者,特別是對成本敏感的場景。Decisions API 針對低延遲、低成本的決策推理最佳化,可應用於審批流程、路由、分類等業務邏輯。
Uber 向全體員工部署 ChatGPT Work
Uber 正向超過 30,000 名員工推展 ChatGPT Work,協助團隊進行研究、資料分析、簡報製作和複雜工作流程。為什麼重要
展示企業大規模採用生成式 AI 助手的實際案例。ChatGPT Work 在 Uber 這種大型複雜組織中的應用,涵蓋多個部門的知識工作,反映企業 AI 工具市場成熟度提升。
Anthropic 將 Agent Skills 標準捐贈予智能體 AI 基金會
Anthropic 將 Agent Skills 開放標準捐贈給 Agentic AI Foundation(在 Linux Foundation 旗下),該標準已被 ChatGPT、Cursor、GitHub Copilot 等 70+ 個 Agent 平台採用,累計 100 萬個 Skills 發布、2.8 億次安裝。為什麼重要
對使用 Agent 框架的開發者和工具廠商重要。Agent Skills 是教導 AI Agent 特定任務與工作流的開放標準,通過捐贈予中立基金會確保社群驅動與供應商中立。已有成熟的生態:數千個開源 Skills、多個 Agent 平台整合、完整的版本管理與安全指引路線圖。
Anthropic 邀請生命科學研究者加入客座調查計畫
Anthropic 開放申請客座調查計畫,邀請學術機構、非營利組織或政府實驗室的研究人員利用 Claude 探索人類生物因果關係、分子生物學、藥物發現等課題,為期 8–12 週,Anthropic 免費提供模型與研究資源。為什麼重要
從事生命科學研究、特別是因果推理、結構生物學、藥物開發相關工作的研究人員應關注。這是 Anthropic 投資科學研究的重點計畫,學者保有資料與後續研究的完整權利,成果將開源發布。
Google Cloud API Gateway 支援實時串流:為 AI 工作負載優化
Google Cloud API Gateway 推出公開預覽版串流支援,包括伺服器推送事件(SSE)、WebSocket、gRPC 和分塊傳輸編碼,可在不修改現有 API 規格的情況下路由長連接與 AI 工作負載,並保留認證、流量限制和可觀測性。為什麼重要
對構建實時 AI 應用(如 LLM Token 串流、Agent 進度報告、協作編輯)的開發者重要。API Gateway 現支援完整的現代串流模式,可連接 Gemini、Claude、OpenAI 等模型,統一管理有治理和未治理流量,最長連接時間 1 小時。

Project Chrysalis:Google Cloud 上的自進化治理 AI Agent 架構
Google Cloud 發布參考架構 Project Chrysalis,示範如何結合 Gemini Enterprise Agent Platform、Agent Development Kit (ADK)、BigQuery 與深度防禦安全堆疊(Model Armor、Cloud KMS、Binary Authorization、OPA),構建能在 1.8 秒內修復生產中斷的自進化治理 Agent。為什麼重要
SRE、平台工程師與需要建立可靠 Agent 系統的團隊應關注。Chrysalis 展示了自修補、自批評、語義記憶與自重構等前沿能力,實驗中 cache 擊穿故障的修復時間從 15–45 分鐘降至 1.8 秒,HTTP 5xx 錯誤率從 72.7% 降至 0%。
Google Cloud 擴大 Claude 可用性與部署選項
Google Cloud 推出 Anthropic 管理的 Claude 部署選項 GA 版本,與既有的 Google 管理選項並行,給予開發者更多模型部署靈活性,兩者提供相同定價與帳單整合。為什麼重要
使用 Claude API 或計劃在 Google Cloud 上運行 LLM 的團隊應注意。Anthropic 管理選項提供日零存取 Claude Platform 新功能(如 Managed Agents、Skills、程式碼執行),Google 管理選項提供嚴格治理、合規與數據駐地保證。開發者可根據合規需求和功能優先級選擇合適部署模式。

Flint-interactive:用於生成互動式資料視覺化的語言
Microsoft Research 推出 Flint-interactive,讓 AI Agent 能生成具有點擊、篩選、縮放、交叉圖表互動的豐富互動式圖表,使用高階語義事件定義而非低階視覺化代碼。為什麼重要
對開發 AI 數據分析應用、儀表板生成工具的開發者重要。Flint-interactive 降低互動式視覺化的生成成本與複雜度,透過編譯器自動處理互動邏輯與視覺依賴,減少調試工作,支援圖表、文字、表格、應用的連接互動。
Agents、MCP 與開發工具10 條
OCRia-1:文件解析最佳視覺語言模型
LlamaIndex 推出 OCRia-1,一個 40 億參數的視覺語言模型,在文件解析基準上達到 87.4 分,領先其他模型 12.1 分,特別擅長處理表格、圖表和格式化文字。為什麼重要
OCRia-1 為 LlamaParse 提供動力,針對企業文件中大量結構化資料(財務報告、保險申報、稅表等)的解析需求而設計。這對建構 RAG 系統、文件自動化工作流程和代理系統的工程師很重要,尤其是需要精準且低成本提取文件結構的場景。在 ParseBench、PulseBench-Tab 和 fr-bench-pdf2md 三項基準上均表現領先。

ThinkingBox:用資料庫回饋做 Agent 強化學習
Hugging Face 開源 ThinkingBox-Training,透過資料庫狀態驗證把 Agent 的執行結果轉為強化學習獎勵信號,Qwen3.8-27B 成功率從 51.7% 提升至 60.78%。為什麼重要
ThinkingBox 解決 Agent 自稱完成但實際未執行的問題,包含 507 個基準任務。團隊引入「離線策略相對難度」選擇訓練樣本,經 50 步 GRPO 微調後,完全通過的任務從 38 增至 107。適合開發工具呼叫 Agent、資料庫互動系統的工程師參考其訓練方法論。

OlmoEarth v1.3:全球衛星影像嵌入模型
Allen Institute 發布 OlmoEarth v1.3 衛星嵌入模型及整個地球的預計算嵌入(10m 解析度、64 與 128 維),提供互動式地圖探索工具,在 27 項評估中 128 維版本領先 20 項。為什麼重要
OlmoEarth v1.3 將衛星時間序列資料壓縮為可重用特徵,用戶可在其上訓練輕量分類器執行作物識別、變化檢測等任務,無需 GPU 或大規模下載影像。對構建地理空間 AI 系統、監測應用的團隊有幫助。模型權重、預訓練資料與程式碼全部開源。

Granite 時間序列集成預測模型
IBM 開源 Granite Timeseries Ensemble,結合四個互補的開源模型進行預測,無需重新訓練即可產生中位數與分位數預測,提供統一的可擴充介面。為什麼重要
集成預測借鑑氣象預報做法,透過融合不同架構(PatchTST-FM、FlowState 等)來捕捉趨勢、季節性與區域變異。適合需要穩健時間序列預測的應用,特別是對模型選擇不確定的場景。用戶可直接從 Hugging Face 載入預設四模型組合。

StreamEval:互動式串流影片生成評估基準
推出首個互動式串流影片生成基準 StreamEval,包含 300 個測試案例,評估模型處理實時多模態請求、執行狀態變更、維持內容一致性的能力。為什麼重要
StreamEval 涵蓋頭像對話、頭像表演、世界生成、指令編輯、參考編輯五項任務,持續時間 15-300 秒。最高分為頭像表演 36.9、文本控制世界生成 25.93,顯示即時全模態互動系統在時序與一致性約束下仍有重大挑戰。適合開發串流影片生成 Agent 的團隊評估模型。

SpatialScout:VLM Agent 主動探索與 3D 場景建圖基準
推出 SpatialScout 基準評估視覺語言代理的主動 3D 物體建圖能力,在 80 個室內場景上測試 Claude Opus 5.5 等前沿模型,平均重疊度分數為 41.71%。為什麼重要
SpatialScout 涵蓋 3,140 個目標物體,要求 Agent 控制視角探索並在共享座標系統中估計物體中心,協調視點選擇、跨視圖關聯、幾何估計與地圖修訂。超過 0.9 交集聯集比的物體僅 3.25%,揭示精密度量地圖建構與粗糙物體配置復原間的巨大差距。對開發空間推理 Agent 的工程師有參考價值。

AKV:Agent 快取工程優化
引入快取工程方案 AKV,讓 LLM Agent 直接控制 KV 快取而無需修改軌跡,透過 drop 和 repos 操作優化成本與準確度,平均成本降低 27.7%。為什麼重要
AKV 解決 Agent 長軌跡時快取 I/O 與儲存成本過高的問題,並應對超過 LLM 最大上下文的情況。提出的 AKV 伺服引擎透過狀態感知快取重用與恢復達到 1.2 倍輸出吞吐與 1.5 倍 P95 延遲加速。適合部署長步驟工具呼叫 Agent、需要成本優化的團隊。

Looking Ahead:自迴歸影片生成中的未來演化建模
提出教導自迴歸影片模型預測世界演化方式的方法,物理真實性提升 11.2%(圖片轉影片)和 9.4%(影片轉影片),訓練效率提升 57.9% 計算和 63.4% 資料量。為什麼重要
該方法透過生成式未來預測改善影片生成模型的動態預測能力。適合從事影片合成、物理模擬渲染的 AI 工程師參考。作者指出目前訓練資料以通用場景為主,後續將探索融入更多物理相關資料。

LGWM:GUI Agent 的世界模型驗證器
提出解碼器無關的動作條件世界模型 LGWM,直接預測下一螢幕表徵,驗證 GUI 轉移與檢測被駭螢幕,達到 0.987 AUC 且延遲僅 17 毫秒。為什麼重要
LGWM 在表徵空間進行預測而非文本/程式碼/影像,無需第二個模型驗證,在 185 萬個真實 GUI 轉移上訓練。此方法為世界模型開闢第三種用途——驗證——而非單純模擬或規劃,對開發安全 GUI Agent 和自動化工具的團隊有價值。

PrismaCoder:多模態程式碼智能開源突破
推出 PrismaCoder-9B 和 PrismaCoder-35B,基於 PrismaForge 合成的 230 萬多模態程式碼資料集,在視覺編碼任務上超越開源模型,與領先專有系統相當。為什麼重要
PrismaCoder 採用基於評分準則的階層資料管道,同時用作監督語料策展與強化學習獎勵。準則分解程式正確性、程式碼品質、視覺呈現等因素,解決現有訊號(執行通過/失敗、程式碼相似度、任務特定驗證器)的通用性問題。對從事網頁、圖表、互動視覺生成的 Agent 與 UI 自動化工程師有參考價值。
AI App、部署與雲端11 條
GenOffice - 開源 AI 辦公室套件
開源 Office 套件,整合 AI Agent 直接編輯 .docx、.xlsx、.pptx 等文件,支援 Claude、OpenAI、Gemini 等模型,提供 CLI 與編碼 Agent 技能。為什麼重要
對於需要在本機編輯並保留原生 Office 格式的使用者、以及構建自動化工作流的 Agent 開發者重要。支援 macOS、Windows、Linux,檔案編輯作為追蹤變更可審查,AI 調用採本機優先設計,僅 LLM 呼叫離開本機。

@ai-sdk/zai@3.0.39 更新
Vercel AI SDK zai 套件版本 3.0.39 補丁發布,更新相依套件版本。
@ai-sdk/xai@5.0.29 更新
Vercel AI SDK xai 套件版本 5.0.29 補丁發布,更新相依套件版本。
@ai-sdk/workflow-harness@1.0.161 更新
Vercel AI SDK workflow-harness 套件版本 1.0.161 補丁發布,更新 harness 版本。
Amazon Polly 生成式引擎重大升級
Amazon Polly 生成式語音引擎提升表現力與準確度,新增 14 個聲音涵蓋 9 種語言,首次支援印度語與芬蘭語生成式語音。為什麼重要
對使用 Polly 建構語音應用的開發者重要。升級為向下相容——API 呼叫與語音名稱不變,現有應用無需修改即可獲得更自然的輸出品質。
IskayPet 用 Amazon Bedrock Managed Knowledge Bases 統一企業知識
IskayPet 案例展示如何用 Bedrock Managed Knowledge Bases 取代自建 RAG 系統,解決跨四種語言、三國分散文件的知識管理。為什麼重要
對實施 RAG 且想避免自行管理向量資料庫、嵌入管線的團隊重要。Bedrock 託管方案降低營運複雜度,適合在生產環境快速部署知識檢索。
SageMaker AI 新增無需管理 GPU 的模型自訂方式
AWS SageMaker 推出模型客製化功能,支援強化學習等後訓練技術無需自行管理 GPU 基礎設施。為什麼重要
對需要微調開源模型適應特定業務文本、產品目錄或臨床詞彙的團隊重要。內建後訓練工具降低 Agent 構建複雜度,縮短開發週期。
Amazon Quick:於 HIPAA 合規環境中部署 AI
AWS 宣布 Amazon Quick 服務可在 HIPAA 符合條件的環境中部署 AI 應用,專門處理受保護健康資訊(PHI)與醫療合規需求。為什麼重要
對醫療組織構建 AI 應用而需符合隱私法規的團隊重要。該解決方案內置合規考量,無需自行設計 PHI 處理機制。
在 Amazon SageMaker AI 上用 Kokoro TTS 實現低延遲 AI 語音代理
示範如何流式傳輸 Kokoro TTS 合成結果,讓 AI 語音代理邊生成內容邊發音,消除傳統等待全文生成的延遲。為什麼重要
對構建語音交互 AI Agent 的開發者重要。流式合成方案減少用戶感知延遲,提升對話體驗,解決五秒以上等待問題。

Ollama v0.40.9-rc3:支援 Gradium Phonon 檢查點正式版
Ollama 更新支援 Gradium 語音模型的正式版檢查點格式,包括預設聲音匯入與語音調理功能。為什麼重要
這次更新針對語音相關功能的穩定性進行改進,涵蓋檢查點匯入、推理設定及舊版格式的棄用。適合部署語音 AI 應用的開發者關注。版本號 v0.40.9。

llama.cpp b11828:即時 API 完成狀態修正
llama.cpp 修正即時 API 在已提交音訊完全耗盡後的完成信號發送邏輯。為什麼重要
此更新改進了語音實時推理場景下的流程控制,確保伺服器正確處理音訊輸入的結束狀態。建置語音交互應用或即時推理系統的開發者應關注。
中文與日文來源18 條
甲骨文緊急修補 Java 重大漏洞 CVE-2026-91403,與 eMudhra 中介憑證外洩相關
Oracle 發布 CVSS 9.1 分的 Java 重大漏洞 CVE-2026-91403,影響 GraalVM 與 Java SE 多個版本,可透過網路無須互動即遭攻擊,與印度數位憑證業者 eMudhra 中介 CA 憑證外洩事件相關。為什麼重要
此漏洞存在於 Java Secure Socket Extension(JSSE)元件,攻擊者可透過向 API 提供資料的 web service 進行攻擊,也適用於沙箱化 Java Web Start 應用程式與 applet。受影響版本包括 Java SE 8u511、11.0.33、17.0.21、21.0.13、25.0.5、27.0.1 等。由於涉及 eMudhra 外洩的中介憑證,這對使用 Java 進行網路通訊的開發者與系統管理員具有高風險。
Anthropic 推出主動式 AI 代理 Claude Duet,可離線執行任務
Anthropic 發表以 Claude Opus 5.5 為基礎的主動式 AI 代理 Claude Duet,可定期檢查連接應用程式、主動整理重要事項,並在使用者離線時繼續處理任務,已開放美國 Claude Pro 與 Max 訂閱用戶登記研究預覽版。為什麼重要
Claude Duet 整合 6000+ 連接器與外掛,支援 Gmail、Slack、QuickBooks 等服務,可協助整理信件、尋找未付款項或準備薪資資料。Duet 配有安全分類器防止外洩敏感資訊,執行重要操作前需取得使用者同意。對於在 Agent 工作流程中需要企業流程自動化的開發者與產品經理,這是 AI 代理應用的重要參考。

微軟與 Meta 合作推出 Type Server Protocol,讓 Pylance 支援 Meta Pyrefly 型別檢查
微軟與 Meta 合作開發型別伺服器協定(TSP),允許 VS Code 的 Pylance 外掛改用 Meta 開發的 Pyrefly 進行 Python 型別檢查,開發者可保留原有程式碼自動完成與 GitHub Copilot 整合功能。為什麼重要
Pyrefly 以 Rust 實作,著重大型 Python 專案的型別檢查速度,也能辨識 Pydantic 或 Django 常見寫法。此協定讓 Python 開發者可靈活切換型別檢查工具,無需放棄 Pylance 的核心功能。對使用 Python 進行開發、特別是大型專案的工程師有實用價值。

Salesforce 臺灣邁入第二年,Agent 與資料基礎建設成企業關注焦點
Salesforce 臺灣辦公室成立滿一年,客戶與營收達雙位數成長,Agentforce 與 Data 360 導入占新簽案件四成,企業 AI 應用從試點轉向結合企業資料、流程與業務場景的生產應用。為什麼重要
Salesforce 推出的 AIforce 建立新 AI 介面層,讓使用者透過自然語言與 AI 互動而無須開啟傳統 CRM 介面。公司與 Nvidia 合作開發 Koa 推理模型、與 Anthropic 合作 Claudeforce,讓 AI 更理解企業商業概念。這對做企業軟體、Agent 應用、資料治理的產品經理與開發者很有參考價值,反映了 AI 代理從工具走向企業流程自動化的趨勢。

使用 Claude Code 製作間取圖 3D 內看工具
開發者使用 Claude Code 建立從平面圖自動生成 3D 內看工具,包含圖面讀取、3D 化、搬入檢查等功能的完整技術方案。為什麼重要
此案例展示 Claude Code 在視覺理解與程式碼生成中的應用。從間取圖影像出發,AI 可自動萃取空間資訊、設計數據結構、透過 Three.js 實現 3D 化,並設計搬入檢查演算法。適用於需要快速視覺理解與程式碼生成的開發者。

使用 Graphify 知識圖化工具減少 LLM 查詢的 Token 消耗
Graphify 是 Python CLI 工具,可將程式碼、文件、SQL 架構轉換為可查詢的知識圖,作者實測在自己的程式碼庫達到 37.7 倍 Token 削減率。為什麼重要
Graphify 使用 tree-sitter 進行完全本地的程式碼解析,支援 --code-only 選項可完全離線運作,無需 LLM API 呼叫。相比每次 grep/Read 重複查詢,知識圖查詢大幅降低上下文 Token 消耗,適合使用 Claude Code、Cursor 等 AI 編程工具的開發者。作者測試顯示平均查詢成本從數千 Token 降至數百 Token。

用 Claude Code 一晚寫 29 篇文章,AI 檢查發現 24 個隱藏錯誤
作者用 Claude Code 一夜生成 29 篇文章草稿(約 9.6 萬字、104 張圖),交由另一 AI 逐一核實,發現 24 處隱藏錯誤,包括數字錯漏與邏輯反轉。為什麼重要
雖然第一個 AI 生成的文章讀起來自然流暢,機械文風檢查也僅指出 3 件,但第二個 AI 與原始記錄逐一比對後發現邏輯錯誤、記錄中不存在的理由等。此案例說明了 AI 寫作中真實存在但難以察覺的「似是而非的錯誤」,適合需要大量內容生成但要求準確性的團隊參考如何設計多層驗證流程。

AI 驅動的無人直播系統品質保證:從測試到長時間穩定性挑戰
開發者分享開發 AI 虛擬主播 YouTube/Twitch 無人直播系統的品質保證經驗,著重於「失敗不停止」系統的測試設計。為什麼重要
此系統出力不可預測(LLM 每次不同)、正確性主觀、失敗時不中斷。作者重新定義了保證對象:從「輸出品質」改為「系統行為」(何時應停止、故障後能否復原、是否能傳遞故障訊號)。實測發現長時間運行才出現的 Bug 有 4 類:累積誤差、無限增長、迴圈重複、狀態喪失。適合開發長時間運行 AI 系統(如無人服務、自動化工作流)的團隊。

Gemini 4 Argon 在 UI 截圖上的座標辨識精度大幅提升
使用 Gemini 4 Argon 對比前代 Gemini 3.5 Flash Lite,針對同一批 UI 截圖進行座標辨識與文件生成。新模型座標精度顯著改善,但新增了字型與標籤顯示問題。為什麼重要
Gemini 3.5 Flash Lite 的座標嚴重偏移超出畫面,Gemini 4 Argon 達成像素級精度追蹤。新版模型並自發性定義圖示規則(實線 vs 破線)。浮現的課題為中文字型渲染、標籤與 UI 元素重疊、文字被切割。此案例展示視覺 AI 在 UI 自動化文件生成上的進展,適合開發 UI 測試自動化、無代碼文件生成工具的人士。

小規模語言模型(SLM)的 5 個勝過 LLM 的應用場景
文章解釋 SLM 相較 LLM 的優勢:參數較少(Gemma 3 270M、Phi-4-mini 等),適合簡單分類、高頻調用、離線運行、低延遲、特化微調。為什麼重要
SLM 適用:(1) 簡單任務(如客服分類),(2) 大規模反複調用(成本與推論效率),(3) 無網際網路環境(端點部署),(4) 實時反應需求(機器人控制),(5) 特定業務微調。文章強調 SLM 不是廉價版 LLM,而是針對特定任務優化的專家。舉例包括 Gemma 3 270M 可在瀏覽器運行、LoRA 微調特定詞彙。適合在性能與成本間權衡的開發團隊。

分離測量:安全守護的判定變動源於入力表現、模型更新或評估方式
文章說明如何分離測量 LLM 安全守護的三種變化來源:輸入表現變化(翻譯)、守護邏輯更新、評估指標改變,避免混淆因果。為什麼重要
實例為相同操作、權限、檔案,但依賴文翻譯後安全守護判定反轉。需將表現變化與安全判定分開測量:定義意義保存變換、固定評估條件、分別計算「遮斷率絕對變化」與「判定反轉率」、比較更新前後的四重條件。適合做 Agent 安全守護、政策守護、動態決策系統評估的團隊,需要清晰、可重現的測量方法。

LiteLLM 供應鏈攻擊:不啟動 Python 驗證系統是否受影響
LiteLLM Python 套件(支援多個 LLM 提供者的包裝層)v1.107.0 遭入侵。作者分享用 find 與 grep 無需啟動 Python 即可檢查系統中是否存在惡意版本。為什麼重要
LiteLLM 是常見 Python 依賴,易隱藏在其他工具中。作者提供 macOS 命令檢查全域環境、venv、Docker 映像及依賴宣告(pyproject.toml、requirements.txt、Dockerfile)。重點:pip show 會執行惡意程式碼,應改用檔案查找。適合 Python 開發者快速排查是否在開發環境或容器映像中含有受影響版本。

AI Agent 調查日本公司資訊:四種架構的 Token 消耗與準確度對比
35 筆企業查詢測試,對比四種 Agent 架構:直接呼叫、Code Mode、束合 API、本地程式碼,測量 Token 消耗、往復次數與答案正確性。為什麼重要
結論:直接調用需 16,185 Token,Code Mode(含型態說明)8,580 Token,束合 API 5,422 Token,本地程式碼僅 182 Token。惟 Token 最少(Code Mode 無型態說明:3,742)在答案正確性上有缺陷—漏掉候選、虛報無資訊。Token 消耗與正確度未必相關,架構改動可大幅反轉成本。適合構建企業資訊查詢系統、金融合規檢查的 Agent 開發者衡量架構選擇。

VBA 巨集不再手寫,改用統合一覽表管理 100+ 個 AI 生成巨集
Excel VBA 開發者停止閱讀 AI 生成的巨集程式碼,改用「統合巨集表單」一層管理置放位置、作者、方法、執行狀態等 100+ 個巨集。為什麼重要
隨著 AI 寫巨集,程式碼行儀(變數大小寫、公式保護、文字截斷)由工具強制,開發者只需監督物差(測試規則)變化。統合表單整合了 7 個先前分散的窗:現用檔、加入項、個人巨集、棚巨集、食譜、全部、設定。支援直接選擇加入項巨集編輯。適合大量依賴 AI 代碼生成、需要集中管理與版本追蹤的非程式設計師,或需要快速原型開發的團隊。

AI 時代技術選型:應選「能夠應對脆弱性」的堆疊,不是「脆弱性最少」的語言
文章指出脆弱性公告件數不能衡量技術安全性,應改重視影響範圍評估、修正驗證、風險說明能力,並說明 AI 輔助與人工判斷的分工。為什麼重要
責任條件包含六項:構成所有者可追蹤、上游保維狀況可查、修正版可更新、修正可驗證、本番版本可追蹤回退、判斷與說明可記錄。AI 工具可協助調查、差分生成、測試案提示,但接受修正風險的判斷仍由人類承擔。建議使用 SBOM(Software Bill of Materials)說明軟體成分、版本與依賴。適合使用 AI 輔助開發的團隊建立脆弱性對應流程。

每 5 分鐘調用 LLM 再判定的最佳化:在價格變動 0.3% 以下、時間間隔 30 分鐘內時跳過
個人開發的股票分析平臺 ALPHA FORGE 使用 Claude Code 開發,透過設定價格變動幅度與時間間隔條件,減少不必要的 LLM 再判定呼叫,以降低 API 費用。為什麼重要
該項目在定期監控持股時,原本每 5 分鐘都會呼叫 LLM 重新評估,造成高額費用。改進後僅在價格變動超過 0.3% 或距上次判定逾 30 分鐘時才重新呼叫 LLM;同時先進行非 LLM 的安全性確認,再決定是否執行 AI 再判定。這對於頻繁呼叫 LLM API 進行決策的應用開發者特別有參考價值,涵蓋條件設計、成功與失敗記錄區分、以及重啟後的行為設定等實作細節。

Claude Console 新增組織單位的 Web Fetch 無效化與網域限制功能|400 錯誤對策
Anthropic 在 Claude Console 的 Capabilities 頁面新增組織層級的 web fetch 開啟/關閉與網域白名單/黑名單設定,web fetch 工具被禁用時 Messages API 會回傳 400 錯誤。為什麼重要
這項變更影響使用 Messages API web fetch 工具或 Claude Managed Agents 的開發者。管理員若關閉 web fetch,現有應用的相關 API 呼叫會立即失敗,需加入相應的錯誤處理;Managed Agents 的 web_fetch 也受組織網域限制約束,須同時檢查組織設定與代理層級設定。開發者應確認 Console 設定、實作 400 錯誤的 fallback 機制、設計代理層級的錯誤結果處理,管理者則需在變更設定前與開發團隊溝通。

同一模型 Claude Opus 5.5 在不同工具中的輸入權杖消耗對比:Antigravity CLI 相比 Claude Code 省 68–88%
實測比較 Antigravity CLI、Claude Code 與 Codex 在執行相同程式碼生成任務時的權杖消耗,同為 Opus 5.5 模型下,Antigravity CLI 的輸入權杖遠低於 Claude Code(68–88% 差異),顯示工具包裝層影響顯著。為什麼重要
在 Windows 11 上執行 44 次測試(起動成本測試與程式碼生成測試各數次),測試內容為生成雙階段區塊遊戲。結果顯示:Claude Code + Opus 5.5 輸入權杖 78,671(啟動 35,781),Antigravity CLI + Opus 5.5 輸入權杖 9,822+快取 15,381(啟動 5,326+快取 5,167)。權杖少不代表品質優劣—Claude Code 生成的程式碼更長(451 行 vs 236 行),兩者生成的遊戲都能正常執行。對使用 Claude API 的團隊而言,同一模型在不同客戶端工具中的效率差異值得參考。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。