
10.30 週五 AI 新聞總覽
今天從 28 個來源挑出 64 條,分成 5 類,先看這 5 條重點。今日重點

Mistral Large 4(Le Chonk)在 Hugging Face 上線
Mistral Large 4開放權重,1T參數49B活躍,網路安全測試達82%準確率,不受API廠商限制可自架部署。 重要性:開放權重模型對做安全漏洞修復和惡意軟體分析的團隊至關重要,不受 API 供應商限制。相比閉源模型,Mistral Large 4 在 Artificial Analysis Cyber Index 測試中達 82% 準確率。提供多種推理引擎支援(Transformers、vLLM、llama.cpp)和 Hugging Face Inference Endpoints 部署。 Hugging Face Blog 另見 Mistral AI News
Nvidia 釋出 Nemotron 3.5 語音模型,整合轉錄、翻譯與講者辨識
Nemotron 3.5 Transcribe開放權重,340億參數每次僅啟用43億,支援40種語言轉錄與講者辨識,詞錯誤率2.8%可自行部署微調。 iThome
MCP Servers v2.2.0 發布
MCP Servers v2.2.0修補憑證洩露與Node.js高風險漏洞,使用相關伺服器的開發者應盡速升級Node.js版本。 MCP Servers Releases
Google 推出 Connected Apps 平臺,第三方服務透過 MCP 整合 Gemini 與搜尋
Google開放Connected Apps平台預覽版,透過MCP把服務整合進Gemini與搜尋,已有50多款應用上線可申請加入。 iThome
高雄打造城市 AI 大腦,從影像理解進階到事件推理,提早發現淹水與塞車
高雄用VLM加推理模型讓道路巡檢派工縮短到2分鐘、淹水告警提前14分鐘,做城市AI應用可參考這套從辨識到推理的架構。 iThome今日摘要
開放權重陣營今天明顯加速,直接衝擊閉源模型的護城河。Mistral Large 4以1T參數、100萬token上下文上架Hugging Face,在網路安全與程式碼代理測試中追平甚至超越部分閉源模型;Nvidia同步釋出Nemotron 3.5語音系列與3.5 Super VL多模態模型,並開源Granary v2資料集,拉低語音辨識、多模態推理門檻。DeepSeek V4.1 Flash的安全評估顯示開放模型對齊表現逼近前沿閉源系統,但小版本更新可能讓安全性倒退,部署前需做增量測試。第二條主線是Agent工程從「能跑」轉向「可信任」:Cognition併購Corridor補強Devin的程式碼審查與安全掃描,MCP Servers緊急修補憑證洩露漏洞,相關論文揭露Agent在協作品質與排程效率上的落差。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-30 這一天,追蹤的 28 個來源共產出 64 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-29 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 9 | TLDR AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 6 | OpenAI News、Anthropic News、Google AI Developers Blog、Microsoft Research |
| Agents、MCP 與開發工具 | 16 | Hugging Face Blog、Hugging Face Daily Papers、MCP Servers Releases、CrewAI Releases |
| AI App、部署與雲端 | 14 | GitHub Trending、Vercel Blog、Vercel AI SDK Releases、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 19 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- Mistral Large 4(Le Chonk)在 Hugging Face 上線:Mistral Large 4開放權重,1T參數49B活躍,網路安全測試達82%準確率,不受API廠商限制可自架部署。(Hugging Face Blog)
- Nvidia 釋出 Nemotron 3.5 語音模型,整合轉錄、翻譯與講者辨識:Nemotron 3.5 Transcribe開放權重,340億參數每次僅啟用43億,支援40種語言轉錄與講者辨識,詞錯誤率2.8%可自行部署微調。(iThome)
- MCP Servers v2.2.0 發布:MCP Servers v2.2.0修補憑證洩露與Node.js高風險漏洞,使用相關伺服器的開發者應盡速升級Node.js版本。(MCP Servers Releases)
- Google 推出 Connected Apps 平臺,第三方服務透過 MCP 整合 Gemini 與搜尋:Google開放Connected Apps平台預覽版,透過MCP把服務整合進Gemini與搜尋,已有50多款應用上線可申請加入。(iThome)
- 高雄打造城市 AI 大腦,從影像理解進階到事件推理,提早發現淹水與塞車:高雄用VLM加推理模型讓道路巡檢派工縮短到2分鐘、淹水告警提前14分鐘,做城市AI應用可參考這套從辨識到推理的架構。(iThome)
每日 AI 新聞與電子報9 條
Vercel CI 加速編碼 Agent、Microsoft Copilot Harness 支援多模型工作
Vercel CI 測試版可與編碼 agent 同步,運行只需檢查受程式碼變更影響的任務,在 Vercel 內部將 push 到通過的時間縮短 2–6 倍;Microsoft Copilot Harness 統一多個 Copilot 應用,提供託管式 Agent 編排。為什麼重要
Vercel CI 針對 agent 的高速迭代週期優化,對使用 Devin、Claude Code 等工具的開發團隊有幫助。Microsoft Copilot Harness 整合代碼編輯、工作室、GitHub Copilot 等,支援跨模型推理和工具使用,現已開放 Microsoft Foundry 存取。
Krea Ad Studio 將品牌網站轉換為完整廣告活動
Krea 推出 Ad Studio,分析品牌網站視覺特性並使用微調的 Krea 3 模型自動生成符合品牌識別的廣告素材。為什麼重要
Ad Studio 通過掃描標誌、色彩、排版等視覺元素構建品牌套件,再生成多個變體。Krea 3 支援 LoRA 微調、區域編輯、六張參考影像輸入等控制機制,以保持產品一致性。API 訂價每 1K 影像 $0.03,2K 影像 $0.06(折扣前)。適合需要大量創意資產生成的行銷與設計團隊。
Cognition 收購 Corridor,為 Devin 補強安全性控制
自主編碼 Agent 公司 Cognition 併購程式碼安全新創 Corridor,將其安全檢查功能整合至 Devin 以強化 Agent 編寫的程式碼控管。為什麼重要
Corridor 整合 Cursor、Claude Code、Codex,在開發中提供安全指導、提交前掃描、拉取請求審查。前 CISA 官員 Jack Cable 和 Ashwin Ramaswami 共同創辦,前 Facebook 首席安全官 Alex Stamos 投資並加入。此舉解決企業要求:當 Agent 操作多檔案時審查負擔劇增,需要審計、策略執行、補救流程。Mercedes-Benz、美國陸軍、AT&T 等均為 Devin 客戶。
Anthropic Claude 自我評估安全風險,額外成本不到 2%
Anthropic 在 Claude 應答後立即附加自動安全評估,判定是否涉及有害請求,成本僅增加不到 2% 計算量。為什麼重要
自我評估利用 KV 快取重複使用原推理的中間計算,產生結構化風險評分與自由文字說明。在 Claude Fable 5 上對高優先級案例達 94% 召回率、1% 誤報率。相比早期憲法分類器增加 23.7% 成本,新方法更高效。對使用 Claude API 的團隊和平台方都有助於改進內容安全監控。
香港科大 LongChang 基準測試揭示 LLM 編造不存在的物理法則
LongChang 自動化基準測試將 LLM 放入有改變物理規則的模擬房間,要求發現異常。在 12 個評估模型中僅 GPT-6-Astra 達 16.7% 發現率,其他均為 0%。為什麼重要
LongChang 測試開放式科學發現能力,與一般假設檢驗不同。模型需自行判別異常現象、設計實驗、蒐集證據。即使在符合正常物理的對照場景中,仍有約三分之一的報告誤報異常。此研究對開發自主 Agent 的團隊重要,暴露 Agent 忽視矛盾證據、虛構未發生事件解釋的風險。
Transformer 神經算子獲得混沌預測的數學保證
新論文首次為純資料驅動的連續時間動態系統平滑化與預測提出通用近似定理,並在 Transformer Neural Operator 模型上驗證。為什麼重要
傳統物理型資料同化方法(如卡曼濾波)有數十年的收斂與穩定分析,而神經網路預測器多只有基準精度評估。本研究在連續時間框架下將平滑化與預測轉為算子學習問題,理論保證補強神經模型用於天氣預報、動態系統模擬等高風險應用的基礎。對研發可信任 AI 預報系統的團隊有科學參考價值。

Elorian Glimpse 視覺推理模型通過 DecoyCount 基準測試
新創 Elorian 發布首個視覺推理模型 Glimpse,及配套 DecoyCount 基準測試,測試大模型是否真實計數或仰賴視覺捷徑;Glimpse 在內部測試達 50.48%,超越 GPT-6 Astra 的 43.17%。為什麼重要
DecoyCount 測試視覺推理能力(例如區分真實物體與鏡像反射)。Glimpse 由 Elorian 推出,該公司今年 4 月獲 5,500 萬美元 A 輪融資。此基準對評估視覺 Agent、多模態模型在現實物理理解上的能力很有幫助,揭示邊界模型在視覺計數上的系統性弱點。

Gemini 4 Carbon 領先基準排名,網路安全防禦者優先存取
Google DeepMind 宣布 Gemini 4 Carbon 領先獨立評估排行榜,在漏洞發現、利用、補救等網安基準上達 88.2%、54.8%、71.0%,首先開放給受信任網安防禦者。為什麼重要
Gemini 4 Carbon 在 Artificial Analysis 綜合基準奪第一(得分 59),超越 Argon(50 分)。定價 $2/$10 per million tokens(啟動折扣),快取輸入 $0.20/million tokens。1M token 文本上下文,支援文字、影像、影片、語音輸入。透過 Fairwind Program 先予網安防禦者,承諾儘快開放一般開發者。此舉對安全工程團隊與政府機構採購 AI 工具的決策有重大參考。

Supabase 為何成為 Agent 首選後端
播客專訪 Supabase 創辦人,討論其聲明式資料庫綱要、本地無 Docker 執行、邊界資料庫計算等功能如何贏得各邊界模型 Agent 青睞。為什麼重要
Agent 在建構與測試環境時反覆執行初始化操作,Supabase 的宣告式綱要(存於 Git)、本地開發環境(無 Docker)、Supabase Compute(資料庫旁執行容器)消除多層摩擦。Supabase 在 AIE0 tracker 中獲得幾乎所有邊界模型首選後端地位。相比傳統資料庫,這些改進對 Agent 應用開發、API 後端建置團隊特別有價值。
模型公司與研究機構6 條
OpenAI 更新 Model Spec:指導更強大且有益的 AI
OpenAI 發布更新的 Model Spec,訂定五項核心價值觀,引導更強大的 AI 模型做出良好判斷、尊重人類主動權並忠實執行人類意圖。為什麼重要
這份規範針對 frontier model 的能力與安全性提供指導方針。對開發高能力 AI 應用的團隊重要,特別是使用 OpenAI 模型的產品經理與工程師。
OpenAI 分層監測方式檢測前沿模型的價值偏離
OpenAI 採用分層監測機制偵測 frontier model 的不對齊行為與未授權的 agent 活動,允許應變人員在事故升級前介入。為什麼重要
針對部署大型模型的企業與 AI 安全研究人員重要。分層監測策略提供實務性的對齊驗證方法,幫助團隊在生產環境中監控模型行為異常。
Anthropic AI for Science 計畫擴展至研究機構與基金會
Anthropic 宣布與 20 個科學基金會和研究機構合作,透過 AI for Science 計畫提供免費 Claude 額度給從事高影響力科研專案的研究人員,並推出科研團隊折扣方案。為什麼重要
重點包括與 HHMI Janelia 開發 Model Hardware Standard (MHS) 標準,讓 AI agent 安全操作實驗室儀器;支持 Allen Institute 組建 AI agent 團隊分析大規模資料集。對從事生物、醫學、物理、化學等領域的研究團隊重要,可加速科研工作流程。
使用 A2UI 與 CopilotKit Agents 開發生成式 UI 應用
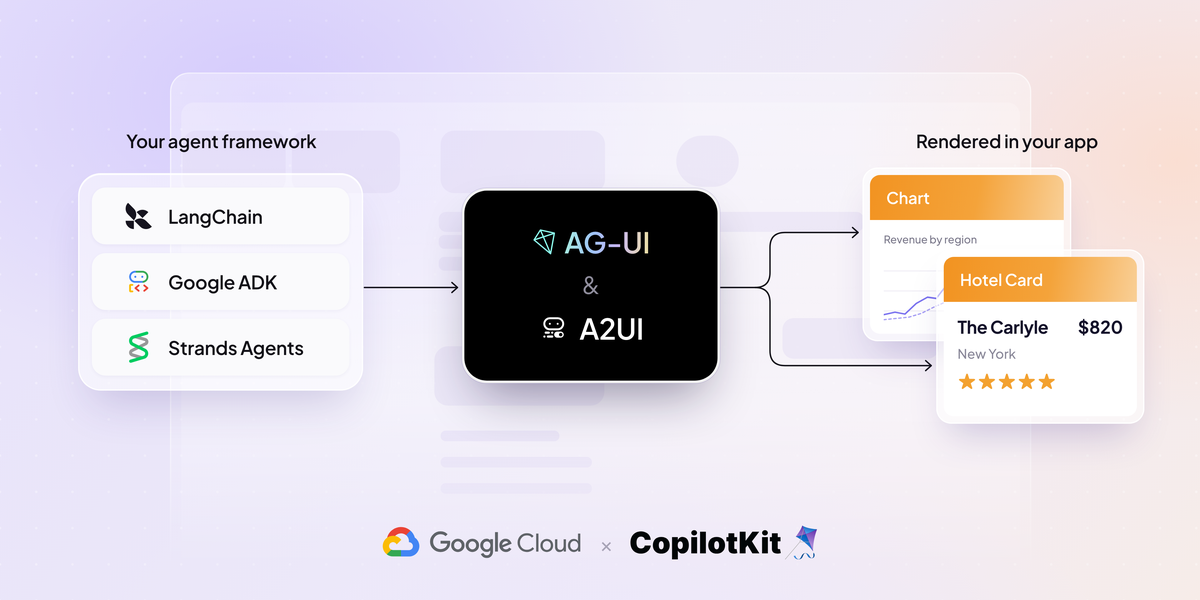
Google 推出 A2UI(Agent-to-UI)開放標準框架搭配 CopilotKit 整合棧,讓 agent 在執行時期動態產生豐富互動介面,支援 LangChain、AWS Strands、Microsoft agents 等多種 agent 框架。為什麼重要
A2UI 是宣告式資料格式而非可執行程式碼,客戶端維護受信元件目錄,確保安全。對開發 agentic 應用的工程師重要,提供跨框架、LLM 友善的 UI 描述標準,支援流式傳輸,簡化從對話到複雜互動介面的構建。

LiteRT 在 Google Play Services 中實現更快 GPU 推論與應用減容
LiteRT 整合至 Google Play Services 推出 CompiledModel API,透過 ML Drift 提供約 1.4 倍快的 GPU 推論效能,應用體積減少約 8 MB 並支援自動無縫更新。為什麼重要
每天處理超過一兆次推論。對開發 Android 應用且需在裝置上執行自訂 ML 模型的工程師重要。CompiledModel API 統一 CPU 與 GPU 加速工作流程,支援從 Android 7 到 Wear OS 4+ 及 Android Automotive,已在 Google 應用與 ML Kit API 規模驗證。

Microsoft Research Focus 第 97 期:編碼 agent、工作場景 AI 使用與天氣預報
Microsoft Research 分享三項新研究成果:ForkPilot 框架讓 agent 學習何時重新考慮早期決策、CABRA 框架用於生成編碼挑戰識別 agent 瓶頸、TeleTune 從使用者活動日誌學習可重用技能。為什麼重要
ForkPilot 在六個基準上減少 AI 運算需求達 59%;CABRA 發現 agent 在理解陌生程式碼方面困難最大;TeleTune 在軟體與瀏覽器任務上超越現有方法。對開發 agent 的工程師重要,提供如何改進 agent 可靠性與效率的實証研究方向。
Agents、MCP 與開發工具16 條

Granite Switch 4.1.1 — 像更新軟體一樣更新模型
IBM Granite Switch 4.1.1 發布,展示模組化 Switch 架構如何讓你在單一端點組態專門的、快取高效的適配器,新增多語言語音辨識和決策適配器功能。為什麼重要
重要性:模組化模型架構減少計算成本且加速更新迴圈,不需重新訓練基礎模型。適合需要快速迭代特定功能的團隊。新版本 ASR 模型支援 10 種語言,決策適配器改進效能。IBM 計畫推出 Adapter SDK 讓開發者建構自訂適配器,這將賦能第三方提供商快速發布更新。

Project ProtoStar:讓公開資助科學 AI 就緒
Hugging Face 與多所大學和研究機構合作啟動 Project ProtoStar,將公開資助研究的資料集、模型和程式碼轉換為 AI 可用的格式,首場挑戰賽 11 月 2 日開放報名。為什麼重要
重要性:解決科學資料散落、格式不統一的問題,讓 AI 系統更容易發現和整合跨學科資源。涉及美國聯邦投資 1,900 億美元的研究,NIH 和 NSF 已要求資料公開共享。適合從事科學 AI 和 RAG 的工程師關注如何準備和發布資料。
Mistral Large 4(Le Chonk)在 Hugging Face 上線
Mistral 推出 Mistral Large 4,一個 1T 參數、49B 活躍參數的多模態混合專家模型,支援 100 萬 token 上下文,在網路安全和程式碼代理中表現突出。為什麼重要
重要性:開放權重模型對做安全漏洞修復和惡意軟體分析的團隊至關重要,不受 API 供應商限制。相比閉源模型,Mistral Large 4 在 Artificial Analysis Cyber Index 測試中達 82% 準確率。提供多種推理引擎支援(Transformers、vLLM、llama.cpp)和 Hugging Face Inference Endpoints 部署。

AnySpeechRecognizer 和 AnyDecisionModel:Apple 平台的開放模型
Hugging Face 推出 AnySpeechRecognizer 和 AnyDecisionModel 兩個 Swift 套件,讓開發者在 Apple 設備上選擇語音辨識和決策模型引擎,包括 NVIDIA Parakeet、Alibaba Qwen3-ASR 等開放模型。為什麼重要
重要性:讓 iOS/macOS 應用能本地運行多個專門模型,無須依賴 Apple Speech 框架或單一 API。AnySpeechRecognizer 支援 25 種語言、說話者區分;AnyDecisionModel 處理是非、選擇、評分問題。開發者可從 Hugging Face Hub 下載模型,運行在 Core ML、MLX 或 llama.cpp。

Falcon:高效串流音視訊目標說話者萃取
Falcon 是因果音視訊目標說話者萃取模型,使用目標說話者的嘴部影像從雜訊重疊語音中萃取其聲音,相比 AV-TFGridNet 參數減少 91.9%、計算降低 20.2 倍、推理延遲降低 11.1 倍。為什麼重要
重要性:對做語音增強、會議轉錄、多人對話處理的團隊有用。論文提供 RealSSA 基準涵蓋多說話者、近遠場干擾、混響和突發雜訊。程式碼、模型權重、資料集和互動示例已開源,適合語音 AI 工程師參考。

OmniShowcase:從多視角影像產生全向一致性主體影片
OmniShowcase 使用幾何驅動訓練資料和表面法向量調節,從多個參考影像產生主體影片,維持 360 度旋轉時的 3D 一致性,並發布 Showcase-4K 訓練語料庫和評估集。為什麼重要
重要性:改進主體到影片生成,解決新視角合成中的 3D 一致性問題。自動化資料合成管道跨越 12 種相機運動、88 條軌跡配置。適合做視訊生成、3D 一致性模型的團隊。發布了資料集,可用於後續模型訓練。

感覺運動對齐:實體化策略成功的柏拉圖代理
Sensorimotor Alignment(S²)提出一個訓練無關的離線指標,衡量機器人模型的感覺表示與物理運動幾何的一致性,可預測機器人任務成功度。為什麼重要
重要性:對機器人基礎模型評估有用,提供低成本的離線代理避免昂貴的閉迴路試驗。S² 在模型族間與機器人任務成功正相關,也能評選 VLM 主幹在微調成視覺語言動作模型前的潛力。擴展柏拉圖表示假說至機器人領域。

RealCLI:CLI 代理人類協作統一評估
RealCLI 基準測試聯合評估 CLI 代理的任務執行和人類協作品質,涵蓋 22 個子維度和 51 個交互場景,揭示前沿代理在可操控性、信任校準和安全邊界管理的重大差距。為什麼重要
重要性:對開發命令行代理的團隊,提供實務中的真實任務評估框架。評估包括固定規格執行(RealCLI-EXEC)和漸進式使用者回饋協作(RealCLI-COLLAB)。最佳配置僅達 49.2% 執行分數、37.6% 協作分數,反映代理在交互品質上的嚴重欠缺。

TAO:LLM 代理服務的工具感知聯合排程
TAO 框架考量工具就緒性和快取信用,使用動態規劃優化 LLM 代理服務的工作流排程,降低延遲達 26.8%、減少首 token 延遲達 36.3%、提升解碼吞吐量達 29.5%。為什麼重要
重要性:對部署大規模 LLM 代理服務的團隊,解決 GPU 推理與分散式 CPU 工具交互的排程瓶頸。現有系統忽視工具回傳就緒性,浪費有限資源。TAO 的價值介面結合近期工具就緒、節點快取信用與時間衰減、token 足跡,在 12 種模型-工作負載-並發設定下達到顯著改進。

TauIndianBankBench:程序感知、動作導向工具使用對話代理評估
TauIndianBankBench 是 1,000 個印度零售銀行任務的基準,除了檢驗最終記錄,還驗證代理是否執行每個必需步驟且未做非請求變更,發現 6.5-12% 的會話跳過必需步驟卻被誤判成功。為什麼重要
重要性:對做金融領域對話代理、流程自動化的團隊。現有基準僅檢查最終結果,無法偵測程序遵循失敗。TauIndianBankBench 強調程序遵循同等重要,更準確反映 LLM 在受規約域的實務表現,適合需要嚴格流程控制的應用。

在推理 LLM 中分攤序列實驗設計
方法通過資訊增益獎勵顯式訓練推理來教 LLM 自適應資訊蒐集,在 Twenty Questions 和 Medi-Q 臨床對話基準上改進資訊獲取和任務性能,超越推理及訓練時貝葉斯實驗設計基線。為什麼重要
重要性:對做 LLM 代理、對話系統的團隊有用。教模型以資訊增益為目標主動提問、學習實驗設計策略。結果顯示資訊蒐集可作為可泛化的推理技能在 LLM 中學習,從 Twenty Questions 訓練正向遷移到真實臨床對話任務。

LongZero:從零資料增強 LLM 長文脈絡推理
LongZero 讓 LLM 自我改進長文脈絡推理,無需外部資料,方法是合成結構化多跳和檢索任務並用 GRPO 訓練,在五個長文脈絡基準上超越外部語料庫合成資料的基線。為什麼重要
重要性:對做 RAG、長文脈絡推理的團隊。解決 RL 訓練資料稀缺問題,方法新穎:先讓模型用結構化形式合成問題和答案,再展開為長多文件文脈絡。避免依賴外部語料或更強教師模型,可持續改進模型自身長文脈絡能力。

CausGround:實體化規劃的因果交互接地
CausGround 從交互經驗萃取可重用的動作前置條件和效果,改進實體化規劃和推理,無需重訓練模型即可跨環境適應,視覺規劃成功率從 24.9% 提升至 53.3%。為什麼重要
重要性:對做機器人規劃、具身 AI 的團隊。非參數因果交互接地框架捕捉動作在不同環境的前置條件和效果。在 VirtualHome、RoboCasa 和真實機器人操作上驗證,改進 MLLM 的長視界規劃和多步推理,實現環境無關的自適應。

DeepSeek V4.1 Flash-1017 安全評估:失控與有害操縱風險
獨立安全評估 DeepSeek V4.1 Flash-1017 在失控和有害操縱風險上有顯著改進,接近領先閉源模型,但建議部署時整合過程級可觀測性、增量安全測試和私密基準。為什麼重要
重要性:對部署開放權重前沿模型的團隊。評估涵蓋 34 個基準,包括 5 個內部測試套件,對比 V4.1 Flash、V4 版本及 GPT-6 Astra 等閉源系統。發現安全可在小版本更新間漂移或倒退,強調需將安全評估整合進增量發布、監控推理跡象和動作日誌。
MCP Servers v2.2.0 發布
Model Context Protocol 伺服器套件更新 v2.2.0,修補 eMudhra CA 憑證洩露和 Node.js 執行時高風險漏洞,提升八個伺服器套件的安全性。為什麼重要
重要性:對使用 MCP 伺服器(server-everything、server-filesystem、server-memory、server-sequential-thinking、mcp-server-fetch、mcp-server-git、mcp-server-time)做 Claude 或其他 LLM 整合的開發者。建議更新 Node.js 至 24.22.1 或 26.12.1 以上,certifi 至 2026.10.23 以上。伺服器本身未做出站 HTTPS(除 gzip-file-as-resource),主要仰賴執行時證書驗證。

CrewAI 1.15.33 版本發布
CrewAI 1.15.33 新增技能搜尋、Python flow 輸入支援與部署 zip 功能;修復 LiteLLM token 計量、JSON crew 載入、流程終端檢查等多項問題。為什麼重要
對使用 CrewAI 開發 Agent 應用的開發者重要。此版本改進了 Agent 流程管理、後向相容性支援、以及 token 使用追蹤準確性。修復涵蓋 JSON crew 格式支援、Python 3.12 相容性、登入流程穩定性等,總共超過 15 項修復與功能增強。
AI App、部署與雲端14 條
OpenMausBot:開源 AI Agent 聊天應用
開源專案,提供類似 Grok Bot 的 AI Agent 聊天介面。每個機器人可獨立運行 Claude 或其他模型,支援本機優先、帶有虛擬機環境,整合 500+ 應用工具。為什麼重要
適合想要自主部署多 Agent 應用的團隊。支援 macOS、Windows、Ubuntu,可自備 API 密鑰無需新帳戶。Agent 可調用隔離沙箱或本地虛擬機執行命令,同時模型憑證保留在主機側。開源協議為 Apache 2.0,無任何代幣相關。

AI SDK HarnessAgent 新增 fx 適配器
Vercel AI SDK 的 HarnessAgent 新增 fx 適配器,使用 libfx TypeScript 函式庫,簡化沙箱設置並內建工具過濾、中途操控指令等功能。為什麼重要
適合使用 AI SDK 開發 Agent 應用的開發者。模型憑證保留在主機,沙箱隔離檔案系統和殼層操作。新增結構化輸出、影像工具結果等能力,支援跨程序儲存和恢復會話。

Vercel Plugin 上架 Google Antigravity
Vercel Plugin 現已在 Google Antigravity 應用市場提供,為 Agent 提供 AI SDK、Vercel Functions、Workflow 等 API 指南。為什麼重要
讓 Antigravity Agent 能直接理解 Vercel 生態的最佳實踐。示例中展示 Agent 使用該外掛建置並部署 Python 後端到 Vercel Sandbox。

@ai-sdk/vue@3.0.319 發布
AI SDK Vue 套件補丁版本更新,依賴 ai@6.0.319。
@ai-sdk/zai@3.0.43 發布
AI SDK zai 套件補丁版本,更新依賴至 provider-utils@5.0.71 與 openai-compatible@3.0.81。
@ai-sdk/xai@5.0.33 發布
AI SDK xAI 提供者補丁版本,修正 reasoning 選項在多提供者間的一致映射,支援 OpenAI、Fireworks、Anthropic、Bedrock、Gemini 等模型的推理設定相容性。為什麼重要
針對使用多個 LLM 提供者的開發者。修正邏輯推理等級在不同模型間的映射規則,避免因模型不支援特定等級而發送被 API 拒絕的請求。受影響模型包括 GPT-6、grok-4.5、Gemini 3、Claude 等。
使用 Amazon Nova Act 構建意圖驅動的 UI 測試
Epsilon 採用 Amazon Nova Act 實現規模化意圖驅動 UI 測試,支援跨多個產品團隊的快速應用變更驗證,無需維護負擔。為什麼重要
適合有龐大應用組合的企業工程團隊。Epsilon 內部 Agentic Platform 團隊(50 人)建設共享基礎設施,讓其他產品團隊安全地建置、部署、治理 AI Agent。
使用 Kiro AI IDE 構建可重複的 PHP 到 Java 遷移引擎
Kiro 是 AI 整合開發環境,可自動化 PHP 到 Java 程式碼轉換,將一次性遷移轉變為可衡量的重複流程。為什麼重要
適合需要遷移遺產 PHP 應用的開發團隊。Kiro 配對 AI 與代碼分析,可掌握隱含在 Eloquent trait、XML 映射等處的業務邏輯,產生行為一致的 Java 程式碼而非結構相似但邏輯不同的版本。
AWS Batch 新增 SageMaker 訓練任務配額管理
AWS Batch 新增配額管理機制,讓多個團隊可以共享 GPU 資源,簡化跨團隊的 AI/ML 訓練工作排隊與調度。為什麼重要
適合規模化 AI/ML 運營的企業。團隊間可共借 GPU 容量配額,減少管理員協調與組態開銷,同時保持安全隔離與資源公平分配。
MoEngage 用 AgentCore Gateway 將 400+ 內部 API 轉化為 Agent 工具
MoEngage 藉由 AgentCore Gateway 將數百個內部私有 API 安全公開給 AI Agent,無需暴露公網、保護身份管理、避免上下文爆炸。為什麼重要
適合已有大量 API 生態的企業構建 Agent 系統。Gateway 解決 API 數量龐大時的工具定義負擔,同時確保模型無法濫用身份與存取控制。
在 Amazon EKS 與 SageMaker HyperPod 上部署 NVIDIA Nemotron 模型加速 Agent AI
NVIDIA Nemotron 3.5 Super VL(120B MoE 模型,每 token 激活 12B 參數)支援多模態理解與推理,已在 AWS EKS 與 SageMaker HyperPod 上線。為什麼重要
適合需要多模態推理與工具調用的 Agent 應用團隊。Nemotron 3.5 Super VL 可同時處理文字、影像、文件與影片,集推理與工具使用於一個模型。AWS 提供 EKS、EKS Auto Mode、SageMaker HyperPod EKS 等部署選項。
Ollama v0.40.13:LFM3 模型支援 Linux 和 Windows
Ollama v0.40.13 新增 Liquid AI 的 LFM3 模型(含文字轉語音的 lfm3-audio 和 lfm3-omni)在 Linux 和 Windows 平台的支援,過往僅限 Apple silicon。為什麼重要
這對在非蘋果硬體上跑多模態 LLM 的開發者很重要。LFM3 是具備語音能力的開源模型,支援跨平台部署能擴大使用場景,特別是對企業級部署和 Windows 使用者。
llama.cpp b11985:Metal 後端 MXFP4 推理效能最佳化
llama.cpp 加速 Metal 上 MXFP4 矩陣向量運算,並最佳化一元、二元、GLU 操作以使用完整執行緒群組(最多 256 執行緒),提升 GPU 利用率。為什麼重要
這對在 macOS/iOS 設備上部署量化模型的工程師重要。MXFP4 低精度格式結合執行緒群組最佳化能顯著降低推理延遲。硬體加速改進直接影響本機 AI 應用的響應性。
llama.cpp b11982:Hexagon DSP 新增 UPSCALE 操作支援
llama.cpp 在高通 Hexagon 處理器上新增 UPSCALE 操作支援,用於影像縮放,並優化了 2x、4x 最近鄰和雙線性插值演算法,支援 Qwen3-VL 等多模態模型。為什麼重要
對於在高通驍龍晶片上部署多模態 LLM 的行動應用開發者很關鍵。UPSCALE 操作優化讓視覺編碼更高效,而 Hexagon DSP 加速能大幅降低行動推理功耗。
中文與日文來源19 條

Zoho 強化台灣布局,主推 LLM 驅動的 Zia Chat 與 Agent 平臺
協作軟體公司 Zoho 推出企業級 AI 產品線,包括由 LLM 驅動的 Zia Chat、Zia Agents 代理平臺,以及整合 50 多款應用的 Zoho One 平臺,台灣市場營收去年成長 54%、已有千家企業導入。為什麼重要
Zia Chat 支援 ChatGPT、Claude、Gemini 和 Zoho 自研 LLM,使用者可在單一對話入口跨應用搜尋資訊與執行任務。Zia Agents 提供無程式碼/低程式碼開發環境,預建 Account Manager、SDR、HR、Customer Support 等代理可直接部署。重視隱私的企業應留意:這些資料不會用於訓練 Zoho AI 模型,且使用者僅能查看授權資訊。台灣客戶主要使用 Zoho Workplace、Zoho One 和 Zoho CRM。

GitHub 開源 AI 原型工具 Replica,結合 Copilot 與設計規範生成介面
GitHub 開源 Replica,讓設計師與產品經理透過 Copilot 以自然語言製作可操作的互動介面原型,能參考企業設計元件與規範確保介面一致性。為什麼重要
Replica 最大優勢是生成的 AI 原型能遵循企業既有的設計系統,不會產生風格不一致的介面。支援實時預覽與修改,團隊可自行架設 Replica Hub 協作平臺進行評論與版本管理。適合做 AI 驅動設計工具的產品經理與工程師,特別是需要快速迭代原型的團隊。支援 macOS 與 Linux,需安裝 Git、Node.js 等工具。

行動應用安全政策與技術持續演進,執行環境防護與白箱加密成重點
行動應用安全領域面臨新挑戰:政策規範日趨嚴格、國際測試標準更新、Google Play 代碼混淆要求提高,白箱密碼學成新防護技術焦點。為什麼重要
越南已將開機載入程式檢查納入行動銀行 App 法規;台灣金融業調查 8 大防護能力。OWASP 發布 MASTG 2.0 與 MASWE 1.0 標準。Google Play 2027 年 2 月要求 DEX 超過 10MB 的 App 達成 25% 的代碼混淆、最佳化與縮減。Digital.ai 新推 WBC Agent 整合白箱加密 API,並規畫支援後量子密碼演算法 ML-KEM、ML-DSA。做行動應用開發與資安的團隊應關注這些合規要求。
高雄打造城市 AI 大腦,從影像理解進階到事件推理,提早發現淹水與塞車
高雄市政府與 Nvidia、中華電信、鴻海等業者推動「AI 燈塔」計畫,導入視覺語言模型與推理模型,從被動通報轉向主動偵測道路坑洞、淹水、交通異常,並整合進市政流程。為什麼重要
計畫核心是從傳統影像辨識(看到什麼)進階至理解與推論(為什麼發生)。使用 VLM 分析攝影機影像,再用 Nvidia Cosmos Reason 2 模型推論事件原因。Smart Governance City(SGC)平臺串接 AI 判斷與各局處業務流程。實績包括:道路巡檢從發現到派工最快 2 分鐘完成;防汛應變中 AI 主動偵測的事件佔 52%;交通系統提前 14 分鐘發出路網異常告警。做城市智慧治理、IoT 與邊緣 AI 應用的團隊可借鏡。

AI 降低 App 逆向分析門檻,企業須強化程式碼混淆與伺服器端動態防護
AI 工具加速 App 逆向工程,Claude 可在 2 分鐘內重建簡易加殼 Android App 的 DEX 結構,攻擊風險擴及執行階段,企業需調整 AppSec 防禦策略。為什麼重要
逆向分析從靜態分析(2 分鐘重建 DEX)進階至動態 Memory Dump(34 秒取得完整程式碼)。87% 的 App 遭受攻擊,iOS 動態 Instrumentation 攻擊年增 10%。防禦重點改為強化深度程式碼混淆、類別加密,以及結合伺服器端風險評分系統(如累積 Root、Frida 檢測訊號後遠端決策處置)。做 App 開發與資安的團隊應從靜態 SAST、SCA 進一步加強發布後的執行期防護。
Google 推出 Connected Apps 平臺,第三方服務透過 MCP 整合 Gemini 與搜尋
Google 開放 Connected Apps Platform 預覽版,讓開發者透過 Model Context Protocol(MCP)將服務功能整合入 Gemini 與 Google 搜尋,目前已上線 50 多款應用。為什麼重要
開發者可部署雲端 MCP 伺服器或 Android AppFunctions API。Google Connected Console 提供註冊、連線設定、測試與審查流程。支援 OAuth 授權,通過審查後可查看流量、延遲與錯誤率。已有 Adobe、Experian、Peloton 等服務上線。做 Gemini 整合開發或想擴大產品觸及的開發團隊應掌握這個機會,需透過正式申請參與預覽版。

Tailscale 1.104.4 安全更新,修補 SSH 與 Serve 功能的 4 項漏洞
Tailscale 發布 1.104.4 版,修補 SSH 權限提升、記憶體耗盡、Serve 存取控制等 4 項漏洞,可能導致越權存取、主機接管或連線中斷。為什麼重要
SSH 權限提升漏洞:背景服務 tailscaled 以系統權限執行但缺乏登入帳號權限檢查,使一般帳號可存取 Docker、Tailscale 本機 API。Serve 漏洞讓修改配置的使用者能繞過限制。HTTP/2 存取控制漏洞可能混用不同服務權限。使用 Tailscale SSH 轉送或 Serve 的管理員應立即升級;暫時無法升級可先停用 SSH 轉送功能。遠端開發、DevOps 與基礎設施團隊應優先更新。
Nvidia 釋出 Nemotron 3.5 語音模型,整合轉錄、翻譯與講者辨識
Nvidia 發布開放權重語音模型 Nemotron 3.5 Transcribe,可轉錄 40 種語言、執行講者區分、翻譯及錄音問答,精度超越現有開放權重模型。為什麼重要
Nemotron 3.5 Transcribe 採混合專家架構,約 340 億參數、每次啟用 43 億。模型可處理 1 小時音訊、區分最多 8 名講者,詞錯誤率 2.8%。Nvidia 同時公開 Granary v2 多語言資料集(46.3 萬小時、48 種語言)及 NeMo Speech 微調工具,協助開發者針對專業領域微調。開發者可透過 vLLM 自行部署或選用第三方代管服務。
人類如何在 Claude Code 高產 PR 時代進行程式碼審核——責任與理解不放手
開發者在用 Claude Code 時每日收 23 個未審核 PR,發現無法逐行檢視所有程式碼,故改採自動檢查 + 有限度人工審核的策略,以機制守質量而非全部依賴人力。為什麼重要
Anthropic 在自身程式碼審核中,將約 90% 的讀取工作轉移給機器(自動化測試、linter、CI),人類集中於風險評估與最後把關。低風險改動(文件、特徵旗保護)人工審核數量少,高風險需 2 人承認。關鍵在於:責任所有人(提出指令的人)仍要負責,推遲檢查不等於逃避責任。6 月至 9 月 PR 增加逾 2 倍,差退率下降 40% 以上。

AIエージェント 受け渡しを固定したら何が変わったか——判断と実行の境界を引く實裝メモ
自製 AI 助手 Jarvis 將「思考角色」與「執行角色」分開後,關鍵不在模型能力,而在於固定交接格式、例外處理與決策邊界,使失敗可復現而非中斷。為什麼重要
每次依賴包含:任務名與目的、輸入對象、輸出位置、完成條件、失敗記錄方式。執行端遇到判斷需求時立即回報、不推測,以便思考端可重新補指令並恢復執行。記錄依賴與結果可對照,判斷是策略失誤還是指定不足。本方法來自人類協作原理,在 Agent 體系上也同樣有效。

ハーネスエンジニアリング 3 原則——地圖・強制・蓄積
Claude Code 等 AI 工具的運作遵循三層原則:地圖(CLAUDE.md 以 200 行內案內為主)、強制(Hook 只強制不變條件,不限實作手段)、蓄積(Skills 累積失敗經驗)。為什麼重要
三原則對應功能:① CLAUDE.md 與 docs/ 提供導航,詳細文件外推避免壓迫 context;② PreToolUse Hook 守護破損即出事的規則(如 .env 保護),實作方式留給模型選擇;③ Skills 紀錄每次失敗對應正確手順,隨著專案進行複利積累。初始化新專案時優先產生哈內斯結構而非應用本身。

副業成本最高的不是伺服器、是「試行次數」——Meta Muse Wonder 的 10 億 Token
個人開發的瓶頸往往是 AI Token 限額,頻繁修改設計與內容時餘額不足會止步。Meta Muse Wonder 新用戶可獲 10 億 Token(無期限),使試行次數不再受限。為什麼重要
Muse 是 Agent 型 AI,可在本機執行檔案操作、部署網站、定時監控,主動發現問題。相比聊天型 AI,更適合副業反覆迭代。10 億 Token 約等於數千本長編小說或數千次網站建立修改。啟用需在註冊 48 小時內設定中輸入邀請碼(邀請雙方各得 10 億 Token,限一次)。

聞き方を磨いた依賴文は 5 回中 1 回しか正解せず、素っ気ない一文は 5 回とも目標値に辿り着いた
實驗對比四種依賴文方式:優化聞法(5 回中 1 次正確)、素白一句(5 次全中)、直接貼資料(5 次全中)、僅指路徑(5 次全中)。結果表明提供資訊位置重於精心設計提示詞。為什麼重要
用架空運費表測試,依賴中僅提供資料位置的素白一句,模型會自行搜尋並 5 次都找到正解。優化依賴文反而因缺少明確資料線索,4 次被拒絕。進一步測試顯示:聞法磨練增加 137.6 token,資料貼直增加 102 token,後者更有效率。自力探索耗時 3 倍,本質差異在於讓 AI 主動尋找 vs. 被動接收。

AI Workflow 與 AI Agent 的差異:手順決策權與選用指南
Workflow 由開發者事先決定流程,Agent 依結果自主選擇下一步。選擇時須考量工程變化性、可驗證性與成本承受度。為什麼重要
Workflow 適用於工程固定(如分類 FAQ 後按路徑回覆);Agent 適合調查路徑隨輸入變化(如比較多個文件找差異)。設計時需清楚答案驗證基準與停止條件。兩者可結合:固定入出口、中間授權予 Agent。運用上應分離「完成」(有根據、通過檢查)「停止」(輸入缺失、超時)「失敗」(工具錯誤)三種終態。

Haiku 5.5 讀法不是「排名」,而是「能託付多少」
Claude Haiku 5.5 相比 4.5 性能躍進一個世代:GDPval 約 2.2 倍、OSWorld 從 15.7% 升至 72.4%,但 Terminal-Bench 與 Sonnet 仍有落差。為什麼重要
Haiku 5.5 入出力價格下降 90%,實際成本約降 75%。首次支援 effort 調整。小型模型當下適合:分類、抽取、摘要、context 壓縮、短期瀏覽器操作、Sub-Agent 層。長期規劃與複檔案編輯仍留 Sonnet。成本評估需含自動驗證與低成本重試的優勢。

中国国外から中国 LLM 呼ぶときのレイテンシ・安定性チェックリスト
越境呼用中國 LLM 時,往返延遲與套接層混雜。九點對策包括在正式環境測 TTFB/TTFT、啟用流傳輸、拆分逾時、精限重試、復用客户端、選擇經路、故障轉移與自記錄。為什麼重要
首 Token 遲延(TTFT)與穩定性主由越境路徑決定,非模型問題。測量 p50/p90 差異辨識經路穩定度。流傳輸讓使用者及早看到 Token;connect 逾時宜短,read 逾時為區塊間沈默上限。429/5xx/timeout 才重試,用指數補償+全抖。每行程共一客户端啟 keep-alive;多路由選項自測擇優,並配故障轉移。附 curl 測式與 Python 範例。

1 秒ずつ削ったら、50 秒が 5 秒になった——Claude Opus 與 Gemini Flash 的最適化記
Excel 加載項目更新(焙烤)從 45–57 秒縮至 4.7 秒,原因是逐段測量後消除往返、重複計算、冗余檢驗與固定開銷。為什麼重要
四類秒的來源:① 往返次數(讀屬性逐個呼叫數百次)② 重複工作(整理表後再整一次、測試前讀全模組再讀)③ 無用任務(試驗 25 項多數無獲、無修改仍複製試驗本)④ 固定手段(逐棵樹施工vs批次)。三本棚從 1.10 秒降至 0.16 秒只改呼叫方式。VBA 側亦同理:文字分割 62 萬次改為一次緩存。架構層見 stats --slow 名指最重環節,逐層剝洋蔥;驗證層含往返次數、重複檢查、實驗有效性。

團隊共享 AI 代理的設計:設置再利用與權限管理
團隊使用 AI 代理時,各自定義指令導致輸出不一,維護成本高。應分離公共設置(角色、制約、輸出格式)與任務資訊,並管理存取權限。為什麼重要
明確角色(如程式碼審核代理的五點檢查清單),分離公用設置與任務參數。共享設置不代表共享權限——API 金鑰、倉儲存取須個別管理。如 Sharkly.ai 提供 Personal/Space 層級,可管理代理可用性與 Jira 連動。部署前需驗證:輸出格式一致性、邊界遵守、檢驗可依據、權限限制、向後相容。

LM Studio 完整使用指南——從模型選擇到 API 伺服器與 CLI
LM Studio 是本地運行 LLM 的桌面應用,整理了模型選擇、量子化、記憶體估算、聊天介面、API 伺服器設定,以及與 Continue、Cline、Aider 等開發工具的整合。為什麼重要
對想在自己電腦上執行開源模型的工程師很有價值。文章涵蓋 0.4 版本的完整架構(llama.cpp、MLX、推論核心 llmster)、量子化選擇建議(迷茫時用 Q4_K_M),以及精確的記憶體需求公式與實測表格;強調 KV 快取對長對話的影響。支援 macOS(Apple Silicon 用 MLX)、Windows(NVIDIA CUDA / AMD Vulkan)、Linux,並已改為無償商用授權。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。