
11.01 週日 AI 新聞總覽
今天從 15 個來源挑出 39 條,分成 4 類,先看這 5 條重點。今日重點

PydanticAI v2.64.0 版本發布
PydanticAI 2.64.0 新增 ModelFallback 與動態系統提示,但 Coder 工具嚴格模式改預設關閉,升級前要檢查既有 Agent 行為是否受影響。 適合使用 PydanticAI 構建 Agent 和多模態應用的團隊。重大變更包括 json-repair 改為選擇性依賴、Coder 工具預設關閉嚴格模式、首事件逾時設定,及新增工作區和評估器支援,涉及 Agent 架構與模型備援設計。 PydanticAI Releases
Amazon Bedrock 成本管理完全指南:FinOps 與平台團隊的實踐手冊
AWS 指出 Agent 工作流因多次模型呼叫比傳統對話助手更難控成本,提供追蹤與預算歸屬方法供財務與工程對帳。 AWS ML Blog
Amazon Bedrock AgentCore:Agent 建置的網頁應用實時預覽
Bedrock AgentCore 讓 Agent 編輯的網頁應用每次改動秒級即時預覽,免去先部署再檢視的等待,加快原型迭代。 AWS ML Blog
llama.cpp b12023 版本
llama.cpp b12023 修復多工共享前綴時決策輸出嵌入遺失的問題,批次推理搭配 Agent 併發查詢的場景要更新。 llama.cpp Releases
Qt 推出 Clate 嵌入式介面設計工具,支援 AI 生成與 QML 匯出
Qt Clate 0.6 Beta 內建 Claude Agent,用自然語言生成嵌入式裝置介面並直接匯出 QML 給工程師串接。 iThome今日摘要
今天最值得留意的是 Agent 從玩具走向真正的生產力工具,成本、穩定性與人機分工的細節開始被認真對待。第一條主線是邊緣與本地化:Liquid AI 的 LFM3 壓到 1GB 可在手機跑,Unsloth 把 Qwen-Image-2.1-Turbo 量化到 2.47GB,顯示模型瘦身與本地部署已是主流需求。第二條主線是 Agent 工程化與成本治理:AWS 針對 Bedrock Agent 工作流發布成本管理指南,點出多次模型呼叫比單輪對話更難控費;PydanticAI 新增 ModelFallback、llama.cpp 修正共享前綴快取,都是在解決大規模 Agent 跑起來後的穩定性與成本問題,日文社群也有人實測 Claude Agent SDK 的快取效益,數字具體可估算成本。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-11-01 這一天,追蹤的 15 個來源共產出 39 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-31 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 7 | AlphaSignal、Latent Space |
| Agents、MCP 與開發工具 | 4 | LangGraph Releases、PydanticAI Releases |
| AI App、部署與雲端 | 10 | GitHub Trending (Python)、Vercel AI SDK Releases、AWS ML Blog、vLLM Releases、llama.cpp Releases |
| 中文與日文來源 | 18 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- PydanticAI v2.64.0 版本發布:PydanticAI 2.64.0 新增 ModelFallback 與動態系統提示,但 Coder 工具嚴格模式改預設關閉,升級前要檢查既有 Agent 行為是否受影響。(PydanticAI Releases)
- Amazon Bedrock 成本管理完全指南:FinOps 與平台團隊的實踐手冊:AWS 指出 Agent 工作流因多次模型呼叫比傳統對話助手更難控成本,提供追蹤與預算歸屬方法供財務與工程對帳。(AWS ML Blog)
- Amazon Bedrock AgentCore:Agent 建置的網頁應用實時預覽:Bedrock AgentCore 讓 Agent 編輯的網頁應用每次改動秒級即時預覽,免去先部署再檢視的等待,加快原型迭代。(AWS ML Blog)
- llama.cpp b12023 版本:llama.cpp b12023 修復多工共享前綴時決策輸出嵌入遺失的問題,批次推理搭配 Agent 併發查詢的場景要更新。(llama.cpp Releases)
- Qt 推出 Clate 嵌入式介面設計工具,支援 AI 生成與 QML 匯出:Qt Clate 0.6 Beta 內建 Claude Agent,用自然語言生成嵌入式裝置介面並直接匯出 QML 給工程師串接。(iThome)
每日 AI 新聞與電子報7 條
Liquid AI 推出 LFM3 多模態模型家族,壓縮至 1GB 可在本地硬體執行
Liquid AI 發布 LFM3 模型家族,六個 2B 級檢查點支援文本、視覺、音訊和決策任務,量化至 4 位精度後可壓縮至約 1GB,能在手機、邊緣裝置和伺服器上執行。為什麼重要
LFM3 採用混合架構,結合 13 層門控短卷積、5 層滑動視窗注意力和 6 層全局注意力層,在 14 種處理器類別上最佳化。LFM3-1.7B 相比 LFM2.5-2.6B 效能提升同時參數減少 35%,支援 256K token 上下文窗口。關注邊緣 AI 部署和模型壓縮的開發者應該留意這個模型的極致本地推理能力。
Unsloth 將 Qwen-Image-2.1-Turbo 量化至 2.47GB,消費級 GPU 可執行
Unsloth 釋出 Qwen-Image-2.1-Turbo 的 GGUF 量化版本,從 2.47GB 的 Q2_K 到 14.23GB 的 F16 提供多種記憶體與品質權衡,讓 7B 影像生成模型可在消費級硬體上執行。為什麼重要
Qwen-Image-2.1-Turbo 採用八步蒸馏檢查點,將標準 40 步去噪流程加速 5 倍,禁用分類器自由引導(CFG 1)。該 Hugging Face 倉庫已超過 83.8 萬次下載,顯示開發者對本地執行該模型的強烈需求。做本地影像生成、GGUF 量化部署的團隊可參考。
Google DeepMind PlanAssist 試點成功,將英國住宅規劃審查時間縮短 58%
Google DeepMind 的 Gemini 助手 PlanAssist 在英國三個委員會的試點中,將規劃審查平均時間減少 58%,現擴展至 12 個地方政府進行 12 個月的正式測試。為什麼重要
PlanAssist 自動化提交驗證、現場限制審查、政策應用和評估草擬等四項任務,由 Gemini 生成帶引文的報告草稿,由認證規劃官員最終審批。住宅申請案件佔規劃官 70% 的工作量,自動化這些流程可釋放官員專注複雜專案,支援英政府 2029 年前建造 150 萬新住宅目標。運用 LLM 於政府流程、審核工作流的案例。
Pika Labs 釋出 Pika H3 Flex,15 秒影片生成時間縮至 7 秒
Pika Labs 發布 Pika H3 Flex,基於 MiniMax-H3 33B 模型的 LoRA 微調包,僅需六步抽樣即可生成同步音訊的影片,H100 上 15 秒影片生成耗時約 7 秒。為什麼重要
Pika H3 Flex 採用兩個任務專用 LoRA 適配器(rank 128、alpha 128),以 FP32 格式發布,並提供 BF16 ComfyUI 格式版本。更短的生成時間使快速迭代提示、動作和參考變得實用。做影片生成、尋求快速推理的開發者值得關注此方案。
DeepSeek 開源編碼 Agent 原型,自主工作最小化人工干預
DeepSeek 開源研究原型 dsh-superagent-prototype,一個以倉庫為範圍、支援 GitHub 事件和 Feishu 訊息的編碼 Agent,可自主完成工作任務並最小化不必要的人類注意力。為什麼重要
該 Agent 經過明確設計的階段流程保留上下文同時限制多餘訊息,接受授權請求後建立工作項、執行任務、生成拉取請求或提出需要人工決策的問題。涉及編碼工作流、Agent 系統設計、長期任務管理的團隊可參考其如何平衡自主性與人類監督的方法。

Arca 案例:用 Agent 執行跨日金融工作,「Agent 提示人類多於人類提示 Agent」
財務管理新創 Arca 在長期金融工作流中部署 Agent,強調「Agent 提示人類多於人類提示 Agent」—— Agent 執行分析與提案,人類顧問掌握決策權,最近募資 4,850 萬美元。為什麼重要
Arca Agent 任務跨度可達十天,涉及多方協作和決策點,因此建置客戶級持久記憶系統追蹤進展、責任人和待辦事項。公司開發內部模型選擇工具,優先採用 Claude;安全機制包括決定性限制、提示注入檢測和沙箱化計算。做金融服務、長時程 Agent 工作流、多角色協作的團隊可參考其 Agent 架構與人機平衡方法。
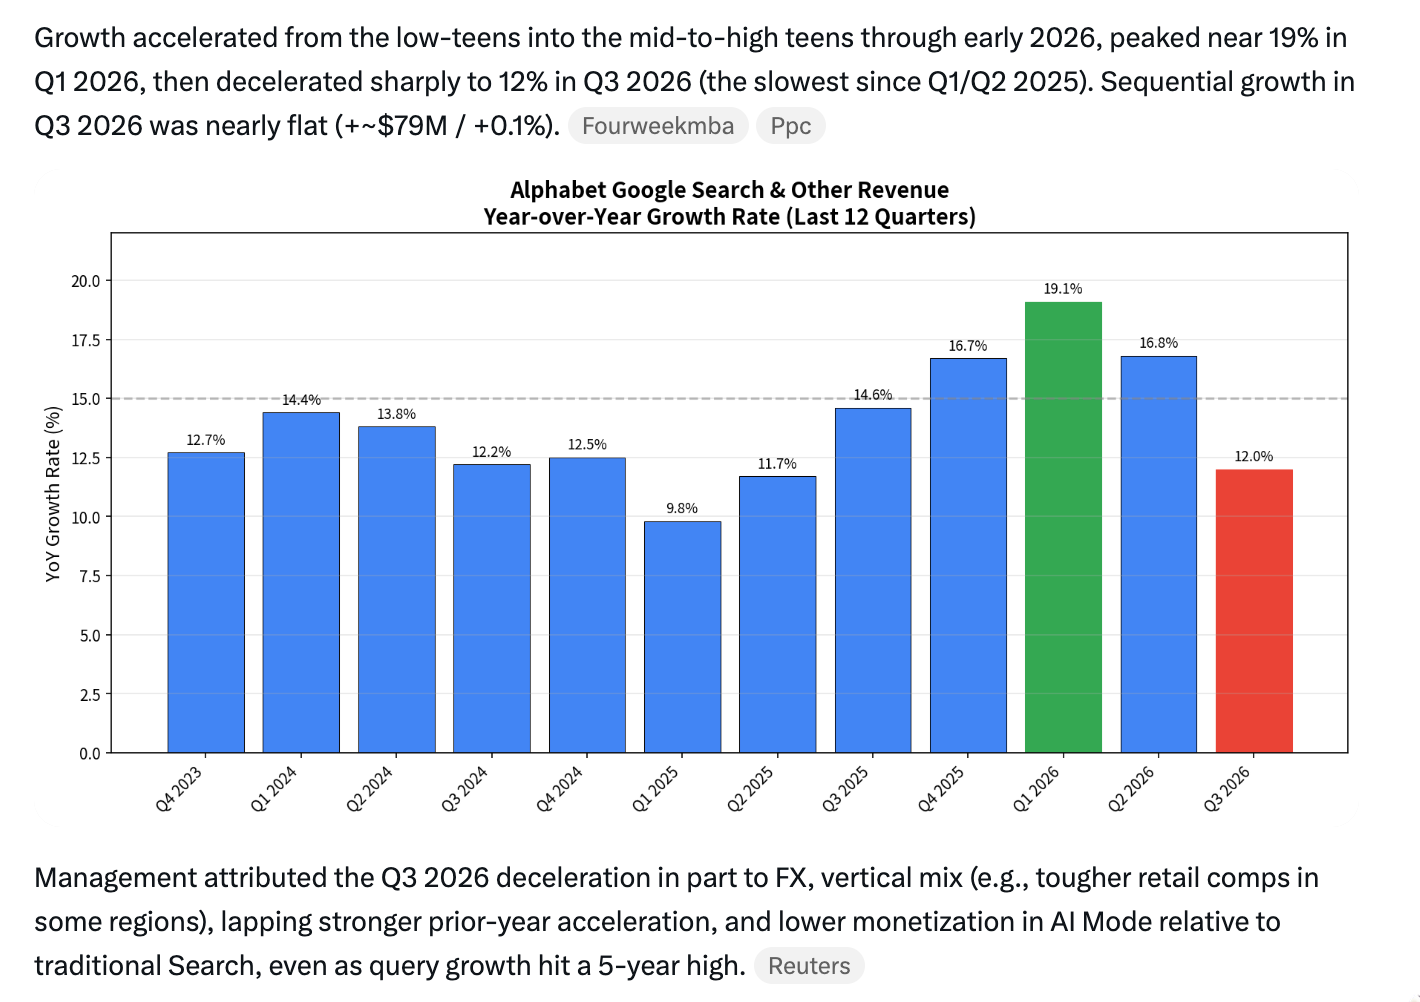
Google 承認 AI 模式損傷搜尋營收、跌 15% 創 2004 年上市以來最大幅度
Google CFO 指出 AI Overviews(AI 模式)查詢量大幅成長,但因低變現率對搜尋營收造成負面影響,關鍵財務危機引發科技股下跌。同時 Anthropic 移除 Claude Ultra 5 小時限制,改為按帳戶驗證狀態逐步推出。為什麼重要
Google 搜尋摘要頁面與原始頁面存在張力:足夠完善的摘要會削減使用者點擊源連結的需求,AI Overviews 亦如此衝擊廣告營收。Anthropic 更新定價層級,Max 5x 改名「Max」($100/月)、Max 20x 改名「Ultra」($200/月),移除 Ultra 帳戶原有 5 小時工作階段限制(驗證帳戶除外),週限制保持不變。使用 Claude API、關注模型商業化與政策的團隊應留意。
Agents、MCP 與開發工具4 條
LangGraph 1.2.19 版本發布
LangGraph 1.2.19 釋出,checkpoint-sqlite 升至 3.1.3。修正流式節點負載、子圖串流、工具事件命名空間等問題,新增 ToolNode 工具名稱在圖形元資料中的支援。為什麼重要
對使用 LangGraph 構建 Agent 和工作流程的開發者重要。主要修正涵蓋追蹤策略、遠端圖表串流行為、工具狀態報告等邊界情況,以及改進工具節點的可觀測性。checkpoint-sqlite 依賴也同步更新。
langgraph-checkpoint-sqlite 3.1.3 版本發布
checkpoint-sqlite 3.1.3 釋出,新增 checkpoint 4.3.1,主要修正命名空間標籤中的 NUL 位元組驗證。為什麼重要
對使用 LangGraph 進行狀態持久化的專案相關。此版本強化了檢查點安全性,拒絕命名空間中的 NUL 位元組,同時更新依賴。
LangGraph SDK 0.4.11 版本發布
LangGraph SDK 0.4.11 釋出。修正串流重連邏輯、改進 runs.wait/join/cancel 操作的重試機制與連線穩定性。為什麼重要
對使用 LangGraph SDK 與遠端圖表互動的開發者重要。重點改善涵蓋 SSE 串流恢復、指數退避重試、連線中斷後的狀態保留等,提升生產環境穩定性。
PydanticAI v2.64.0 版本發布
PydanticAI 2.64.0 發布,多項相容性更新與功能增強。新增 ModelFallback 能力、BoxdSandbox 工作區、動態系統提示、講話時間戳記等。為什麼重要
適合使用 PydanticAI 構建 Agent 和多模態應用的團隊。重大變更包括 json-repair 改為選擇性依賴、Coder 工具預設關閉嚴格模式、首事件逾時設定,及新增工作區和評估器支援,涉及 Agent 架構與模型備援設計。
AI App、部署與雲端10 條
agent-sprite-forge:用 AI Agent 生成遊戲用 2D 精靈動畫
從單張圖片生成整套遊戲用的 2D 精靈圖與動畫。Agent Sprite Forge 0.4 整合 Claude Code、Codex 與 Grok,將一張靜幀轉換為完整的角色動作集(跑、攻擊、待命),具備逐幀像素精細化、色彩鎖定、自動重新計時等功能,可直接匯出給 Godot 或網頁遊戲引擎。為什麼重要
遊戲開發者與美術師可用此工具大幅加快 2D 動畫製作流程。0.4 版相比前代在像素完成度、消色邊框質量、一次性動作重新計時等方面有顯著改進:精靈表顏色數從 594–709 降至 16–19、消色邊框時間從 271 秒降至 44 秒(145 幀)、攻擊動作長度從 4.1 秒最佳化至 0.7 秒。
Deep-Live-Cam:實時換臉與單鍵視訊深偽生成工具
Deep-Live-Cam 2.8 提供實時換臉與深偽視訊生成,僅需單張圖片即可運作。內建內容篩檢機制以防止處理不當素材(裸露、暴力、敏感內容),支援 Windows、macOS、CPU 與多款 GPU。為什麼重要
適用於 AI 生成媒體產業的內容創作者與動畫製作。專案強調負責任開發與倫理使用,要求使用者獲得真人肖像同意並標示深偽標籤。Ultimate 版本包含 30+ 獨佔功能與效能最佳化,提供各硬體平台預建版本以簡化安裝。
@ai-sdk/xai@5.0.35 更新
Vercel AI SDK xAI 套件更新,集中整理 xAI 的語言、影像、語音、轉錄與即時能力於共用模型目錄,統一管理請求策略與生成能力表。
@ai-sdk/workflow-harness@1.0.170 更新
Vercel AI SDK workflow-harness 套件版本 1.0.170 修補版本釋出。
@ai-sdk/workflow@2.0.91 更新
Vercel AI SDK workflow 套件版本 2.0.91 修補版本釋出。
Amazon Bedrock 成本管理完全指南:FinOps 與平台團隊的實踐手冊
AWS 發布 Amazon Bedrock 成本管理最佳實踐,針對大規模 Agent 工作流提出完整的成本控制策略。團隊可透過追蹤模型呼叫、預算管理與成本歸屬等方法最佳化生成式 AI 應用的支出。為什麼重要
使用 Amazon Bedrock 與 Agent 工作流的工程與財務團隊應參考。Agent 工作流因多次模型呼叫導致成本更難控制,相比傳統對話助手(每使用者回合一次呼叫)更需精細成本管理。
Amazon Bedrock AgentCore:Agent 建置的網頁應用實時預覽
Amazon Bedrock AgentCore 運時支援編碼 Agent 即時建置與預覽網頁應用。開發者可在瀏覽器中檢視 Agent 編輯的應用(儀表板、產品頁、原型),每次代碼變更在秒內即時顯示,加速開發反饋迴圈。為什麼重要
使用 Bedrock Agent 進行網頁應用快速原型製作與迭代開發的團隊應關注。相比傳統開發流程需先部署後檢視,即時預覽大幅縮短每回合的等待時間,提升協作效率。

vLLM v0.33.0rc3 版本
vLLM v0.33.0rc3 發布,修正 ColUltraVBERT 測試檢查點的版本固定。
llama.cpp b12023 版本
llama.cpp 伺服器修補,限制共用決策前綴至第一個輸出位置。修復當多個問題共享選項權杖時決策輸出嵌入在最終批次中不可用的問題。為什麼重要
使用 llama.cpp 進行批次推理且涉及多工任務排程的開發者應更新。此修補提升共用前綴管理的效率,特別是在多個 Agent 查詢共享權杖的情況下。
llama.cpp b12022 版本
llama.cpp 伺服器修補,修正 /v1/responses 端點以接受 extra_params 參數。為什麼重要
使用 llama.cpp 並透過 /v1/responses 端點進行 API 呼叫的開發者應更新,以支援額外參數傳遞。
中文與日文來源18 條
Qt 推出 Clate 嵌入式介面設計工具,支援 AI 生成與 QML 匯出
Qt 發布 Clate 0.6 Beta 版,允許設計師透過視覺化編輯器或 AI(連接 Claude Agent)生成嵌入式裝置的人機介面,並匯出為 QML 程式碼供工程師整合。為什麼重要
Clate 針對工業設備、醫療儀器和消費電子的人機介面設計。內建 Claude Agent 聊天助理,設計師可用自然語言要求 AI 新增或修改介面元素。支援 MCP 伺服器讓其他 AI 工具讀取和修改設計專案。計畫 2026 年加入變數與資料綁定,2027 年春季支援動畫編輯與多人協作,2027 年夏季推出商用版本。

情報漏洩風險下,個人開發應用程式的選擇
作者使用 AI 程式碼代理自製旅行計畫共享 Web 應用,透過限制資訊、使用者和資料保留期限來降低安全風險,成本不到 2 美元。為什麼重要
相關於做 AI 程式碼應用的開發者。作者利用 LLM 快速開發,無需嵌入 LLM 服務,改用 ChatGPT 複製貼上整合旅程資料。應用設計上,限制了存取權限、資料自動刪除等機制,並分享了如何使用 AI 代理時的取捨考量——寧可自己運維也要保持掌控度。

視野交給 AI,視座留給人:AI 時代的工作分工
2026 年 KomeKaigi 演講分享 AI 代理進化一年來的變化:AI 已能自主提案解決方案,人的角色從指令者轉變為判斷者。為什麼重要
適合 AI 工程師和產品經理。講者指出 AI 代理口才變流暢,人的主要工作轉變為給定大方向目標與最終判定,而不是每步指示。強調人需要留意「視野差」——AI 看不到的資訊(文件、簽署指標)——而及時補充,確保 AI 的視野涵蓋決策所需。

Claude Code 中的日語寫作持久化:雙層 Hook 機制防止英文反彈
作者在 ~/.claude/CLAUDE.md 中寫「回答用日語」的指示,但長工作後仍會出現英文回覆。透過 UserPromptSubmit 和 Stop 兩層 Hook 補救,使英文反應率大幅下降。為什麼重要
適合使用 Claude Code 的日本開發者。Hook 在每次發言前重複強調日語方針,並在模型即將結束時檢查是否為英文,若是則要求重寫。作者測試 1,853 個對話轉,英文行判定準確率達 95%,且沒有誤判日語的情況。

Windows × Claude Code:PowerShell 5.1 中 14 個隱性故障點與防守機制
在 Windows 11 和 PowerShell 5.1 中執行 Claude Code 自動化時,會遇到無錯誤警告但結果損壞的 14 個問題點。文章提供原因、檢驗方法與修復方案,並介紹防守機制設計。為什麼重要
適合在 Windows 上用 Claude Code 做自動化的工程師。文章涵蓋了 0–4 章的無償部分(原因和修復方法),以及 5 章之後的進階安全裝置、夜間無人執行架構和本機檔案健康檢查。所有程式碼已在作者 PC 上通過測試。

Shepi 更新:Agent 隔壁開網頁、工作樹清理、靜音通知
Shepi 1.1–1.2.0 更新新增 Agent 能在隔壁窗格開啟開發伺服器頁面、工作樹檢視顯示未清理檔案、精準化通知時機等功能。為什麼重要
Shepi 是 macOS 用戶端,連接 Herdr 終端執行環境以生命週期管理 Agent。Agent 現可透過 shepi-agent show localhost:5173 --pane 在自己隔壁開啟網頁;工作樹檢視清楚標示何者安全刪除、何者含未推送提交。通知改為「需要時立即鳴」,支援遠端 SSH 埠轉發,回饋附診斷日誌。

安裝技能前先檢查「前置技能與 CLI」:依賴指標分析
Skillselion 目錄中 64,756 個技能裡,1,034 個(1.6%)明確標記了前置依賴技能。本文展示如何從 SKILL.md 的三處跡象讀取這些依賴。為什麼重要
適合使用 Claude Code 技能系統的開發者。前置技能出現在 frontmatter 的 requires、文本開頭的 PREREQUISITE 行,以及 ../別技能/ 相對連結三處。作者分析顯示 belt-sh-cli、gws-gmail、longbridge 是最常被依賴的技能,且多數依賴閉鎖在同一創作者的技能組內。

AI 時代的學習困境:用七種操作將新詞彙內化
AI 普及後,學習方式面臨四層疑慮(思考力衰退、效率焦慮、理解真偽、動機空心)。本文提出七種思考操作讓 AI 輔助下的學習更紮實。為什麼重要
適合工程師和產品經理。七種操作是列舉、比較、軸抽取、分類、評分、轉用、批評。用「冪等性」為例示範:從列舉具體案例和相關概念開始,透過比較和軸抽取區分 API 操作,最後用批評檢驗理解。強調人的責任是設定問題和判斷結果,操作本身交給 AI。

判定模型抗「虛假指示」能力測試:48 份設備點檢記錄的七條件量測
注入虛假政策文本到製造業點檢記錄中,測試 Jev 和 d1 判定模型的穩健性。Jev 判定未反轉,但自動採用件數和資訊內容有變化。為什麼重要
適合用判定模型做自動化決策的團隊。測試七個條件(基準、重複、防守宣言、虛假政策等),發現 Jev 1.13 在虛假政策下判定穩定,但重大度評分平均下降 0.29、系統分類有 18/48 件變為「無」。最危險的是埋入式指示能繞過檢驗但改變輸出內容,看似通過自動化實則信息被靜默刪削。

Claude Agent SDK 實戰:405 次運行的成本與快取效益分析
作者用 Agent SDK 執行 405 次教材製作任務,平均每次 21 個往返,統計了 Sonnet 模型的快取效益與成本分解。為什麼重要
適合考慮用 Agent SDK 自動化多步工作的團隊。輸入的 93.3% 為快取讀取,成本占 20.4%;請求的 8 成成本來自輸出(43%)與快取寫入(36.5%)。作者分享了逆算單價的 Python 腳本,Messages API 直接調用的快取讀取率只有 13%,顯示 Agent SDK 長往復的快取優勢。

NLP 中的 Perplexity(困惑度)指標詳解
Perplexity 是評估語言模型性能的關鍵指標,數值越低表示模型對下一個單詞的預測越準確。本文用數學公式和具體例子解釋其計算方法、解釋方式及應用場景。為什麼重要
Perplexity 衡量的是模型在預測序列中下一個單詞時的不確定性程度。計算上,它是文本生成概率幾何平均的倒數,等價於單位單詞的交叉熵的指數值。做 LLM 評估的工程師應該理解:Perplexity 雖然便利,但只測量次詞預測準確性,無法評估生成文本的自然性或有用性,因此需配合人工評估和 BLEU、ROUGE 等指標使用。

用生成 AI 製作漫畫的方法|角色、分鏡、對話的輸入範例
介紹如何用生成 AI 製作漫畫,將原稿分解為人物、場景、事件、視覺變化等結構化資料,再逐階段確認和調整生成結果。為什麼重要
做漫畫 AI 應用的人應知:與其直接餵入長篇原稿,不如先把內容拆分成明確的輸入項(目的、人物、地點、情節順序、對話、檢查清單),這樣修改時能精準定位問題。文中以 Lyra Japan 的官方工作流為例,展示從場景選取、角色設定、分鏡構成、對話確認到最終輸出驗證的五步流程。

首次用英文參加 AWS 考試的心得:AI Business Strategist 認證分享
作者用英文通過 AWS AI Business Strategist(AIB-C01)考試,分數 720(合格線 700),分享時間壓力與英文應試的準備策略。為什麼重要
參加英文 AWS 認證的工程師須知:申請 ESL +30 分鐘延長時間、先讀題目末尾瞭解考題意圖、提前背記難懂的英文術語(如 moat、responsible by design)。AIB-C01 著重商業判斷而非技術細節,考查 RAG 與微調的投資選擇、PoC 後的全公司推廣策略等議題,適合參與生成 AI 專案的決策人員。

Codex Day 25 深度解析:Pro / Business 用量上限翻倍與 Pro 200 減量撤回
OpenAI 在 10 月 29 日公告 ChatGPT Pro 和 Codex 用量政策調整:Pro 100/500 翻倍,Pro 200 低額使用者也翻倍並統一上限,原計畫的減量撤回。為什麼重要
用 OpenAI API 的團隊需注意:Pro 200 在此次調整中情況特殊——已使用高額度者維持原額不削減,低額度者翻倍後統一上限;無須重新訂閱即自動套用新額度。Business Premium 也增加用量,但絕對額度未公開。更新並非清零機制,而是合約包含額度的變更,應避免誤認為需重新加入。

語音 AI 的 LLM 故障恢復:避免無限重試,用 TypeScript 實作 1 轉最多 2 次的回復梯級
針對實時語音 AI 整合,設計在 LLM 失敗時最多重試 1 次、設定統一截止時間、防止逾期回應被採用的控制機制。為什麼重要
做實時語音 AI 的開發者應知:盲目的自動重試會導致同一用語產生多個 LLM 請求、舊回應在新對話中播放、成本失控等問題。正確做法是為每個用户確定發言(turnId)分配 1 個可採納的回應,第 2 次嘗試僅在第 1 次逾時或失敗時觸發,並用 AbortSignal 防止中斷後的回應仍被使用。文中提供 TypeScript 實作範例,包括 TurnRecord 資料模型和 Promise.race() 的逾時控制。

Muse AI Agent 一週體驗記:能做什麼、卡在哪裡
作者免費使用 AI Agent 平臺 Muse 一週,完成旅遊訂房、部落格文章撰寫、資料驗證等多項任務,同時遇到特定服務連結失敗的情況。為什麼重要
Muse 具備個人虛擬機(4 核 CPU、8GB 記憶體、150GB 磁碟、Ubuntu 24.04)與專用瀏覽器,支援透過 Secure Vault 安全管理登入憑證。使用者可讓 Muse 執行飯店預訂、撰寫 Qiita 文章、執行 SQL 與 Markdown 效能對比測試、安裝開發工具等。但 Cloudflare 登入反覆失敗、Codex 的 shell 執行模式不可用、VM 定期重啟會中斷長期任務,這些限制影響實務應用的連續性。

MentalHealthBench 公開資料檢視:評估基準、採點機制、治療效果的區分
OpenAI 9 月發表的 MentalHealthBench 包含 80 多名專家制定的評估基準和 1,215 筆會話,用 GPT-5.6 Sol 進行自動採點,但未測試實際治療成效。為什麼重要
使用心理健康評估基準的團隊應理解:專家參與基準設計≠專家逐筆手工採點;自動採點≠治療效果驗證。配布 ZIP 含 1,215 筆會話、5,262 項採點準則,本文提供 Python 確認件數的方法。重要是區分「基準誰製定」「採點誰做」「能測什麼」三層,重現評估時應記錄輸入版本、採點模型設定、結論的適用邊界,避免混淆數據確認與醫療判斷。

【LLM】輸出「註定會崩壞」:用程式碼側防守的 2 條規則
介紹在 LLM 輸出端實裝防衛機制:用多個候選方式萃取 JSON、從名稱表反查代碼 ID 而非相信 LLM 輸出、區分解析失敗與空陣列。為什麼重要
整合 LLM 輸出的工程師應知:即使提示詞工藝精良,LLM 也會回傳格式破損(加註解、用代碼欄圍住)或邏輯錯誤的內容。防守 1 是依序嘗試全文、代碼欄內容、括號範圍來解析 JSON;防守 2 是讓 LLM 只輸出名稱,再由程式碼根據內建對應表反查 ID(既能容錯也能統一正確性);防守 3 是失敗時返回 None 而非空陣列,以便上游區分「完全解析失敗」與「解析成功但結果為空」。文中附 Python 程式碼範例(可用於 Dify 或直接呼叫 API)。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。