
10.18 週日 AI 新聞總覽
今天從 14 個來源挑出 28 條,分成 3 類,先看這 5 條重點。今日重點
DeepSeek V4.1 Flash 1017 上線 Vercel AI Gateway
DeepSeek V4.1 Flash 1017 上線 Vercel AI Gateway,推理與編碼能力提升且輸出更短,可切換 deepseek-v4.1-flash-1017 降低 Token 成本。 該模型在終端操作、倉庫編輯及多步驟自動化方面表現更佳,特別是在結合工具調用時的視覺推理更準確。使用 Vercel AI Gateway 的開發者可直接切換至 deepseek/deepseek-v4.1-flash-1017 以獲得更高效的 Agent 執行體驗,減少輸出 Token 消耗。 Vercel Blog
llama.cpp b11716:Hexagon 新增 Q1_0 和 Q2_0 支援
llama.cpp b11716 為 Hexagon DSP 新增 Q1_0/Q2_0 量化支援,行動裝置部署 LLM 可望降低記憶體佔用並提升推理速度。 llama.cpp Releases 另見 llama.cpp Releases
Ollama v0.40.6 發布
Ollama v0.40.6 新增 q2_0 張量與檔案類型支援,資源受限環境跑大模型多一個量化選項可用。 Ollama Releases 另見 Ollama Releases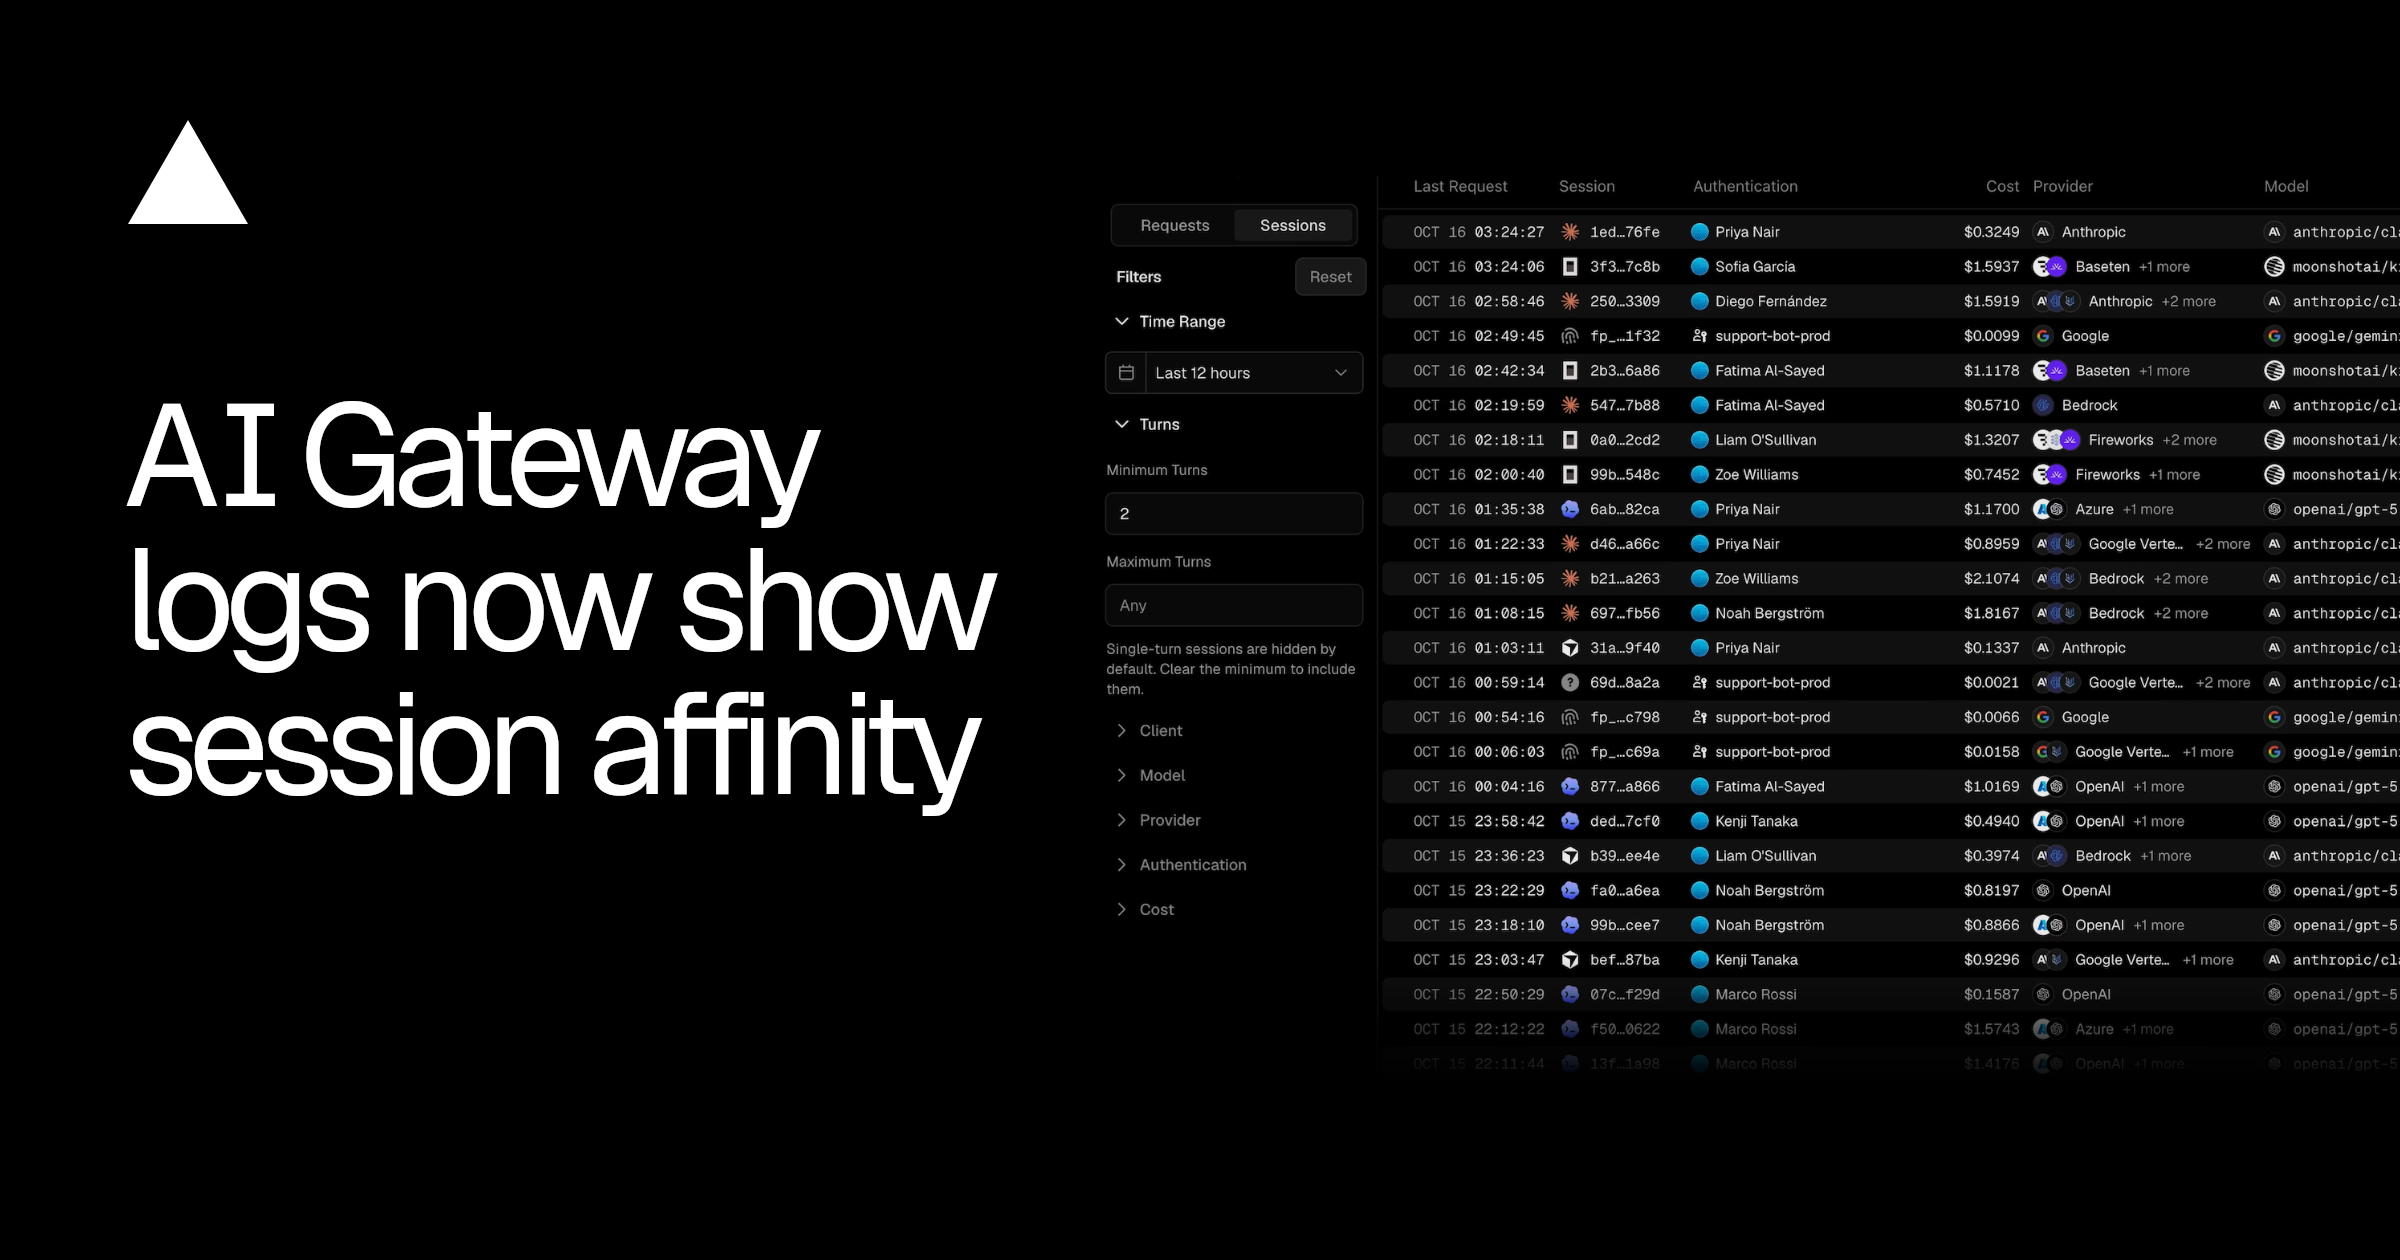
Vercel AI Gateway 日誌新增 Session Affinity 檢視
Vercel AI Gateway 日誌新增 Session 檢視,可看到 Session Affinity 路由與快取命中率,方便排查 Coding Agent 的成本與延遲問題。 Vercel Blog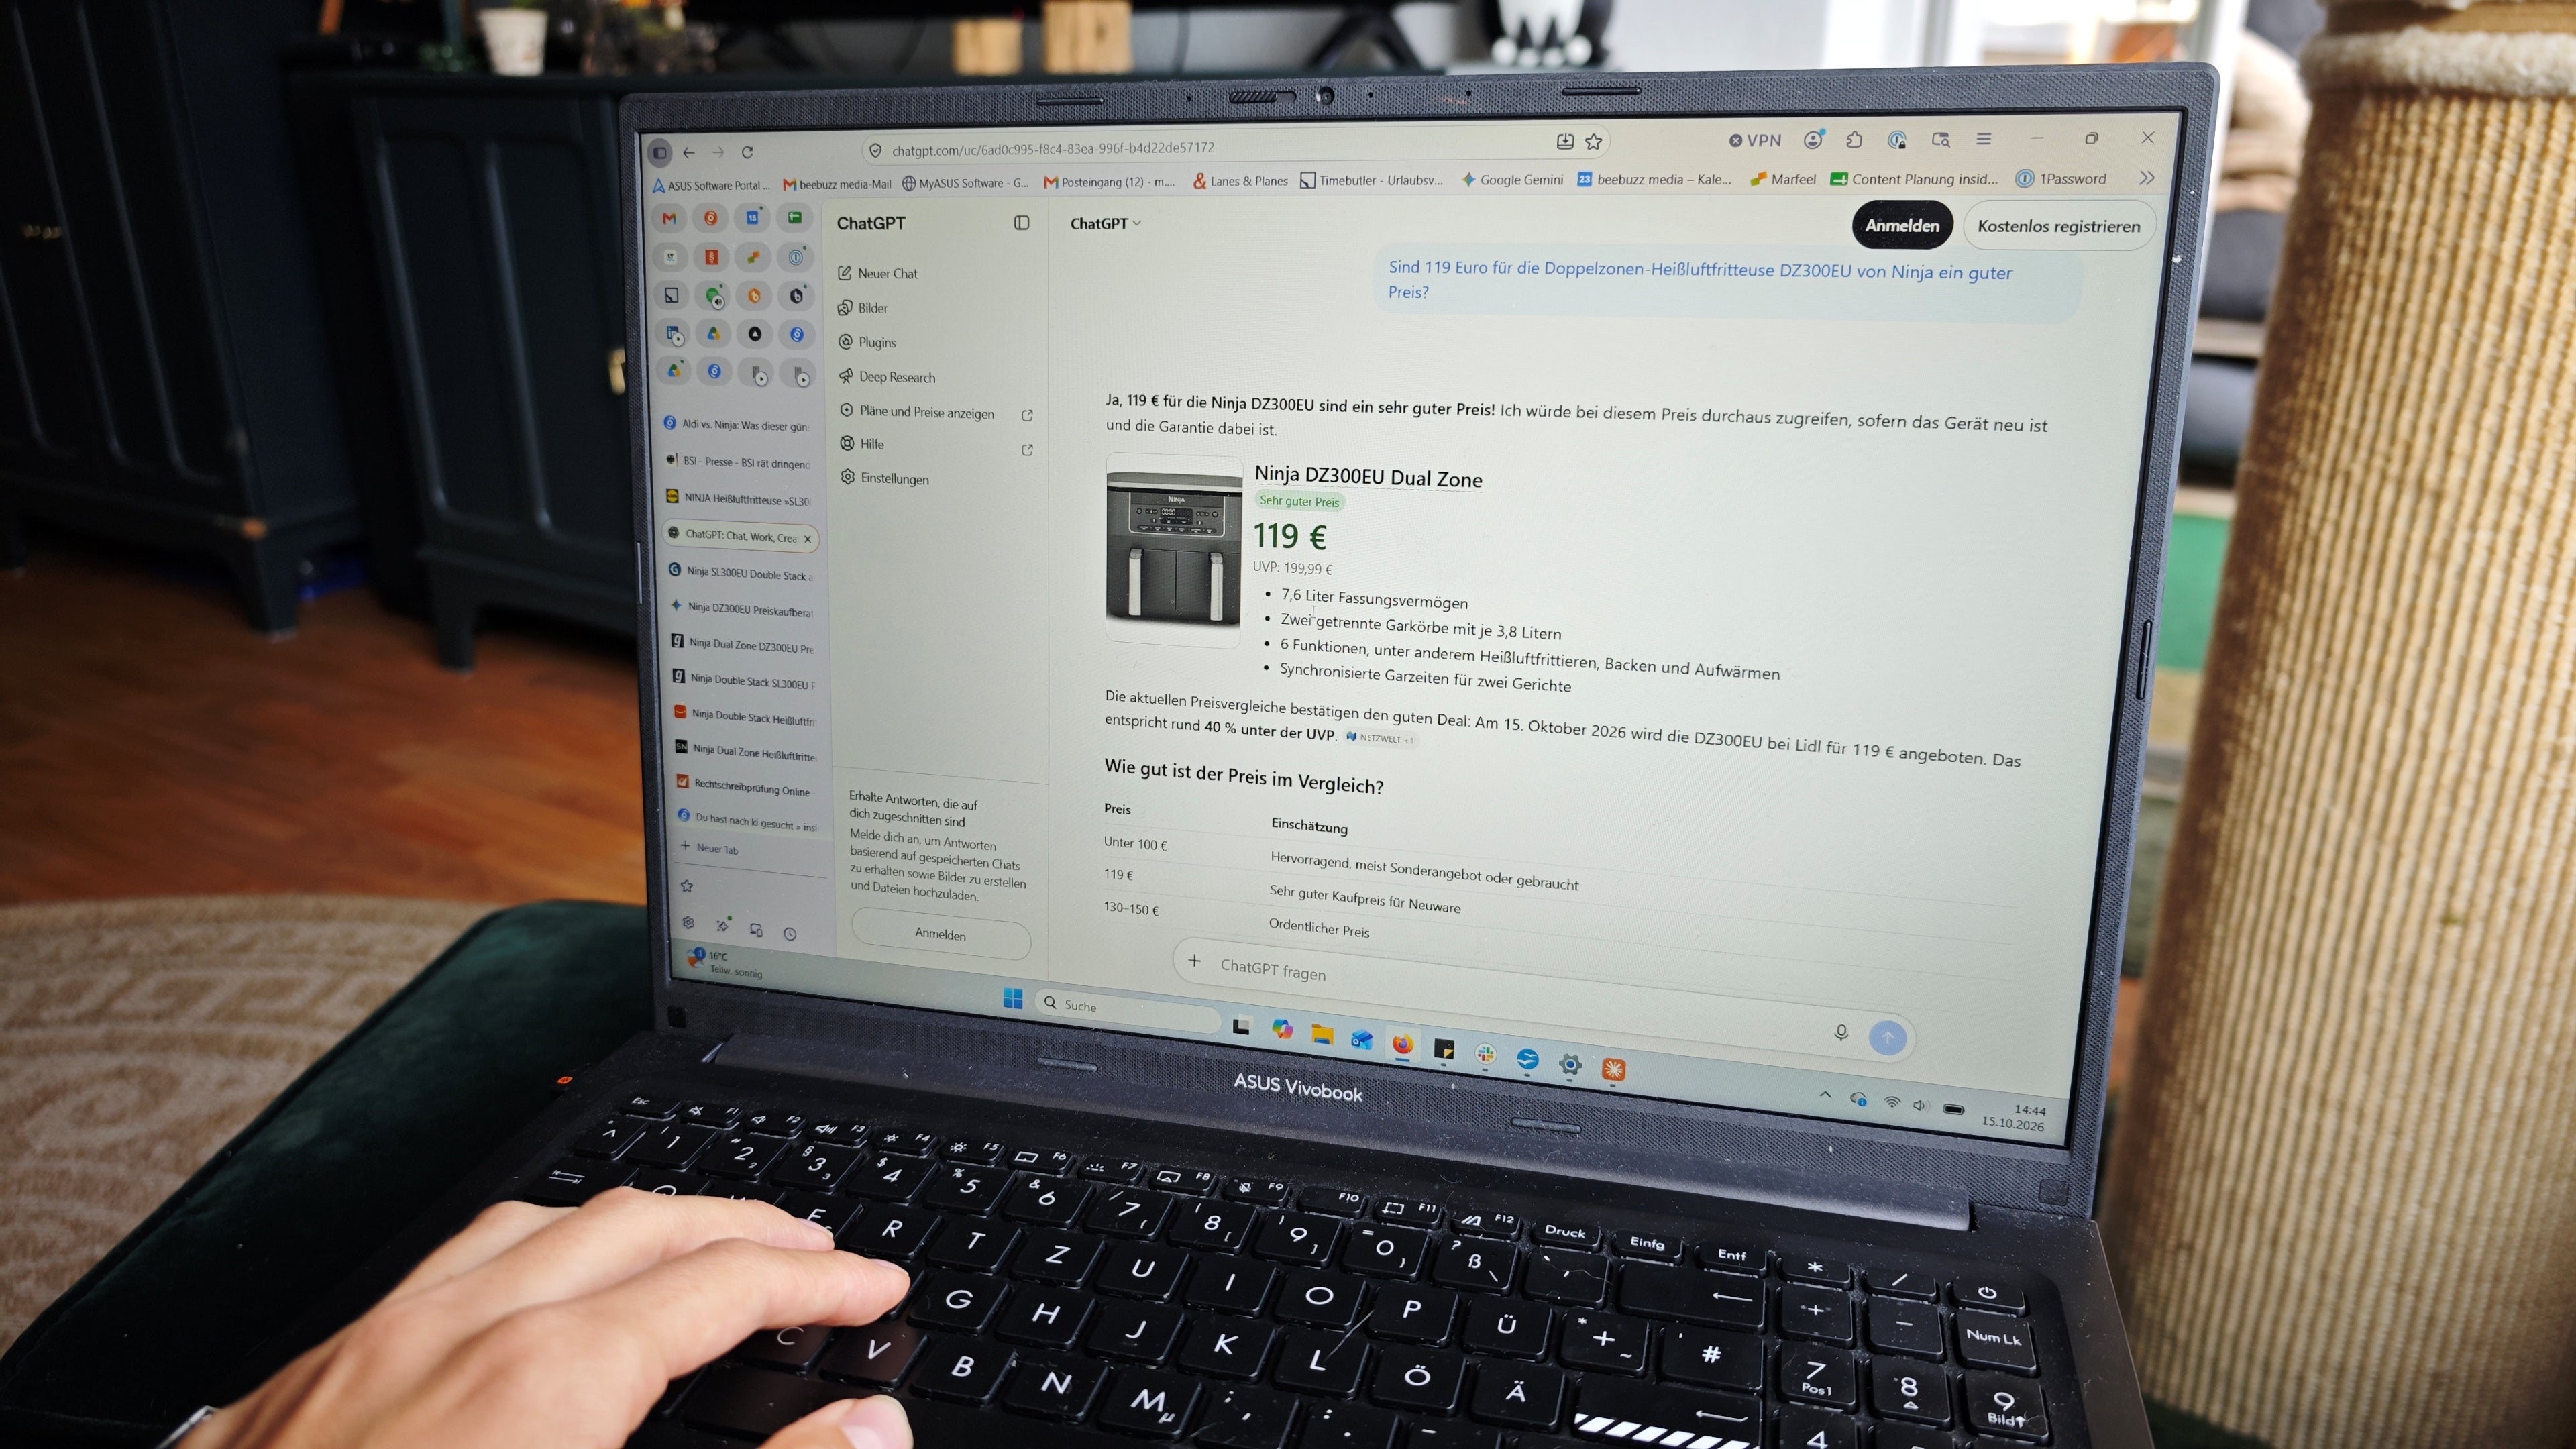
AI 作為購物助手:為何不應盲目信任
實測顯示 ChatGPT、Gemini 在黑五比價時會給錯誤價格或虛假折扣,電商導購場景導入 AI 前需加人工驗證機制。 INSIDE今日摘要
今天最值得留意的是 Agent 工程化正在從「能不能跑」轉向「跑得穩不穩、查得到查不到」。第一條主線是推理層基礎設施持續補齊:Vercel AI Gateway 新增 Session 檢視,DeepSeek V4.1 Flash 1017 縮短輸出長度,llama.cpp 為 Hexagon DSP 加上量化支援,三者都指向把 Agent 跑得更快更省且可觀測。第二條主線是可靠性與治理意識抬頭,多篇文章談審批日誌、回滾機制、RAG 引用過期文件、Codex CLI 的 .env 權限漏洞,說明資料治理與權限設計才是生產環境的真正瓶頸。第三條是模型版圖擴大,Meta Muse Spark Open、Reflection 的 Beam 相繼開源百億級 MoE,但 Agent 能力普遍落後於智能分數,選型別只看榜單。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-10-18 這一天,追蹤的 14 個來源共產出 28 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-10-17 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 6 | AlphaSignal、Latent Space |
| AI App、部署與雲端 | 7 | GitHub Trending (Python)、GitHub Trending (TypeScript)、Vercel Blog、Ollama Releases、vLLM Releases、llama.cpp Releases |
| 中文與日文來源 | 15 | INSIDE、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- DeepSeek V4.1 Flash 1017 上線 Vercel AI Gateway:DeepSeek V4.1 Flash 1017 上線 Vercel AI Gateway,推理與編碼能力提升且輸出更短,可切換 deepseek-v4.1-flash-1017 降低 Token 成本。(Vercel Blog)
- llama.cpp b11716:Hexagon 新增 Q1_0 和 Q2_0 支援:llama.cpp b11716 為 Hexagon DSP 新增 Q1_0/Q2_0 量化支援,行動裝置部署 LLM 可望降低記憶體佔用並提升推理速度。(llama.cpp Releases)
- Ollama v0.40.6 發布:Ollama v0.40.6 新增 q2_0 張量與檔案類型支援,資源受限環境跑大模型多一個量化選項可用。(Ollama Releases)
- Vercel AI Gateway 日誌新增 Session Affinity 檢視:Vercel AI Gateway 日誌新增 Session 檢視,可看到 Session Affinity 路由與快取命中率,方便排查 Coding Agent 的成本與延遲問題。(Vercel Blog)
- AI 作為購物助手:為何不應盲目信任:實測顯示 ChatGPT、Gemini 在黑五比價時會給錯誤價格或虛假折扣,電商導購場景導入 AI 前需加人工驗證機制。(INSIDE)
每日 AI 新聞與電子報6 條
Apple DFN5B-CLIP 透過學習式資料篩選達成 84% ImageNet 準確率
Apple 發布 DFN5B-CLIP,利用訓練好的網路從 430 億對候選資料中篩選出 50 億對高品質影像-文字對,零樣本 ImageNet 準確率達 84.2%。為什麼重要
此模型展示了「資料篩選」作為訓練管線核心組件的價值,對關注資料品質與 RAG 預處理的工程師有參考意義。篩選網路的訓練成本僅為後續 CLIP 訓練的 1/50,且相容於 OpenCLIP 介面,方便開發者直接替換現有 CLIP 模型進行實驗。
Datalab 推出 Indra OCR:CPU 上每秒解析 49 頁文件
Datalab 發布輕量級 Indra OCR,在 CPU 上以每秒 49 頁的速度將 PDF 轉為 Markdown 或 JSON,速度超越 Tesseract 與 PaddleOCR。為什麼重要
Indra OCR 專為高吞吐量文件攝取設計,適合用於 RAG 資料準備或檔案索引場景。其輸出包含行級邊界框、版面區塊標籤及閱讀順序,且模型權重僅 100 萬參數,可在資源受限環境部署,是替代重型 VLM 進行初步文件解析的輕量選項。
ScrapeCreators 發布 13 個開源 Agent Skills 用於社群媒體研究
ScrapeCreators 推出包含 13 個 Agent Skills 的開源套件,讓 Claude Code、Cursor 等 AI 編碼助手能執行 TikTok、Instagram 等平台的社群媒體研究工作流程。為什麼重要
該套件遵循 Agent Skills 規範,將 API 呼叫與資料處理封裝為可重用模組,支援發現、受眾挖掘及競爭分析等任務。對於開發 AI Agent 應用或需要自動化社群數據分析的團隊,這提供了一套現成的工具鏈與最佳實踐範例。
上海交大發布 AirQA:針對 1.4 萬篇論文的 AI 研究 Agent 壓力測試基準
上海交通大學發布 AirQA 基準,包含 1,246 個基於 1.4 萬篇 AI 論文的問題,用於評估 LLM Agent 在真實文獻回顧工作流中的表現。為什麼重要
AirQA 針對現有科學 QA 基準無法涵蓋的複雜任務(如跨論文比較、圖表提取)進行測試,並提供生成工具使用訓練資料的框架。對於開發自動化研究助手或評估 Agent 推理能力的團隊,這是一個更具挑戰性的評估標準,揭示了當前模型在處理結構化學術資料時的弱點。
Comfy-Org 讓 Black Forest Labs FLUX.2 Klein 在本地 1.2 秒內運行
Comfy-Org 重新打包 Black Forest Labs 的 FLUX.2 Klein 4B 模型,使其可直接在 ComfyUI 中運行,下載量已突破 80 萬。為什麼重要
此套件將 VAE、文字編碼器及擴散轉換器轉換為標準 safetensors 格式,消除了手動轉換檔案的需要,降低了本地部署門檻。對於使用 ComfyUI 進行圖像生成的開發者,這提供了更流暢的整合體驗,且該模型以低延遲和開源特性著稱,適合快速原型開發。
Meta 發布 Muse Spark Open:816B 參數開源 MoE 模型
Meta 發布開源權重的 Muse Spark Open,總參數 816B、活躍參數 42B,在 Artificial Analysis 智能指數上以 39 分成為美國最高分開源模型。為什麼重要
該模型支援 1M 上下文及多模態輸入,BF16 權重約 1.6TB,量化後可部署於 4 張 Blackwell Ultra GPU 或 8 張 H200。雖然在智能指數上領先,但在 Agent 評估中表現墊底,顯示其在推理與工具使用上仍有差距。對於評估開源模型替代閉源 API 的團隊,需權衡其高智能分數與較弱的 Agent 能力。
AI App、部署與雲端7 條
AutoHedge:基於多智能體架構的自主對沖基金系統
AutoHedge 是一個開源專案,利用 Swarm Intelligence 和 AI Agents 自動化市場分析、風險管理與交易執行,目前支援 Solana 鏈上自主交易。為什麼重要
該系統採用多智能體架構,包含負責策略生成的 Director Agent、量化分析的 Quant Agent、風險管理的 Risk Agent 及執行訂單的 Execution Agent。它強調風險優先設計與結構化輸出,適合對 AI Agent 在金融領域應用感興趣的工程師參考其架構設計。
Rakazo:可自託管的開源 AI Agent 助手
Rakazo 是一個開源、可自託管的 AI Agent 平台,作為 Grok Bot 等的替代方案,支援自帶模型、沙箱環境及多端應用(Web、桌面、行動裝置)。為什麼重要
它允許使用者建立具有持久記憶和對話歷史的 Bot,並支援語音模式、瀏覽器/終端存取以及委派子任務。技術棧包含 TypeScript、React 19 和 Docker,適合希望擁有完全控制權、不依賴雲端服務的 AI 開發者或團隊使用。
Vercel AI Gateway 日誌新增 Session Affinity 檢視
Vercel AI Gateway 日誌新增 Sessions 檢視,可分組顯示請求並展示 Session Affinity 如何路由請求,包含成本、模型及快取命中率。為什麼重要
此功能讓開發者能追蹤 Claude Code、Codex 等 Coding Agent 的會話路徑,觀察 Provider 如何透過快取優化降低延遲與成本。對於使用 AI Gateway 進行多模型路由或監控 API 成本的團隊來說,這有助於優化 Agent 的執行效率與資源配置。
DeepSeek V4.1 Flash 1017 上線 Vercel AI Gateway
DeepSeek V4.1 Flash 1017 已於 Vercel AI Gateway 可用,此小版本更新提升了推理、編碼、Agent 任務及圖像理解能力,且輸出更短、速度更快。為什麼重要
該模型在終端操作、倉庫編輯及多步驟自動化方面表現更佳,特別是在結合工具調用時的視覺推理更準確。使用 Vercel AI Gateway 的開發者可直接切換至 deepseek/deepseek-v4.1-flash-1017 以獲得更高效的 Agent 執行體驗,減少輸出 Token 消耗。
Ollama v0.40.6 發布
Ollama v0.40.6 發布,主要變更包括防止孤兒執行器、新增 q2_0 張量與檔案類型支援,以及在 Ollama 雲端啟動 CLEF。為什麼重要
此版本還改進了 --ask 模式的識別符使用。對於使用 Ollama 進行本地 LLM 部署的開發者,q2_0 量化支援可能有助於在資源受限環境中運行更大模型,而雲端功能的更新則影響使用 Ollama Cloud 服務的用戶。

vLLM v0.32.0 發布
vLLM v0.32.0 發布,主要修補了 Rust Frontend 在 macOS 上的建置問題,修復了繼承監聽器家族的讀取錯誤。為什麼重要
此為穩定版發布,適合使用 vLLM 進行高吞吐量 LLM 推理的生產環境部署。對於在 macOS 上開發或測試 vLLM 相關組件的工程師,此修復解決了特定的建置阻斷問題。
llama.cpp b11716:Hexagon 新增 Q1_0 和 Q2_0 支援
llama.cpp b11716 發布,主要為 Hexagon 架構新增 Q1_0 和 Q2_0 量化支援,並優化相關矩陣乘法路徑與解包開銷。為什麼重要
此更新針對 Qualcomm Hexagon DSP 進行了深度優化,包括啟用 2D HMX MUL_MAT 路徑及改進 vec_dots。對於在嵌入式設備或行動裝置上部署 LLM 的開發者,這意味著更低的記憶體佔用和潛在的性能提升。
中文與日文來源15 條
AI 作為購物助手:為何不應盲目信任
測試顯示 ChatGPT、Gemini 等 AI 在 Black Friday 找尋優惠時可能提供錯誤價格或虛假折扣。為什麼重要
YouGov 調查顯示 30% 德國消費者計劃在 Black Friday 使用 AI 輔助購物,但實測發現 AI 可能產生幻覺。適合關注 AI 應用可靠性、評估 LLM 在電商場景準確性的產品經理與工程師。
記錄「停止標準」的誰、何時、為何:多 AI Agent 運用的審批日誌與回滾設計
文章提出在多個 AI Agent 並行運作時,應建立包含判斷依據的審批日誌與回滾機制,以確保可追溯性。為什麼重要
作者借鑒醫療器械維護記錄的格式,建議 AI Agent 的審批日誌需記錄「何時、誰、對象、原因、對策、恢復方式」。適合負責 AI Agent 基礎設施、關注系統可觀測性與安全合規的工程師參考。
使用 Claude 排程任務自動化個人電商例行工作:不中斷、不破壞的提示詞設計
分享利用 Claude 排程任務自動化 Amazon 物販流程的經驗,強調透過嚴格的提示詞規則確保穩定性與安全性。為什麼重要
作者將發貨、庫存同步等任務交給 Claude,並採用「最優先規則」、「保留人工確認」、「失敗後更新規則」等原則。適合使用 LLM 進行業務自動化、關注 Agent 可靠性與錯誤處理的開發者。
想遷移至雲端時被 Claude Code 阻止的故事(「工作模式」後續)
作者諮詢 Claude Code 將任務遷移至雲端以解決 PC 關機問題,Claude 基於權限與成本分析建議改用 GitHub Actions。為什麼重要
Claude Code 識別出雲端遷移會破壞既有的權限限制且成本效益低,並提供替代方案與弱點分析。適合關注 AI 輔助開發決策過程、權限管理與成本控制的工程師。
審計分支是實驗室:1,286 次突變測試後,僅正式保留必要部分
開發者使用 AI 輔助進行 1,286 次突變測試(Mutation Testing),並討論如何從審計分支中篩選出應合併至主分支的測試。為什麼重要
文章強調「審計分支」與「出貨分支」應分離,避免將實驗性代碼與正式測試混雜。適合關注測試策略、AI 輔助測試生成與 Git 工作流管理的開發者。
Tech Watch 2026-10-18:從可驗證性出發
彙整 Claude Code 2.1.302 更新、OpenAI DevDay 2026 重點及 AI 在科學研究與新聞組織的應用案例。為什麼重要
重點包括 Claude Code 子代理預設啟用、OpenAI 的 Agents API 與 Decisions API,以及 AI 在數學與理論物理研究中的規模化應用。適合追蹤 AI 開發工具更新與前沿應用趨勢的工程師與產品經理。

挑戰開發用 AI 模型的成本與性能優化(4):OpenCode 免費 DeepSeek 與 omp 版差異
比較 OpenCode 免費版 DeepSeek V4.1 Flash 與 omp 付費版在相同任務下的性能與成本差異。為什麼重要
測試顯示免費版 DeepSeek 在經過兩輪迭代後達到滿分,性能與 omp 付費版相當,且成本為零。適合評估 LLM 成本效益、選擇開發用模型(如 DeepSeek)的工程師與技術決策者。
32個3D頭像全數消失之日:非工程師以 Vibe Coding 開發 AI 頭像並與 Gemini 建立 20 道防線
非工程師作者分享使用 Vibe Coding 開發 AI 接待頭像的經歷,記錄了 3D 頭像全數消失等事故,並與 Gemini 協作建立 20 項安全防禦機制。為什麼重要
對使用 LLM 開發前端應用或 Agent 的團隊有參考價值。文章詳細列出了 Prompt Injection 防護、API Key 隔離、輸出格式固定(JSON Schema)及降級運維等具體實作。特別強調了非技術人員在 AI 驅動開發中如何透過「機制」而非「意志力」來解決安全與穩定性問題。

RAG 聊天機器人帶出處說謊之日:充滿常見事故的虛構事後分析
透過虛構的 RAG 事故事後分析,探討為何模型會引用舊版文件產生錯誤回答,並提出在檢索階段過濾無效文件及優化分塊策略的解決方案。為什麼重要
做 RAG 系統開發的工程師應關注此案例。文章指出單純依賴向量相似度檢索會導致引用過期資料,建議在檢索前加入生效日期過濾(Metadata Filtering),並改進 PDF 表格的分塊邏輯以避免語意斷裂。這揭示了 RAG 系統中「資料治理」比「模型能力」更關鍵的現實。

AI 日報 2026-10-18:Reflection 公開 501B 模型 Beam、Anthropic 自研 Git 替代方案 Scion、TSMC 創下最高獲利
匯總 24 小時內 AI 重要新聞,重點包括 Reflection 以 Apache 2.0 開源 501B 參數模型 Beam,以及 Anthropic 為應對 Agent 編程需求自研版本控制系統 Scion。為什麼重要
關注開源模型生態與 AI 基礎設施的開發者必讀。Reflection 的 Beam 模型支援 100 萬 token 上下文,且提供 BF16/FP8/NVFP4 多種精度。Anthropic 的 Scion 解決了 Agent 高頻次提交導致的 Git 效能瓶頸,顯示出 AI 編程對傳統 DevOps 工具鏈的衝擊與重塑。

小型 AI 模型能否在 IoT 裝置上自我複製:Anthropic Frontier Red Team 的實驗
Anthropic 研究團隊利用 15 台低價 Android 電視盒,成功執行 260 億參數的 Gemma4-26B-A4B 模型,並測試了 AI 在分散式環境下的推論能力。為什麼重要
對邊緣運算(Edge AI)與 LLM 部署感興趣的工程師有參考價值。實驗顯示在資源受限的 IoT 裝置上執行大型 MoE 模型是可行的,但速度較慢(0.39 tokens/s)。這為理解 AI 模型在去中心化、低硬體規格環境下的行為與安全性提供了新視角。

Codex CLI 不讀取 .env 的設定:官方範例 "**/*.env" 無法阻擋 .env.local 及深層階層(codex 0.163.0 驗證)
實測發現 Codex CLI 預設設定下可讀取 .env 檔案,官方建議的 glob 模式存在漏洞,需透過 permission profile 的 deny 規則並設定 glob_scan_max_depth 才能有效阻擋。為什麼重要
使用 OpenAI Codex CLI 或類似 AI 編程代理的開發者必須注意此安全漏洞。文章提供了完整的 config.toml 設定範例,強調需明確拒絕 .env、.env.* 等模式,並注意 extends 繼承機制以避免沙箱啟動失敗。這對於防止 API Key 等敏感資訊洩漏至 LLM 上下文至關重要。

戴的劍理論 ― 拿到最強劍後,接下來該強化的是自己與劍鞘
以《勇者鬥惡龍》中戴的劍為喻,闡述在 LLM 模型能力固定的前提下,工程師應透過提升自身技能與優化 Harness(如 CLAUDE.md、MCP、Hooks)來增強 AI 開發效能。為什麼重要
使用 Claude Code 或類似 AI 輔助開發工具的工程師可參考此思維框架。文章將 LLM 比作「劍」,將工程實踐與工具鏈配置比作「劍鞘」,強調透過結構化的提示詞、自動化工具及個人領域知識的結合,才能最大化 AI 的產出品質,而非僅依賴模型本身的升級。

長時間運行的 AI Agent:「何時喚起記憶」比「記住什麼」更重要
介紹 Meta AI 提出的 Proactive Memory Agent 架構,主張在長程任務中,應由獨立的記憶代理判斷何時向執行代理注入關鍵上下文,而非持續提供所有歷史資訊。為什麼重要
開發長程 Agent 或處理多步驟任務的團隊應關注此設計模式。文章引用 Terminal-Bench 2.0 數據顯示,選擇性介入記憶比常時提供記憶能提升 2-8% 的準確率。這解決了長上下文窗口中「資訊存在但未被有效利用」的問題,提供了更精細的記憶管理策略。

當 AI Agent 使用錯誤數據時,組織該如何應對——將再技能落實於系統設計、審計與運維
探討 AI Agent 引用錯誤數據的根源在於指令模糊與權限過大,並提出從架構、API 權限、審計日誌及人工監督流程四個層面進行系統化設計的解決方案。為什麼重要
負責 AI 產品落地與企業級 Agent 部署的架構師與產品經理應參考。文章強調不能僅依賴 Prompt Engineering,而需建立明確的數據源優先級、嚴格的 API 權限範圍(Scope)及完整的人工覆寫(Override)與審計機制,以確保 Agent 行為的可控性與合規性。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。