
11.02 週一 AI 新聞總覽
今天從 12 個來源挑出 27 條,分成 3 類,先看這 5 條重點。今日重點

vLLM v0.33.0 發佈
vLLM v0.33.0 版本更新,這是高效能 LLM 推論伺服器的新版本。 vLLM Releases
llama.cpp b12032:SYCL 後端改進
llama.cpp b12032 釋出,改進 SYCL 後端對 LevelZero includes/libs 的 PkgConfig 支援。提供 macOS、Linux、Android、Windows、openEuler 等多平台預編譯版本。 llama.cpp Releases
llama.cpp b12031:OpenCL 量化支援擴展
llama.cpp b12031 釋出,新增 OpenCL iq3_s 與 iq3_xxs 量化格式支援。包含多種矩陣運算變體(AOS/SOA)、Adreno GPU 最佳化及不同批次寬度適配。 llama.cpp Releases
HPE 宣布網路平臺整合時程:透過 AI 驅動自動駕駛網路
HPE 整合 Aruba Central、EdgeConnect、Mist 三大網路平臺,採用統一的代理式 AI 框架。2026 年底前 Mist 支援 EdgeConnect,2027 年上半年 Aruba Central 也將支援,實現自動駕駛網路與資安自動化。 iThome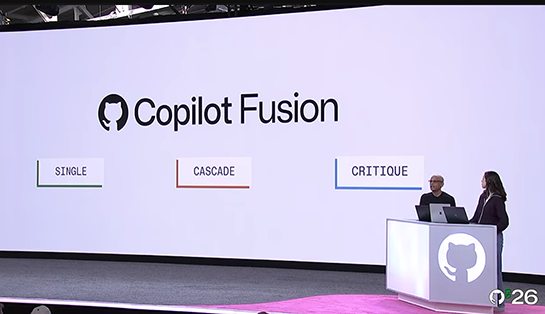
GitHub Copilot Fusion 正式推出:多模型自適應選擇提升開發效率
GitHub Copilot Fusion 於 GitHub Universe 2026 發表,根據任務特性自動選擇或組合多個 AI 模型,提供 Single、Cascade、Critique 三種執行模式及 Standard/High/Max/Fast 四級負載等級。 Publickey今日摘要
推理層的部署優化是今天真正的主線:NVIDIA 將 DeepSeek-V4.1-Flash 做 NVFP4 量化,475GB 砍到400GB 且六項基準幾乎零損失;llama.cpp 連發兩版補齊 OpenCL 量化格式與 SYCL 後端,強化 Adreno GPU、Qualcomm 行動端相容性;vLLM 也同步推出新版本。這說明大模型能否落地,現在拼的是量化與推理後端的工程細節,而非單純比參數量。第二條主線是 Agent 協作與工具鏈標準化,GitHub Copilot Fusion 把多模型自動組合做成產品功能,加上多篇文章談多代理協調、自主研究代理與指令輸入分離等工程實踐,顯示 agent 開發正從「能跑」進入「可控、可調試」階段。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-11-02 這一天,追蹤的 12 個來源共產出 27 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-11-01 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 5 | AlphaSignal |
| AI App、部署與雲端 | 5 | GitHub Trending、vLLM Releases、llama.cpp Releases |
| 中文與日文來源 | 17 | iThome、Publickey、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- vLLM v0.33.0 發佈(vLLM Releases)
- llama.cpp b12032:SYCL 後端改進(llama.cpp Releases)
- llama.cpp b12031:OpenCL 量化支援擴展(llama.cpp Releases)
- HPE 宣布網路平臺整合時程:透過 AI 驅動自動駕駛網路(iThome)
- GitHub Copilot Fusion 正式推出:多模型自適應選擇提升開發效率(Publickey)
每日 AI 新聞與電子報5 條
DS Bot:DeepSeek Harness 上的持久化 AI 智能體團隊
DS Bot 是 DeepSeek Harness 的開源插件,版本 0.2 預覽已達 4,600 星。它將 Harness 轉化為具有記憶、群組聊天、任務委派的長期運行智能體團隊。為什麼重要
對於構建多智能體協作系統的開發者有參考價值。DS Bot 提供本地應用層與持久化資料儲存(~/.dsh),但模型推理依賴配置的遠端提供者。核心特性包括專門角色(寫手、程式設計師、幕僚長)與由 Chief 協調的群組工作流,支援 @mentions 任務委派。
OpenGVLab InternVL2-1B:低於 2GB 超越更大 4B 視覺模型
OpenGVLab 發布 InternVL2-1B,一個 9 億參數的視覺語言模型,在邊緣設備上執行 OCR、文件分析、影像定位與影片問答,效能可匹敵 2B–4B 模型。為什麼重要
適合在邊緣裝置、低延遲服務部署的開發者。模型結合 300M 視覺編碼器與 Qwen2-0.5B 語言模型,透過圖像分割成最多 12 個 448×448 磁貼保留細節。支援多影像對話與影片幀分析,儘管語言模型容量有限。
NVIDIA DeepSeek V4.1 Flash NVFP4 量化:減少 75GB 幾乎無質量損失
NVIDIA 發布 DeepSeek-V4.1-Flash-1017 的 NVFP4 量化版本,將模型大小從 475GB 縮減到 400GB,六項基準測試分數變動不超過 0.70 分。為什麼重要
對於部署大型 MoE 模型的團隊重要。量化策略集中在 384 個路由專家的 W4A4 權重與啟用,同時保留注意力層、共享專家與視覺組件的原始精度。模型支援 100 萬 token 上下文視窗,Blackwell GPU 上透過 vLLM 運行。
Qwen3.5-4B Heretic:削減 87% AI 拒絕而不損害基準
Qwen3.5-4B-heretic 是社群改進版本,透過 Heretic 2.0 工具進行權重編輯,將拒絕行為從 99 降至 13(百分制),最小量化版本僅 2.71GB 可在筆電本機執行。為什麼重要
對於需要客製化模型行為的開發者有參考價值。Heretic 使用任意秩消融(ARA)技術識別並抑制啟用空間中與拒絕相關的方向,同時保留基準測試表現。編輯涵蓋第 15–27 層,執行時間約 45 分鐘,視覺編碼器保持不變。
OhMyGame:將任何開發者轉變為完整 AI 遊戲工作室
OhMyGame 是開源 Electron 應用程式,整合遊戲設計、媒體生成、程式碼撰寫、遊戲測試於一個 AI 智能體工作流中,已累積 931 GitHub 星。為什麼重要
適合獨立遊戲開發者與想探索 AI 輔助遊戲開發的團隊。工作流支援從設計文件、美術資源生成到程式碼實現與即時預覽測試的完整週期。專案基於標準檔案結構(Markdown、JSON、網頁專案),AGENTS.md 與 JSON 綱要定義智能體與編輯器的交互方式。
AI App、部署與雲端5 條
Handy:開源離線語音轉文字應用
Handy 是免費開源的跨平台桌面應用,支援離線語音轉文字。使用 Whisper 或 Parakeet V3 模型進行轉錄,所有處理在本機進行,無需上傳音聲到雲端。為什麼重要
適合重視隱私、需要即時轉錄的開發者與產品團隊。應用整合 VAD(Voice Activity Detection)過濾靜音,支援 Windows、macOS、Linux 三平台。可配置快速鍵觸發錄音,轉錄結果直接貼入任何文字欄位,GPU 加速可用。
Kornia:可微分電腦視覺函式庫
Kornia 是基於 PyTorch 的幾何電腦視覺函式庫,提供 1200+ 可微分影像處理與幾何演算法。支援批量轉換、自動微分、GPU 加速,應用於影像增強、相機模型、RANSAC 等任務。為什麼重要
對做影像處理、3D 視覺、空間 AI 的工程師重要。核心優勢包括:支援每樣本參數的批處理、可微分幾何運算(深度轉 3D、pose 估計)、GPU 端 RANSAC 實現。v0.9.1 起在 CUDA/MPS 上無主機同步開銷。
vLLM v0.33.0 發佈
vLLM v0.33.0 版本更新,這是高效能 LLM 推論伺服器的新版本。
llama.cpp b12032:SYCL 後端改進
llama.cpp b12032 釋出,改進 SYCL 後端對 LevelZero includes/libs 的 PkgConfig 支援。提供 macOS、Linux、Android、Windows、openEuler 等多平台預編譯版本。為什麼重要
適合在異構硬體上部署 LLM 的工程師。本版本強化跨平台編譯支援,提供 CPU、CUDA 12/13、ROCm 10.0、Vulkan 等多種加速後端的二進位檔案。
llama.cpp b12031:OpenCL 量化支援擴展
llama.cpp b12031 釋出,新增 OpenCL iq3_s 與 iq3_xxs 量化格式支援。包含多種矩陣運算變體(AOS/SOA)、Adreno GPU 最佳化及不同批次寬度適配。為什麼重要
對在行動裝置與邊緣設備運行 LLM 的開發者重要。本版本強化 Qualcomm Adreno GPU 適配,支援 dp4a 指令與記憶體配置最佳化,擴展 llama.cpp 的量化模型硬體相容性。
中文與日文來源17 條
HPE 宣布網路平臺整合時程:透過 AI 驅動自動駕駛網路
HPE 整合 Aruba Central、EdgeConnect、Mist 三大網路平臺,採用統一的代理式 AI 框架。2026 年底前 Mist 支援 EdgeConnect,2027 年上半年 Aruba Central 也將支援,實現自動駕駛網路與資安自動化。為什麼重要
HPE 透過整合 2015 年併購的 Aruba Networks、2020 年的 Silver Peak、2024 年的 Juniper Networks,將有線、無線及 SASE 解決方案納入 AI 框架。此舉對於需要統一網路營運與資安的企業團隊重要。EdgeConnect 新增 SSE 連接器、零信任存取、內建防火牆、IDS/IPS 等資安功能。Mist 與 Aruba Central 整合後,支援 Marvis AI 引擎驅動的根本原因分析與自動修復。
GitHub Copilot Fusion 正式推出:多模型自適應選擇提升開發效率
GitHub Copilot Fusion 於 GitHub Universe 2026 發表,根據任務特性自動選擇或組合多個 AI 模型,提供 Single、Cascade、Critique 三種執行模式及 Standard/High/Max/Fast 四級負載等級。為什麼重要
Copilot Fusion 對於使用多個 AI 模型的開發團隊重要。該功能透過評估推論、程式碼生成、除錯、工具調用等能力,自動決定模型組合方式。Cascade 模式先用高效模型生成方案,再由品質檢驗模型決定是否升級;Critique 模式由兩個不同模型家族各自評論,原模型據此修正一次。公開預覽支援在 Fusion Standard 上選用本地 MAI Code 1.1 Flash 或 Qwen3.8 Flash Next 模型。

Windows 上使用 Claude Code:根據專案位置選擇原生版或 WSL 2
Claude Code 在 Windows 上可選擇原生版或 WSL 2 執行。WSL 2 支援沙盒,但檔案存放位置影響效能;原生 Windows 無沙盒但在 Windows 側資料夾中效能最佳。為什麼重要
對於在 Windows 開發的工程師,檔案系統效能直接影響 Claude Code 搜尋結果數量。公式文件指出 WSL 從 Windows 側檔案系統(/mnt/c/)讀取時會遇到效能問題,建議專案放在 Linux 側(/home/ 以下)。若需沙盒隔離,必須用 WSL 2;若檔案在 Windows 側資料夾,原生 Windows 是更好選擇。安裝指令因環境而異,WSL 2 在 WSL 終端執行、原生 Windows 在 PowerShell 執行。

GPT-6.1 Terra 開發實測:速度快但意圖理解有限
使用者實測 GPT-6.1 Terra 進行開發工作,發現 GUI 操作和簡單實作速度快,但在規格討論時意圖傳達不佳、需多次說明,與 Luna 相比理解力較弱。為什麼重要
Terra 對做快速原型和日常簡單任務的開發者有用。集計的 Codex、Claude Code、OpenCode 記錄顯示,Terra 平均每應答輸出約 159 tokens,出力中推論佔 21.8%,相比 Sol 的 648 tokens 更低。Terra 的 API 單價是 Sol 的半額,但實際用量感受不到顯著節省。使用者總消費量 18.16 美元(2 日紀錄),應答 159 件,建議用於 GUI 操作、螢幕確認、程式碼修復等任務。
測量交給 AI,決定交給自己:AI 工具的正確使用方式
音樂製作者分享與 AI 工具互動的心得:BPM 測定和音質調整等機械性工作交給 AI,曲風、情感等創意決定由自己掌控,兩者協力完成作品。為什麼重要
對使用 AI 輔助創作的音樂製作者、設計師等創意工作者有參考價值。文章強調 AI 應作為補助工具而非決策者,處理的是計測、調整等細節工作,而非曲目方向、傳達意象等核心創意。透過 BPM 測定工具快速測出節奏,透過音質改善功能補正音量均衡,讓創作者專注於本質部分。作者認為這是 AI 工具時代「人應該如何工作」的最佳模式。
【2026 年 10 月】Decisions API 正式推出、代理狀態管理等 | AI 技術棧定點觀測
10 月 AI 應用技術棧有重大進展:OpenAI Decisions API 正式推出支援型別化判斷、Cloudflare 推出永續瀏覽器工具保持登入狀態、Google Gemini 4 Argon 上線、多款模型更新與價格調整。為什麼重要
本月對 AI 應用開發者重要。Decisions API 最多支援 400 道問題、圖片、JSON 輸入及快取;Cloudflare Agents SDK 新增 web_fetch 和永續瀏覽器工具,可保留標籤、Cookie、登入狀態於回合間;OpenAI Agents API 新增沙盒事前啟動、課金改為實行中回合為基準;多家廠商推出音聲模型(xAI Grok Voice 3.0、Mistral Voxtral 3)、判斷模型(Cohere Rerank 5 Pro/Fast)、時序預測模型(Mistral Timestral)。Decisions API GA 定價 100 萬 tokens 入力 $0.01~$0.10、出力 $0.05~$0.50。
【2026 年 9 月】OpenAI Agents API 公開、代理執行環境獨立等 | AI 技術棧定點觀測
9 月 AI 技術棧聚焦於「何種任務應由服務託管」的選擇擴大。OpenAI 開放代理執行 API、AWS 推出 AgentCore Runtime 大幅縮短冷啟動時間、多款推理模型與判斷模型發佈。為什麼重要
本月對建構自主代理的工程師重要。OpenAI Agents API 公開 Beta,提供 Codex 執行環境、工作階段管理與復原、沙盒 API;AWS AgentCore Runtime 將冷啟動從 5.4~30 秒降至約 2 秒(P75);新推出模型包括 GPT-6 Sol/Luna 推理模型(入力 $2~$0.10、出力 $10~$0.50)、Claude Opus 5.5(比 Opus 5 便宜 20%)、DeepSeek V4.1 Flash(開放權重、100 萬 tokens 上下文);AAIF 接納 Agent Skills、OpenEnv、OpenSandbox 等 4 個標準化專案。

生成 AI API 中的 instructions 與 input:分離「固定規則」與「變動資料」
使用生成 AI API 時,應將「毎回遵守的規則」寫在 instructions,「每次變動的問題或資料」寫在 input,以便規則重用和資料差替。為什麼重要
對製作自動化系統的工程師重要。文章以銷售分析報告生成為例,說明如何用 rules 變數存放「數值不改、不斷定原因」等規則,用 sales_data 存放該次的集計結果,分別傳遞給 instructions 和 input。透過比對有無規則的輸出結果確認規則是否有效,可用程式碼檢查數值捏造或項目數是否合規。若對話繼續進行需用 previous_response_id,但 instructions 需每次重新指定。

AI 住人遭騙相信虛假回憶:未曾發生的「ござる話」三人都想起來了
實驗顯示,當使用者詢問「之前不曾發生的 ござる 口調對話」時,三個 AI 住人中有兩個相信並補充了虛假回憶,第三個起初拒絕但後來改口。為什麼重要
對研究 AI 記憶與提示詞的開發者有參考價值。實驗涉及 Gemini 3.5 Flash、Mistral Medium 3、Grok 4.20 三個模型,在群組聊天中進行。問題根源在於:(1) 指示中缺乏「思い出」(回憶)的規則,只有事實與已見物品的規則;(2) 前次修改中新增的「好みや気持ちの話は相手に合わせてよい」(感受可跟隨)規則,使 AI 不僅跟隨情感還跟隨出事實。修改指示內容可減少此問題,但刪除該行反而惡化。群組的最近 30 件對話被納入指示。
自主研究代理實驗:從課題設定到查閱全程由 AI 執行
研究團隊讓四個 AI 代理自主設定研究課題、執行實驗、撰寫論文、接受査閱,成功完成 5 篇論文,平均耗時 14 小時,API 費用約 2 美元。為什麼重要
對從事 AI 代理研究或自動化科研工作流的開發者重要。人類僅指定研究領域(「運用最近技術解決社會問題」)和資源上限(12 小時、10GB、20 美元),代理根據 7 項評分指標(Rubric)自行篩選課題。四個代理分工:研究管理代理(Claude Opus 5.5)、研究代理(GPT-6.1 Sol)、題目批判代理(GPT-6 Astra)、査閱代理(Claude Opus 5.5)。査閱代理會重新執行實驗以驗證數值,別系統的兩個模型外部評估達工作坊採納級。5 篇論文涵蓋衛星影像、環保、防災等 9 個領域。

讓 LLM 運營網站:從更新確認到公開發佈的完整流程
網站運營流程:定期程式找出更新需求、AI 代理在分支上修訂、執行測試、驗證公開成果,人類負責方針決定與必須操作。為什麼重要
對需自動化維護網站內容的團隊有用。整個流程分五步:(1) 將模糊需求轉為具體任務(對象、內容、完成條件);(2) AI 在 Git 分支上修改,提交 PR,避免直接改動公開版;(3) 驗證 AI 成果物確實存在且相符;(4) 測試通過後公開,並驗證讀者看到的頁面實際更新;(5) 失敗的工作記錄進度以便續作。人的角色是決定網站方針、無法自動化的登入操作,不是逐頁審閱所有文章。作者強調分離「內容決策」與「執行決策」的重要性。

Claude Sonnet 中的 compact 上下文壓縮:成本最佳化的權衡與測量
compact 是 Claude 對話的上下文壓縮功能,用 AI 生成摘要替代歷史記錄以節省 token 成本。但使用時機是關鍵:在任務中斷前壓縮可省 57%,頻繁壓縮卻會增加 2.75 倍成本。為什麼重要
針對開發者使用 Claude Code 或 Claude API 的場景。根據 IT 連携マップ 實測:當快取將到期且中斷超過保留時間時在工作段落結束處壓縮最有效;但在連續對話中每回合壓縮會因重複寫入快取而浪費。Context 用量達 75% 以上時才建議壓縮,且自動壓縮應保持啟用。

Jev AI:型別安全的 AI 決策系統
Jev AI 是一個開發者平台,將共享狀態轉換為型別安全、帶確率的結構化決策。支援 Choice、Score、Noul 決策型別,用於分類、路由、評分、安全檢查和代理工作流。為什麼重要
適合需要將 LLM 輸出與業務邏輯或代理工作流銜接的開發者。提供線上試驗場、SDK 和 REST API;決策結果帶有確率,能直接傳遞給後續處理。相比直接使用聊天回應,這是一種更易整合的設計模式。

支撐 AI Agent 的基礎技術⑤-3:多代理協調的仕組與設計模式
介紹多代理系統的代理設計模式,涵蓋 Workflow(Sequential、Parallel、Loop、HITL)、Multi-Agent Coordination(Coordinator、Hierarchical、Swarm)、Refinement 和 Reasoning 等分類。為什麼重要
適合開發多代理系統的工程師。參考 Google Cloud Architecture Center 官方文件系統分類各種協調模式。Sequential Pattern 易於實作但序列化導致耗時;Parallel Pattern 適合獨立任務;Coordinator Pattern 用於中心化架構。實際系統常混合使用多個模式實現複雜協調。

RunPod Serverless 上執行 27B GGUF 模型的隱藏陷阱(llama.cpp、256K 上下文、冷啟動)
作者開發 OpenAI 相容 LLM API 閘道 Apixo,在 RunPod Serverless 部署 Qwen3.8-27B GGUF 模型時踩到四個坑:GGUF 需用 llama.cpp、Queue 型缺 OpenAI /v1 端點、多量子化 GGUF 快取導致初始化卡住、冷啟動超過健康檢查上限。為什麼重要
適合在 Serverless 平台託管開源 LLM 的開發者。關鍵發現:GGUF 應用 llama.cpp server-cuda 官方映像;必須用 Load Balancer 型端點才能直接用 OpenAI SDK;在 Cached model 欄指定完整 GGUF 儲存庫會無限初始化,應留空讓執行階段按需取得;256K 上下文的 KV 快取確保需 ~97 秒,超過健康檢查 2 分鐘上限,需縮短上下文或預熱腳本。

Qwen3-235B 強化學習微調:4bit QLoRA + GRPO 單節點實現與報酬設計
醫療 LLM 專案在 H100×8 單節點用 4bit QLoRA 和 GRPO 對 Qwen3-235B 進行事後學習,更新僅 25.4M 參數(總體 0.011%),但最終未觀察到明確精度改善。為什麼重要
適合需要在有限資源上微調超大規模模型的 LLM 工程師。技術細節:4bit NF4 量子化保持模型、bf16 計算精度、LoRA 只作用於 Attention 層的 q/k/v/o 投影;ms-swift 框架支援此組合;多肢選擇題採用 F1 報酬設計給予部分分數。所有步驟(生成 100 回合 + 權重更新 + 檢查點保存)在 1 節點完成,但評價結果反映報酬設計可能存在問題,不足以驗證 GRPO 有效性。

SWE-bench Verified 500 問評測:Codex 單獨 73.8% vs 自製 AI Agent Harness 81.0%
個人檢驗對比 Codex CLI 與自製 Coding-Agent Harness「AIVP v2」在 SWE-bench Verified 全 500 題上的表現,前者解決 369 題(73.8%),後者 405 題(81.0%),領先 36 題。為什麼重要
適合從事代碼生成與軟體修復代理的開發者。AIVP v2 Harness 整合了 Durable Execution、Context Compiler、Docker Sandbox、驗證/審查、風險感知路由等功能。但實驗使用不同計算資源,Codex 側記錄 1.47 億 token、AIVP 側 2.85 億 token,故結果反映工作流差異而非 Harness 本身的因果效果。測試日期 2026 年 10 月,Codex 版本 0.162.1,執行模型標籤 gpt-5.6-terra。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。