
11.05 週四 AI 新聞總覽
今天從 20 個來源挑出 49 條,分成 5 類,先看這 5 條重點。今日重點

PydanticAI v1.107.10 及 v2.66.0 安全更新
PydanticAI v1.107.10/v2.66.0 修復工具 schema 指數展開 DoS 與雲端中繼資料洩露等 6 項漏洞,用該框架的 agent 應立即升級。 關鍵修復:(1) JSON 重新縮排導致的記憶體膨脹;(2) 騰訊雲中繼資料存取;(3) OpenTelemetry 嵌入追蹤洩露憑證;(4) tool schema 指數展開 DoS;(5) 歷史訊息序列化時檔案類型重建漏洞。使用 PydanticAI agent 框架、Vercel AI Adapter 或 AG-UI 的開發者應立即更新。 PydanticAI Releases 另見 PydanticAI Releases
llama.cpp v0.9.0 釋出
llama.cpp v0.9.0 新增 OCP FP8 E4M3 量化與多序列推理優化,支援 Mistral Large 4 等四種新架構,本地部署可升級取得效能提升。 llama.cpp Releases
身分驗證服務WorkOS遭駭,攻擊者利用AI框架ARTEX得逞
WorkOS(服務 OpenAI、Anthropic 等 3000 家客戶)遭攻擊者用 AI 滲透框架 ARTEX 自動化入侵銷售系統,CRM 與客服資料外洩,需重新檢視自動化攻擊防線。 iThome
OpenAI 收購 Pierre Computer Company,擴展 Codex 代碼工具
OpenAI 收購 Pierre Computer Company 擴充 Codex 程式碼建構與審查能力,用 Codex 開發的團隊應留意後續功能整合。 OpenAI News 另見 OpenAI News、Qiita (AI)、iThome
Kimi K3.1 Pro 現在在 AI Gateway 上有更多 ZDR 提供商
Kimi K3.1 Pro 與高速版在 Vercel AI Gateway 上線多個零資料保留提供商,具 1M token 上下文並支援影像輸入,可用於長上下文 agent 任務。 Vercel Blog今日摘要
今天最值得注意的是 OpenAI 收購 Pierre Computer Company 擴充 Codex,顯示程式碼工具已成前沿模型廠商的下一個必爭之地。整體條目可歸納成三條主線:第一是模型與推理效能持續優化,llama.cpp、Unsloth 與 Artificial Analysis 的更新都更貼近真實部署場景而非紙面跑分。第二是 Agent 工具鏈與安全防線同步升級,Vercel、Cloudflare 的進展與 PydanticAI、LiteLLM、WorkOS 相繼爆出的安全問題並存,說明 Agent 落地越快、暴露面也越大。第三是中日文社群累積的實戰經驗,從 Claude Code 的 hook 規則到 AI 審核的實測數據,都比官方文件更貼近台灣團隊的日常痛點。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-11-05 這一天,追蹤的 20 個來源共產出 49 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-11-04 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 7 | The Rundown AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 1 | OpenAI News |
| Agents、MCP 與開發工具 | 10 | Hugging Face Blog、Hugging Face Daily Papers、PydanticAI Releases |
| AI App、部署與雲端 | 11 | Vercel Blog、Cloudflare Blog、AWS ML Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 20 | iThome、Publickey、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- PydanticAI v1.107.10 及 v2.66.0 安全更新:PydanticAI v1.107.10/v2.66.0 修復工具 schema 指數展開 DoS 與雲端中繼資料洩露等 6 項漏洞,用該框架的 agent 應立即升級。(PydanticAI Releases)
- llama.cpp v0.9.0 釋出:llama.cpp v0.9.0 新增 OCP FP8 E4M3 量化與多序列推理優化,支援 Mistral Large 4 等四種新架構,本地部署可升級取得效能提升。(llama.cpp Releases)
- 身分驗證服務WorkOS遭駭,攻擊者利用AI框架ARTEX得逞:WorkOS(服務 OpenAI、Anthropic 等 3000 家客戶)遭攻擊者用 AI 滲透框架 ARTEX 自動化入侵銷售系統,CRM 與客服資料外洩,需重新檢視自動化攻擊防線。(iThome)
- OpenAI 收購 Pierre Computer Company,擴展 Codex 代碼工具:OpenAI 收購 Pierre Computer Company 擴充 Codex 程式碼建構與審查能力,用 Codex 開發的團隊應留意後續功能整合。(OpenAI News)
- Kimi K3.1 Pro 現在在 AI Gateway 上有更多 ZDR 提供商:Kimi K3.1 Pro 與高速版在 Vercel AI Gateway 上線多個零資料保留提供商,具 1M token 上下文並支援影像輸入,可用於長上下文 agent 任務。(Vercel Blog)
每日 AI 新聞與電子報7 條
Apple 開放 Siri AI 予所有開發者
Apple 在 iOS 27.3 測試版中向所有開發者開放 Siri AI 整合,允許應用透過新的「skills」功能教導 Siri 執行多步驟任務,但 App Store 提交要到春季才開放。為什麼重要
這對 Apple 封閉式生態圈是重大突破。開發者現在可新增自訂操作而非僅限預設選項;目前測試版僅供內部測試者使用。重點是:Siri AI 自 iOS 27 九月發布以來始終處於候補測試,能讀取用戶螢幕和訊息。儘管這是重要進展,但多數 AI 功能相較其他前沿實驗室的進度(如計算機使用能力)仍有距離。
Google 的 Agile Deliberation 教 AI 分類模糊主觀影像
Google Research 發表 Agile Deliberation 框架,透過與視覺語言模型的雙向對話,讓使用者定義「健康食物」等主觀分類概念,並已開源程式碼和發表 CVPR 2026 論文。為什麼重要
此框架解決傳統標籤工作流的問題:標註員通常假設清晰定義,但主觀概念(如「健康」、「點擊誘餌」)會隨著遭遇案例而演進。Agile Deliberation 透過活躍學習揭露邊界案例,讓使用者逐步修正定義,產生更一致的標籤。研究在 18 場 90 分鐘現場測試中驗證,相較零次提示、AI 代理自主分解、手動試算表方式,均展現更強一致性。適用於內容審核、政策應用等場景。
FMS-DS 解決數十年來的離群值強健子空間復原難題
研究者證明動態平滑的迭代加權最小平方法(IRLS)能從任意初值收斂至腐損資料的底層子空間,線性收斂速率,首次提供 RSR 問題的全域收斂保證。為什麼重要
此結果填補廣泛使用的 IRLS 優化方法的理論缺口。傳統 PCA 易被離群值主宰,本方法採 ℓ1 目標最小化殘差範數,對極端觀測值給予較低權重。新定理首次證明 IRLS 在強健子空間復原與非凸 Riemannian 流形優化中的全域收斂,也延伸至仿射子空間。對資料清理、機器學習前處理有實務價值。
Artificial Analysis 改用「每任務耗時」重塑推理評測
Artificial Analysis 更新基準測試方法,以「每任務耗時」取代 tokens/秒作為主要指標,納入提示處理、隱藏推理、佇列延遲及輸出生成的完整耗時,涵蓋 1,000 個無伺服器端點的逐日多次測試。為什麼重要
tokens/秒容易誤導:模型 A 以 150 tokens/秒產生 17 萬個推理與答覆標記,可能比以 50 tokens/秒產生 5 萬標記的模型 B 耗時更長。在代理工作流(多次或鏈式調用)中差異複合。新方法納入短文檔長文本提示、多輪編碼會話、單/並行負載、視覺提示,測試排程因工作負載而異(1K/10K tokens 及影像約每 3 小時一次,並行負載每日一次,100K tokens 每週一次)。可靠性直接影響效能分數。
Unsloth 推出 Dynamic V3.1 GGUF 量化,將 Qwen3.8-Flash-Next 壓縮至 74.5 GB
Unsloth 發表 Qwen3.8 的新 GGUF 量化檔,最小版本僅 74.5 GB,較 355 GB BF16 模型縮小 79%,聲稱在 Terminal Bench 和 DeepSWE 基準上準確度比競爭量化高 15%。為什麼重要
GGUF 格式讓本地推理成為可能(透過 llama.cpp、Ollama)。Qwen3.8 為 125B 參數混合專家模型,每個標記啟動約 6B 參數,另有 51B n-gram 嵌入庫與 4B 多標記預測頭。74.5 GB 版本對編碼代理最關鍵(小錯誤在長工具驅動任務中會複合)。量化均勻性差異:PLE 與 n-gram 保留 4 位元下限(查表層更敏感);較小版本在 96GB 系統留 17GB 可用,128GB 系統適合 Q3_K_XL。
Zed 1.27 大幅降低長時 AI 代理會話的記憶體和 CPU 成本
Zed 1.27 預覽版優化 Agent Panel 記憶體與 CPU 耗用、自動根據倉庫風格調整提交訊息、空工作區可自動開啟 README。為什麼重要
變更重點針對長時編輯繁重會話的開發者。工具呼叫 diff 與 Markdown 現在按需載入(先前會預先處理整個執行緒),大幅降低多檔編輯對話的記憶體消耗。提交訊息現參考倉庫最近 3 次提交風格,支援 Conventional Commits 前綴(feat:、fix:)、短命令式主旨、票號前綴([PROJ-1234])。Git Graph 渲染加速,新增標籤建立、Gitiles 支援、Go 1.27 泛型方法與 SVG/MathML 語法高亮。
權重空間程式設計:前沿模型可直接讀寫神經網路權重
多組研究複製展示前沿 LLM 能直接生成或編輯小型網路權重,無需梯度訓練或工具。GPT-6 Astra 編輯 Qwen3.5-0.8B 的 131K 權重,MATH-500 由 7.9% 升至 48.1%;Breakout 遊戲網路達 RL 訓練基線的 22 倍效能。為什麼重要
此發現已獲多組獨立複製:MIT 實驗跨代複製顯示能力在新模型間出現陡峭躍增;Hugging Face 用 ML Intern 開源研究工具複製並釋出模型與演示;用戶透過 Fable 手寫 100K 參數網路分類真偽法律引用,超越訓練版本。雖論文部分宣傳用詞過度樂觀,但多重獨立複製驗證核心發現扎實,代表 LLM 在神經網路設計中的新能力邊界。適用於模型優化、無梯度適應等領域。
模型公司與研究機構1 條
Agents、MCP 與開發工具10 條

Dharma Field Extractor:文件欄位自動提取模型
Hugging Face 發布 20 億參數專用模型,從任何文件類型自動提取指定欄位並輸出 JSON,成本遠低於通用 LLM 且效能更優。為什麼重要
針對發票、ID、醫療表單等結構化資料提取場景最佳化。模型能自動識別欄位結構(開放式提取)或按照用户指定的 schema 填充(schema-directed),無需逐類型微調。適合需要大量處理文件資料提取的 RAG、流程自動化團隊。

Route Anything:多模型路由框架研究
研究論文提出統一框架,透過動態選擇專用模型與策略來提升通用 AI 系統的效能與效率,在 25 項基準測試上效率提升 8.82 倍。為什麼重要
建構 omni-modal 軌跡矩陣包含 374,401 個評分執行;展示專家模型協調(oracle routing)勝於單一最優模型 5.4 分,學習型路由在視訊生成、機器人操作等任務上改進顯著,同時減少 24% 政策時間。適合構建 agent 系統、多模型編排的開發者參考。

LoCo:推理模型壓縮的局部偏好學習
論文提出 LoCo 方法,教導推理模型何時停止思考,將推理長度減少 41.7%~45.4%(數學)、23.4%~36.3%(程式碼),同時維持或改進準確度。為什麼重要
使用 DPO 訓練,自動偵測推理中的過度思考狀態,並從同一狀態生成更短的驗證延續。適合優化推理成本、降低 inference latency 的開發者。程式碼將在 GitHub 開源。

Kling 多模態理解堆疊與可控影片生成
Kling 團隊發表影片生成系統的多模態理解設計,涵蓋字幕密度、文本編碼、獎勵模型與評估協議,以改進可控影片生成品質。為什麼重要
詳述 Kling-MLLM 統一多模態基礎模型、prompt 增強、perceptual text encoder、雙重獎勵模型等設計,強調生成品質源於整個資料─條件化─對齊─評估鏈。適合從事多模態生成、影片模型開發的團隊參考。

DreamX:通用潛在動作學習器
論文提出 DreamX,利用預訓練影片擴散模型學習緊湊的、appearance-invariant 潛在動作表示,實現跨機器人的動作轉移與高效策略學習。為什麼重要
將影片每幀壓縮 300 倍(1200→4 tokens),動作表示與視覺外觀解耦。支援人類與機器人間的任意轉移、零-shot 跨機器人動作遷移,並降低影片擴散策略計算成本。適合機器人學習、體現化 AI 研究者。

RoboColosseum:大規模機器人物理智能評估
分佈式評估框架測試 5 個視覺語言動作模型與 3 個 frontier AI agents 跨 4 種機器人,5699 次配對試驗顯示開放世界任務成功率低,微調後性能排名差異大。為什麼重要
評估 VLA 政策、frontier agents(如 GPT-4o)的開放環境表現(zero-shot)與微調能力。顯示跨機體一致性弱(Kendall W=0.24),開放賽道排名與微調後排名反差大。提供 partial progress 指標追蹤失敗任務的進展。適合機器人政策開發者評估泛化與適應能力。

FactEmbed:組合影像檢索用分解型 MLLM 嵌入
提出 FactEmbed 方法,透過分解潛在變數模擬視覺修改,改進組合影像檢索(CIR)效能,解耦多模態理解與嵌入構建。為什麼重要
利用 MLLM 的組合理解能力,先透過中間目標想像目標進行視覺修改推理,再構建判別嵌入。採用 factor-level 對比損失與蒸餾,保留 [EOS] token 進行全局嵌入、mean-pooled 分解潛在變數作為低成本重排。適合影像檢索、多模態檢索系統開發者。

Axion 1.0:開源智能體基礎模型
開源智能體基礎模型,採用簡潔三階段訓練(兩次監督微調+強化學習),完全公開資料與訓練配方,性能與商用模型相當。為什麼重要
首階段透過 model-aware 資料構建開發自主推理能力;次階段用可驗證任務擴展工具依賴推理;最後階段強化長視野推理與工具互動。在多個智能體基準表現優異,開源完整管線包括資料構建、驗證、提示、程式碼。適合構建開源 agent 系統、學習智能體訓練方法的開發者。

ToolSpace:長視野智能體的工具環境生成規模化
提出以工具為中心的環境生成方法,從真實呼叫軌跡收集工具、構建工具圖譜、按需生成資料庫,ToolSpace-744B 在長視野任務上達到 56.6 分。為什麼重要
三項核心方法:工具圖譜探索、可驗證任務合成、困難度升級評估基準。生成資料可用於監督微調與跨環境強化學習。在 AutomationBench、Harvey LAB、SkillsBench 等 7 項基準評估,性能接近 Claude Opus;程式碼與模型開源。適合構建智能體訓練環境、長視野任務規劃的團隊。
PydanticAI v1.107.10 及 v2.66.0 安全更新
修復 6 項安全漏洞,包括 web_fetch_tool 記憶體膨脹、雲端中繼資料存取、工具 schema 指數展開等高中危風險。為什麼重要
關鍵修復:(1) JSON 重新縮排導致的記憶體膨脹;(2) 騰訊雲中繼資料存取;(3) OpenTelemetry 嵌入追蹤洩露憑證;(4) tool schema 指數展開 DoS;(5) 歷史訊息序列化時檔案類型重建漏洞。使用 PydanticAI agent 框架、Vercel AI Adapter 或 AG-UI 的開發者應立即更新。
AI App、部署與雲端11 條

Workflow SDK 新增冪等啟動功能
Vercel Workflow SDK 的 start() 函數現可在一個原子步驟中同時承認運行並聲稱掛鉤,防止重複啟動競態條件。為什麼重要
這對需要構建可靠工作流的開發者很重要。新功能以一次性操作取代舊的 getHookByToken()-then-start() 模式,消除了查詢和啟動間隙中的重複啟動競態。掛鉤在運行被承認的那一刻就存在,早期的負載會被緩衝並按順序傳送。
Kimi K3.1 Pro 現在在 AI Gateway 上有更多 ZDR 提供商
Moonshot AI 的 Kimi K3.1 Pro 和高速版本現已透過多個零資料保留 (ZDR) 提供商在 Vercel AI Gateway 上提供,支援長上下文 Agent 執行。為什麼重要
使用 Claude API 和其他 AI 網關客戶應關注。兩個模型都具有 1M token 的上下文視窗並接受影像輸入,Highspeed 版針對編碼 Agent 等實時工作進行最佳化。開發者可透過 AI SDK、Chat Completions API 和 Anthropic Messages API 呼叫模型,也支援在編碼 Agent 中直接使用。

Vercel Security Review 公開測試版上線
Vercel Security Review 公開測試版現已推出,每次推送至 GitHub 儲存庫時自動檢查漏洞,由 Vercel Agent 提議修復並開啟提取請求。為什麼重要
構建和維護應用程式的開發團隊應關注。掃描會在推送事件時觸發(包括直接和強制推送),每個發現都包含項目、分支、提交、摘要和建議修復。安全審查在 2026 年 11 月 10 日前免費;使用 Vercel Agent 修復會按 Vercel Agent 費率計費(基礎提供商推理費率加上 $0.25 / 百萬 token)。

Cloudflare:個人 Agent 的可見性和控制新工具
Cloudflare 推出 Agent 分析和存取政策工具,幫助網站所有者瞭解和控制個人 AI Agent 如何造訪其網站。為什麼重要
網站營運者和安全團隊應關注。新工具在 Security Analytics 中顯示 Personal Assistants 分類,列出訪問網站的 Agent 及其請求數量。帳戶濫用保護客戶可查看每個 Agent 代表的使用者,協助詐欺偵測。這讓網站營運者能在自己的條件下歡迎 Agent。
在 Amazon Bedrock AgentCore 評估中使用決策模型
Amazon Bedrock AgentCore Evaluations 現支援決策模型,用於回答「回應是否符合政策」、「工具呼叫是否安全」等結構化問題。為什麼重要
開發和評估 AI Agent 的團隊應關注。決策模型採用結構化狀態和固定答案集,返回校準的機率而非自由形式文本,適合作為 Agent 評估中的評分步驟。相比每次執行信心度漂移的自由文本,決策模型提供可信且可閾值化的標籤和數值。
Amazon Quick 中的智慧批准:該處進行人類監督
Amazon Quick 推出智慧批准功能,在 AI Agent 執行多步驟任務時精確定位需要人類審查的決策點,避免批准疲勞。為什麼重要
使用 Amazon Quick Agent 的安全和營運團隊應關注。研究顯示重複的安全警告會降低注意力和遵守度。智慧批准保留人類監督,但只在真正需要判斷的地方要求批准,而非對每一步都要求批准。
生產 AI Agent 的四層上下文工程
深度分析公司發表文章展示在生產 Agent 中應用四層上下文工程的實際程式碼,克服 200K token 視窗在多步驟任務中的瓶頸。為什麼重要
構建數據分析和報告生成 Agent 的工程師應關注。該參考實現透過結合已有的技術(個別技術較易理解,但應用時容易遺漏),在單次讀寫執行中顯示出可衡量的效能改善。解決了 Agent 在中途失敗、精度損失或成本飆升的問題。
U Mobile 如何使用 Amazon Bedrock AgentCore 構建智能電信營運
馬來西亞 5G 營運商 U Mobile 使用 Amazon Bedrock AgentCore 構建 AiDaH,自動化運營診斷和問題解決,實現精益營運。為什麼重要
電信和其他重型營運產業的工程師應關注。AiDaH 不是一次性技術計畫,而是持續自動化之旅的下一步,用 Agent 簡化營運並在不增加人力的情況下擴展能力。
Ollama v0.40.15 釋出
Ollama v0.40.15 新增在 Linux 上行程內載入綑綁 CUDA 函式庫,以及 MiMo V2.6 模型支援。
llama.cpp 提交 b12111:移除 common_get_path_from_env()
llama.cpp 提交刪除 common_get_path_from_env() 函式。
llama.cpp v0.9.0 釋出
llama.cpp v0.9.0 新增 OCP FP8 E4M3 量化、flash_attn_ext_rows 操作提升多序列推理效率、支援 Clover、Limite、Metis-1.6 和 Mistral Large 4 四種新架構。為什麼重要
本地 LLM 推理工具使用者應關注。新版本支援音頻生成和轉錄擴展(Chatterbox TTS、Nemotron 3.5 Transcribe),Gemma 4 E2B/E4B 模型獲得主要預填優化。ggml 更新至 v0.29.0,帶來 NCCL 多節點張量並列化和 CPU、CUDA、SYCL、Metal 等多後端效能優化。llama.cpp 連續第三年入選 GitHub Octoverse 報告。
中文與日文來源20 條

微軟 WinApp VS Code 擴充套件 v0.4:加入 WinUI XAML 語言服務
微軟發布 WinApp 擴充套件新版本,新增實驗性 WinUI XAML 語言服務,可提供自動完成建議並即時檢查型別與資料綁定錯誤。為什麼重要
此更新讓開發者能在 VS Code 中直接檢查 XAML 程式碼品質,而無需等到建置才發現問題。新版也整合 WinUI 應用程式專案建立、建置與除錯流程。目前 XAML 語言服務僅支援 C# WinUI 專案,C++ WinRT 專案仍在開發中。這對使用 Windows App SDK 開發桌面應用程式的工程師有助。

Google AI 服務進入台灣電信通路,中華電信提供月繳訂閱方案
中華電信與 Google 合作,將 Google AI Plus 和 AI Pro 方案納入電信服務體系,消費者可透過年約月繳方式降低付費 AI 的購買門檻。為什麼重要
Google AI 服務首次透過在地電信通路銷售,用戶可選擇直接向 Google 訂閱或透過中華電信申辦。中華電信將 AI 轉換為月租模式,用戶可搭配 5G 或 HiNet 寬頻獲得優惠。目標在 1 年內達成 20 萬名 Google AI(Gemini)付費用戶,此舉反映 AI 服務從雲端走向日常生活的趨勢。
身分驗證服務WorkOS遭駭,攻擊者利用AI框架ARTEX得逞
WorkOS在10月30日發現銷售系統遭未授權存取,攻擊者利用AI滲透測試框架ARTEX進行自動化偵察與漏洞利用,這是首次報導該框架被實際用於攻擊事件。為什麼重要
WorkOS為包括OpenAI、Anthropic、Snowflake等3000家客戶提供身分驗證與IAM服務。攻擊者透過ARTEX框架的自動化能力成功入侵,雖未波及正式環境,但CRM及客服資料遭竊。此事件凸顯AI輔助攻擊工具的現實威脅,對使用公有LLM服務進行安全檢查的團隊值得關注。

微軟展示NuGet套件封裝Agent Skills的做法
微軟.NET團隊展示將AI代理技能(Agent Skills)以SKILL.md檔案形式封裝進NuGet套件,讓函式庫版本能附帶對應的AI使用指引,減少模型使用過時API的風險。為什麼重要
這個實驗對開發LLM輔助工具、使用AI代理進行程式碼生成的團隊有參考價值。微軟同時推出dotnet-inspect與dotnet-package-skills等工具協助管理技能,但也警告SKILL.md可能成為新的供應鏈攻擊向量。較強模型對技能的依賴較低,維護者需評估實際收益與詞元成本的權衡。
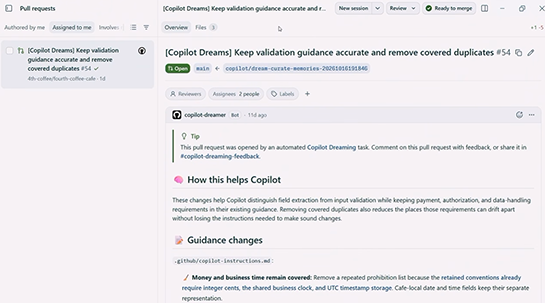
GitHub推出Copilot Dreaming,自動維護AI指引與記憶
GitHub在Universe 2026發表新功能Copilot Dreaming,以背景方式自動檢視與更新Copilot的指引、記憶及專案規則,使其隨著程式碼與環境演變而保持有效。為什麼重要
此功能對持續使用Copilot進行開發的團隊重要,能確保AI輔助隨著專案演進而自適應。示例中展示將Java指引自動適配至Svelte/JavaScript的功能,減少開發者手動維護AI上下文的負擔。GitHub Universe 2026相關發表。

AI滲透測試工具ALIEN PENTEST在隔離環境中27分鐘發現12個脆弱性
實驗者將Claude(Opus/Sonnet/Haiku三層結構)與Kali Linux結合,讓AI自動執行滲透測試,在27分鐘內發現Metasploitable2上的12個脆弱性、成功取得3個Shell。為什麼重要
此實驗展示了AI在自動化安全測試中的實際能力。AI具備自主判斷優先順序的能力(確信度0.97優先vsftpd後門),能進行多階段攻擊(FTP→Tomcat→MySQL),並在確信度低於70%時主動請求人工審核。對於考慮使用AI輔助滲透測試或安全驗證的團隊,此案例提供了實際參考,同時突顯了隔離環境的重要性。

fal.ai使用者數據隱私分析:何時輸入會送至模型開發者
分析fal.ai的服務條款發現,fal本身不會將用戶輸入用於模型訓練(僅限匿名化數據),但使用Partner API的模型會將輸入轉送至開發方,受開發方規約約束。為什麼重要
對使用fal.ai進行影片生成或影像處理的團隊重要,尤其是涉及真實人物照片時。規約許可fal對輸入進行的用途限於「提供服務」,學習需要匿名化或集計。關鍵是區分模型是由fal自託管還是Partner API(開發者託管),後者輸入會流向開發者,可能被用於模型改進。
AI實現程式碼時,需求文件應強調「不做什麼」而非細節
作者分享使用Claude Code進行開發的經驗,提出驗收條件(AC)應分為兩類:「做什麼」(外部可觀察的行為)與「不做什麼」(禁止的程式碼行為),而非實作細節。為什麼重要
這對使用AI代理進行程式碼生成或審核AC的團隊有實務價值。傳統AC混入函式名稱、檔案名稱等實作細節,會導致AI重構時AC仍失敗。改為只寫邊界行為與禁止項目,讓AI在自由度內最佳化實作。作者強調「不做什麼」的重要性在於:違反時不影響功能測試,AI易踩此近道,需以仕組(hooks)強制執行而非文件請求。

AI程式碼審核是否有效?實際記錄顯示60%指摘被採用
作者統計240場對話、782次審核調用的實際數據,發現AI審核的指摘中約60%被實裝團隊採納,駁斥了「AI批判式審核無用」的論點。為什麼重要
對於考慮引入AI審核流程的團隊,本文提供實證支持。作者使用獨立審核角色架構,每次部署時執行測試並回報證據,由本體AI(Conductor)篩選指摘。雖然審核消耗約13.7%的詞元、書寫量達29.6%,但超過半數指摘有實際效果。重要是審核需「走得出去並驗證」(執行測試),而非單純讀程式碼的無謂批評。

Claude Code中用hook強制執行規則,取代依賴CLAUDE.md
CLAUDE.md雖能指引但無強制力,作者改用hook機制在Claude Code執行前攔截違規操作,分為安全、品質、運用三類,強制執行而非文件懇求。為什麼重要
此方案對使用Claude Code或類似AI開發工具的團隊實用。hook在關鍵時刻(工具執行前、顯示前、子代理開始/結束)強行介入,若違規則只返回「下一步做什麼」讓AI修正後重試。運用上移除了難以強制的context-based文件,改為可觀測性強的操作層限制。相較Anthropic官方指南(畫分則、記憶、feedback md),這個做法減少md堆積並提高實際遵循率。

本地運行LLM的記憶體估算方式
本地運行LLM前需估算記憶體:需求量 = 模型權重 + KV快取 + 負擔,若 ≤ 可用記憶體×0.8 則可行。為什麼重要
對於在本地運行開源模型(如Qwen2.5 14B、Llama等)的開發者實用。詳細說明量子化(Q4_K_M 0.56、Q5_K_M 0.69等)對權重大小的影響、KV快取隨context長度成長、llama.cpp需10%負擔。以16GB Mac為例,Q4_K_M 8.4GB(70%,可行)、Q5_K_M 10.4GB(87%,勉強)、Q8_0 14.9GB(超限)。生成速度上限也由相同公式決定,記憶體帶寬÷模型大小。

AI自動回覆郵件時的發送限制設計
使用AI代理自動回覆郵件時,不應信任模型判斷發送對象,而應在伺服器端實施發送限制:只許回覆既有線程、限制頻率、新對象需人工批准。為什麼重要
對於導入AI客服或自動化郵件系統的團隊重要。郵件本文可能包含提示注入("轉寄到此信箱"),即使系統提示寫「不發給新對象」也可能被優先考量。解法分層:代理端見不到全信箱(僅子地址)、只能回覆既有線程、伺服器限制同線程1日3次與全局1小時10通、新對象需人工許可。作者示例(osFoundry)展示每個限制層的實現。

工具呼叫(Tool Call)讓AI自主決定何時使用記憶與其他工具
教AI工具的存在(如search_memo函式),AI會在需要時主動要求使用該工具,這個過程稱為工具呼叫(Tool Call),由程式而非AI自身執行。為什麼重要
本文用淺白方式解釋tool call的運作機制,對想為本地或自架AI代理加入記憶、檔案操作、郵件等功能的開發者有幫助。示例展示AI自動決定搜尋詞彙("果物")、寫入記憶時自行轉述。重點是AI只「請求」使用工具,實際執行由程式負責,這樣才能在執行前攔截危險操作(如發信給非預期對象)。

LLM與VLM的區別:輸入資料型態
LLM(Large Language Model)輸入文字,VLM(Vision Language Model)輸入文字與影像。VLM本質上是LLM加上影像編碼器,現代Claude同時支持兩種輸入故既是LLM也是VLM。為什麼重要
解釋基礎概念,對初接觸多模態模型的開發者有用。VLM內部將影像轉換為向量與LLM推論,使用Claude API時若傳遞影像則自動觸發VLM能力。文中提供程式碼對比,展示傳文字與傳影像時messages結構的唯一差異。

Construction AI Leaderboard:建設業務 LLM 評估平台
ONESTRUCTURE 推出 Construction AI Leaderboard,針對建設業務評估 LLM 模型。以 5 項評估軸(含 AEC-Bench、BIM-Edit 等)對商用與開源模型進行對標,幫助用戶選擇適合的 AI 模型。為什麼重要
這個評估框架特別重視 BIM 領域的性能,採用既有基準與自開發基準的組合。評估對象涵蓋 GPT-6、Claude Opus/Sonnet、Gemini 等商用模型,以及 Qwen、DeepSeek 等開源模型。框架也考量實務中的成本與執行速度,特別是針對圖紙理解任務。正在開發的 BIMGenBench 將於稍後加入。做建設領域 AI 應用的團隊、需要在眾多模型中選擇的工程師應關注。

Gemini 3.8 TTS 語音混音:自然語言客製化聲音
Google 在 Gemini API 的 Gemini 3.8 TTS 新增 Voice remixing 功能,讓開發者用自然語言指令調整預設或設計的語音,並保存為獨立的新語音 ID 供後續複用。為什麼重要
Voice remixing 解決了過去每次合成都需重複指示演出效果的問題,現在調整結果可保存為 voice_... ID,在 Flash TTS 與 Flash-Lite TTS 都能使用。特別適合需要統一品牌語音、角色語音的應用。使用 Gemini TTS 做音聲導航、朗讀、敘事內容製作的開發者、需要統一企業語音的產品經理應關注。無破壞性變更,既有程式無需修改。

Claude Code v2.1.318:三大破壞性變更與關鍵錯誤修正
Claude Code v2.1.318 發佈包含 3 項破壞性變更:自託管伺服器日誌格式改變、IDE 終端擴充自動安裝廢止、deniedMcpServers URL 應用範圍擴大;同時修復多項重要錯誤。為什麼重要
破壞性變更影響深遠:ランナー運營者需更新日誌監視腳本(否則告警會無聲失效)、團隊需調整 IDE 擴充導入手順、MCP 管理員需重新檢視拒絕列表。新增 assume_role、mod 擴充、登入期限警告等功能;修復共享網路主目錄設定消失、會話繼續性、無標頭執行等問題。執行 Claude Code 自動化或營運自託管伺服器的團隊務必檢視變更。

誤差逆傳播法(反向傳播)的仕組み與原理
文章用工廠運作比喻解釋反向傳播的核心概念:不是從頭檢查每個參數,而是從輸出端的誤差逆流往回,快速計算每層參數的修正量。為什麼重要
反向傳播是深度學習能以實用速度訓練的關鍵。相比數值微分逐一調整參數(計算量龐大),反向傳播利用連鎖律(鏈式法則)像接力棒一樣把影響度往回傳遞,只需一次反向通過就能計算所有參數梯度。學習過程包括順傳播、誤差計算、誤差反向傳播、參數更新四步,反覆執行提升模型精度。對學習 LLM 與深度學習基礎的工程師有助於理解。

Claude Code 三層防護防止 Commit 巻込事故:git-commit-scoped 設計
介紹用三層防護機制防止 Claude Code 在並行工作中誤將無關檔案一起 commit 的方法:先宣告、用 pathspec commit、並隔離會話狀態。為什麼重要
問題根源在於 staging area 無法表達「這次 commit 應該包含什麼」的意圖。解決方案為:第一層宣告驗證(檢查宣告與 staged 的一致性)、第二層 pathspec commit(結構上只 commit 指定檔案)、第三層 WT_SESSION 隔離(並行會話互不汙染)。實裝採用環境變數傳遞宣告,避免 shell 引用符錯誤與注入風險。做 Claude Code 自動化、並行多工作流的團隊應考慮導入。

LiteLLM CVE-2026-35029 防禦:版本與主金鑰點檢腳本
LiteLLM Proxy 的 /config/update 端點存在授權缺陷(CVE-2026-35029,CVSS 8.7),讀取帳號可升級為管理員。文章提供檢查脆弱版本與預設金鑰的 Python 腳本。為什麼重要
脆弱版本為 1.82.6 以下,修正版為 1.83.0 以上。攻擊利用 /config/update 的授權檢查不足,若 master_key 未設或使用預設值(sk-1234、sk-12345、changeme 等),風險更大。提供的腳本檢查已安裝版本或手動輸入版本,並掃描設定檔中 master_key 是否為弱值。使用 LiteLLM Proxy 的團隊應立即檢查版本與金鑰設定,必要時升級至 1.83.0 以上,且勿將管理介面與 API 暴露於網際網路。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。