
11.06 週五 AI 新聞總覽
今天從 30 個來源挑出 47 條,分成 5 類,先看這 5 條重點。今日重點

Le Chonk 提供思考能力,Studio 付諸行動
Mistral Large 4(Le Chonk)搭配擴充版 Studio,可在雲端、私有 VPC 或內部部署企業 Agent,並保留模型與資料完整控制權。 適合需要部署企業 Agent 與工作流程的開發團隊。Le Chonk 在編碼、網路安全防禦與文件推理上表現強大。新版 Studio 新增受管 Agent 與應用、工作流程能力、企業上下文、Agent 可觀測性與評估功能。用戶可在雲端、私有 VPC、內部部署或混合環境中部署,保持對模型與資料的完整控制。 Mistral AI News
Gemini Omni 1.2 Flash:快速且經濟效益高的長片段影片生成與編輯
Gemini Omni 1.2 Flash 支援 15 秒影片生成與多輪編輯,720p 每秒價格降至 0.07 美元,適合量產產品影片團隊估算成本。 Google DeepMind Blog 另見 Google AI Blog、Google Cloud AI / ML Blog、Qiita (AI)、Qiita (AI)、Qiita (AI)
使用 PDD Kit 正式驗證 Agent 撰寫的全堆疊網頁應用
微軟 PDD Kit 用 Verus 形式驗證證明 Agent 產生的程式碼符合規格,已在測試中揪出既有登入邏輯缺陷,可補足人工審查無法擴展的缺口。 Microsoft Research
OpenAI 揭露 AI 助理個人化瓶頸,模型難以善用過往對話
OpenAI LifeVal 測試顯示,把個人資訊放進歷史對話後任務達標率從 55.8% 降到 41.5%,提醒開發者別只靠對話記憶做個人化系統。 iThome
OpenAI 收購 Pierre,擴充 Codex 程式碼管理與審查能力
OpenAI 收購 Pierre 並整合其 Git 版本控制與程式碼審查技術進 Codex,讓開發者與 Agent 在同一平台管理大量程式碼變更。 iThome今日摘要
今天最值得留意的是「AI 寫的程式碼能否被信任」開始有了工程化答案。主線一是基礎設施層的正式驗證與安全自動化:Microsoft Research 的 PDD Kit 用形式驗證證明 Agent 產生的程式碼符合規格;OpenAI 的自主網安管道以 120 萬美元 API 成本找出並修補 948 個 Linux 核心漏洞,GPT-6 Cyber 也專攻授權範圍內的漏洞挖掘與修復,顯示 Agent 開始被允許碰觸高風險系統底層。主線二是企業級 Agent 部署持續擴張:Mistral 的 Le Chonk 搭配 Studio 把模型、資料、基礎設施控制權整套交給企業,Google 的 Gemini Omni 1.2 Flash 則以降價 30% 的長影片生成搶攻內容產線。
在 Apple Podcasts 訂閱,或其他 app 用 RSS。
AIDaily 每天早上 7 點整理 AI 圈的新消息:OpenAI / Anthropic / Google / Meta / Mistral 等模型公司的發布與 API 變更,LangGraph / MCP / PydanticAI / DSPy / CrewAI 等 Agent 開發工具的 release,Vercel / Cloudflare / AWS / Ollama / vLLM 的部署與雲端動態,加上 iThome / INSIDE / Zenn / Qiita 等台灣與日本技術媒體。2026-11-06 這一天,追蹤的 30 個來源共產出 47 條與 AI 相關的新內容,分布如下;每條摘要都由 Claude 產生,並附原文連結。想回顧前一天,看 2026-11-05 的 AI 新聞總覽;完整清單在 每日歸檔,抓取的網站列在 來源清單,也可以用 RSS 訂閱 AIDaily。
| 分類 | 條數 | 主要來源 |
|---|---|---|
| 每日 AI 新聞與電子報 | 7 | The Rundown AI、TLDR AI、AlphaSignal、Latent Space |
| 模型公司與研究機構 | 4 | OpenAI News、Google DeepMind Blog、Mistral AI News、Microsoft Research |
| Agents、MCP 與開發工具 | 13 | LangGraph Releases、Hugging Face Blog、Hugging Face Daily Papers、MCP Servers Releases、Semantic Kernel Releases |
| AI App、部署與雲端 | 9 | GitHub Trending、GitHub Trending (TypeScript)、Vercel AI SDK Releases、Cloudflare Blog、Ollama Releases、llama.cpp Releases |
| 中文與日文來源 | 14 | iThome、Zenn (AI)、Zenn (LLM)、Qiita (AI)、Qiita (LLM) |
- Le Chonk 提供思考能力,Studio 付諸行動:Mistral Large 4(Le Chonk)搭配擴充版 Studio,可在雲端、私有 VPC 或內部部署企業 Agent,並保留模型與資料完整控制權。(Mistral AI News)
- Gemini Omni 1.2 Flash:快速且經濟效益高的長片段影片生成與編輯:Gemini Omni 1.2 Flash 支援 15 秒影片生成與多輪編輯,720p 每秒價格降至 0.07 美元,適合量產產品影片團隊估算成本。(Google DeepMind Blog)
- 使用 PDD Kit 正式驗證 Agent 撰寫的全堆疊網頁應用:微軟 PDD Kit 用 Verus 形式驗證證明 Agent 產生的程式碼符合規格,已在測試中揪出既有登入邏輯缺陷,可補足人工審查無法擴展的缺口。(Microsoft Research)
- OpenAI 揭露 AI 助理個人化瓶頸,模型難以善用過往對話:OpenAI LifeVal 測試顯示,把個人資訊放進歷史對話後任務達標率從 55.8% 降到 41.5%,提醒開發者別只靠對話記憶做個人化系統。(iThome)
- OpenAI 收購 Pierre,擴充 Codex 程式碼管理與審查能力:OpenAI 收購 Pierre 並整合其 Git 版本控制與程式碼審查技術進 Codex,讓開發者與 Agent 在同一平台管理大量程式碼變更。(iThome)
每日 AI 新聞與電子報7 條
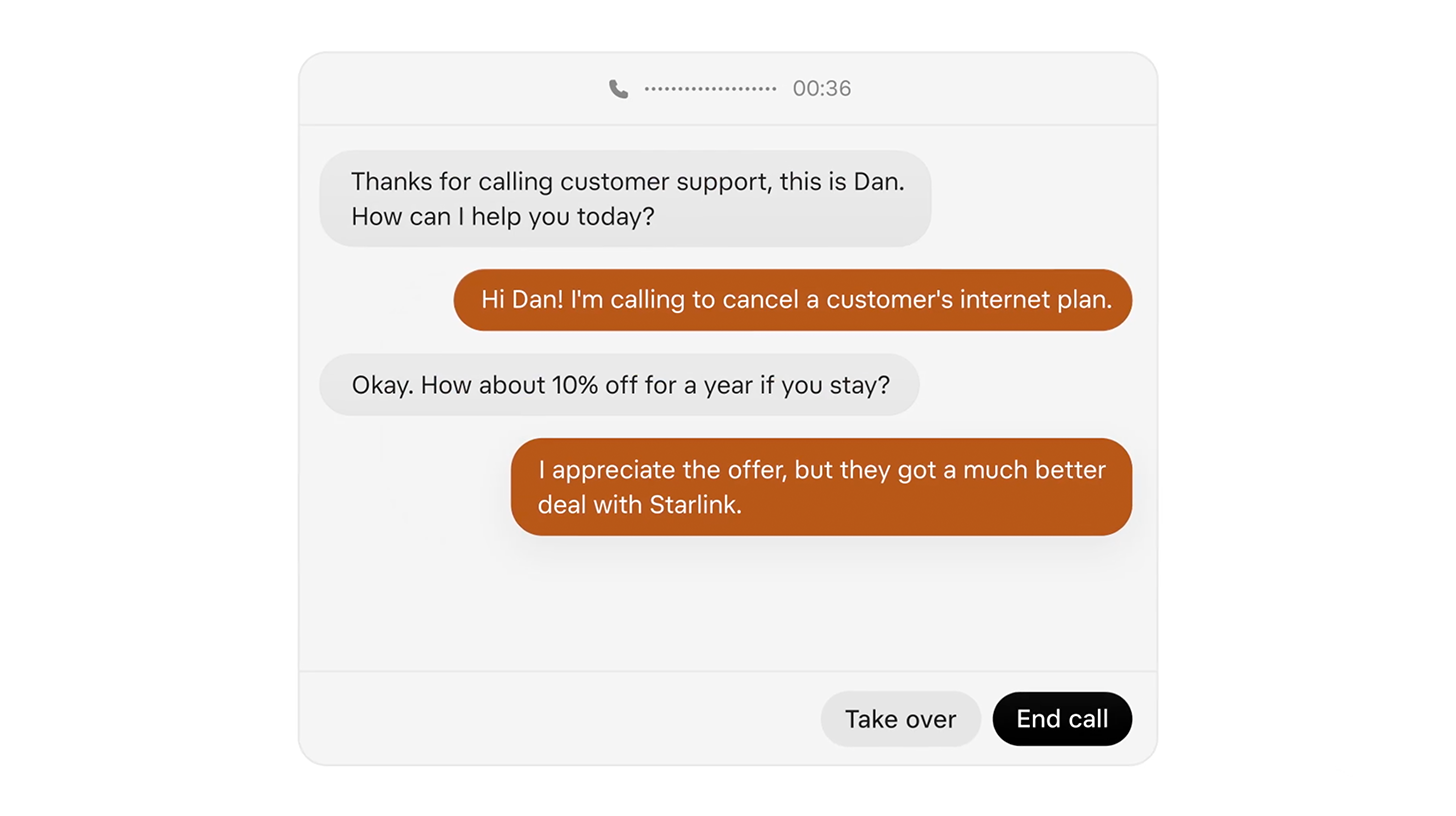
Grok Bot 推出電話通話功能,AI 代理可代替人工接聽
SpaceXSI 的 Grok Bot 付費用戶現已可讓 AI 代理撥打和接聽電話,處理長時間等待、預約和帳單協商等任務,用戶需負擔法律責任。為什麼重要
這對 AI Agent 開發者與使用者重要,展示了從對話式助手向真實世界任務自動化的進展。系統可在通話中接收用戶的實時回覆,並遵守電話法規。Grok Voice 已在處理 Starlink 每日 20,000 通來電。代理需在首頁向對方披露自己是虛擬助手。
OpenAI Images 2.6、Meta 收購 Conductor、Cognition SWE-2 Flash
OpenAI 推出 Images 2.6,生成速度快 50% 且支援 GIF;Ripple-65B Preview 以 3,200 萬美元訓練成本達到開源模型 SOTA;Pangram Image 1.0 可檢測影像中的 AI 生成內容。為什麼重要
Images 2.6 透過 API 提供 Flare 和 Sunburst 版本,改善了生成效率。Ripple-65B 是前沿開源模型,在 TerminalBench 2.1 上超越多個更大的開源模型,成本為前一代 SOTA 的十分之一。Pangram Image 1.0 提供 Chrome 擴充和 API 支援,可生成熱圖定位 AI 生成區域。
Meta Muse Realtime Avatar:將肖像即時轉換為會說話的頭像
Meta 推出 Muse Realtime Avatar,用戶可上傳肖像、插圖或物件作為參考,系統實時生成 25fps 影片,唇形同步與手勢與語音匹配,延遲約 870ms。為什麼重要
這對開發實時視頻生成應用的團隊重要。系統採用音頻驅動的 Diffusion Transformer,透過共享的語音 token 流協調語音、唇動和表情。Meta 使用蒸餾技術將推理從 120 次模型傳遞減至 2 次,計算量降低 60 倍。單個 NVIDIA GB200 可服務 12 個並行會話。
Claude 推出個人財務分析功能,可讀取銀行帳戶資料
Anthropic 推出 Personal Finance,付費用戶可連結美國銀行帳戶,Claude 以對話形式分析消費、帳單和餘額,透過 Plaid 提供只讀存取。為什麼重要
對使用 Claude API 的金融應用開發者重要。系統僅允許讀取,不能進行轉帳或投資操作。Personal Finance hub 內的對話不用於模型訓練,這是 Claude for Legal 和 Claude for Financial Services 業務線的延伸,擴大付費計畫的使用場景。
Decart Lucy 2.6:解決 AI 影片中角色、衣著漂移問題
Decart 發布 Lucy 2.6,改善即時編輯影片中角色臉部、衣著和物件的一致性,防止在連續幀中因移動或遮蔽導致的細節偏移。為什麼重要
對使用生成影片進行直播編輯的開發者重要。版本 2.6 專注改善角色、衣著保真度和物件追蹤,相比 2.5 使用相同的實時和批量介面。價格保持不變;自迴歸生成持續累積誤差,此更新透過改進內部表示來解決。
Goodfire 用可解釋性工具轉換為訓練信號,消除 AI 快捷方式
Goodfire 提出「機制性塑形」方法,將可解釋性工具的信號轉換為損失函數內的懲罰項,抑制模型的獎勵駭客、奉承傾向和虛假快捷方式。為什麼重要
對訓練 LLM、視覺模型和強化學習代理的團隊重要。方法可在訓練中主動抑制特定內部依賴,而無需仰賴數據篩選或獎勵設計。透過稀疏自編碼器(SAE)定位目標概念,使用依賴塑形或表達塑形加權懲罰,能更好地處理資料中難以過濾的失敗模式。
OpenAI 自主網安管道發現並修補 948 個 Linux 核心漏洞
OpenAI 開發自主化管道發現、利用和修補 Linux 核心漏洞,單次運行以 120 萬美元 API 成本驗證並產生 948 個本地特權提升漏洞的修補程式。為什麼重要
對 AI Agent 與安全應用開發者重要。模型發現並使用至少 10 種研究人員認為新穎的 Linux 漏洞利用技術,展示 AI 超越已知方法的能力。相比過往每年發現約 20 個漏洞,該管道在一週內發現約 1,000 個;OpenAI 投入大量前沿計算資源進行開源修補。每個漏洞平均成本約 1,000 美元。
模型公司與研究機構4 條
GPT-6 Cyber:推進對齊的網路安全 Agent 前沿
OpenAI 推出 GPT-6 Cyber,專為尋找可利用的漏洞與開發修復方案設計的網路安全模型,訓練以在授權範圍內保持對齊。為什麼重要
這是 OpenAI 首次發布具有網路安全專長的 Agent 模型。對於從事資安工作的團隊和 AI 安全相關應用的開發者而言值得關注。GPT-6 Cyber 的設計強調了對齊與控制,是 AI Agent 在實務安全領域的重要進展。
Gemini Omni 1.2 Flash:快速且經濟效益高的長片段影片生成與編輯
Google 推出 Gemini Omni 1.2 Flash,支援原生 15 秒影片生成與編輯、更佳的參考遵循,定價較 1.1 版降低 30%。為什麼重要
對於需要大量製作產品影片、虛擬試穿或廣告的團隊而言很實用。模型價格降至 $0.07 每秒 720p 影片、支援更長片段(從 10 秒提升至 15 秒)、改進的多輪編輯能力,以及更強的角色與物體一致性。開發者可透過 Gemini API 使用,企業用戶可在 Gemini for business 與 Google Vids 中使用。
Le Chonk 提供思考能力,Studio 付諸行動
Mistral 推出 Mistral Large 4(Le Chonk)與擴展的 Mistral Studio,支援企業 Agent、工作流程與應用部署,提供完整的模型、資料與基礎設施控制。為什麼重要
適合需要部署企業 Agent 與工作流程的開發團隊。Le Chonk 在編碼、網路安全防禦與文件推理上表現強大。新版 Studio 新增受管 Agent 與應用、工作流程能力、企業上下文、Agent 可觀測性與評估功能。用戶可在雲端、私有 VPC、內部部署或混合環境中部署,保持對模型與資料的完整控制。
使用 PDD Kit 正式驗證 Agent 撰寫的全堆疊網頁應用
Microsoft Research 推出 PDD Kit,透過形式驗證方法將開發者意圖轉換為正式規格,並證明編碼 Agent 產生的程式碼在每一輸入下都符合規格。為什麼重要
這對於依賴 AI Agent 生成大量程式碼的開發團隊而言很重要。PDD Kit 使用 Verus 進行形式驗證,超越了傳統測試的局限,能在逐行人工審查無法擴展的情況下確保 Agent 生成的程式碼品質。在完整網頁應用測試中已驗證登入邏輯,並發現既有缺陷。
Agents、MCP 與開發工具13 條

langgraph-cli 版本 0.4.41
LangGraph CLI 版本 0.4.41 發布,更新依賴項並移除過時的部署測試版通知,包含 langgraph 從 1.2.3 升級至 1.2.14 等改進。為什麼重要
此版本針對 LangGraph 開發工具進行例行維護更新。對使用 LangGraph 構建 Agent 的工程師相關。版本號 0.4.41,主要涉及依賴管理和文件更新。
LangGraph 版本 1.2.20
LangGraph 1.2.20 發布,為每個中斷操作分配獨立 ID,新增嚴格恢復模式以拒絕過期的中斷應答。為什麼重要
此版本改善 LangGraph 對中斷流程的處理機制,適合構建複雜 Agent 的工程師。嚴格恢復模式確保狀態管理的可靠性。版本號 1.2.20。
langgraph-sdk 版本 0.4.13
LangGraph SDK Python 版本 0.4.13 發布,為 Run 物件新增 cancel_reason 欄位,支援線程狀態查詢中的 select 功能。為什麼重要
此版本擴展 SDK 對執行狀態監控和取消操作的支援。對使用 LangGraph API 的開發團隊有用。版本號 0.4.13,新增 API 功能簡化狀態和歷史查詢。

Phonon TTS:高品質裝置端文字轉語音模型
Hugging Face 推出 Phonon 小型文字轉語音模型,可在個人裝置上離線運行,支援 5 種語言和 100+ 內建語音,提供自訂語音功能。為什麼重要
Phonon 基於 Pocket TTS,採用流匹配技術生成高品質語音。65–75 MB 模型可在手機、筆記本、單板電腦和瀏覽器運行。Phonon 31m(英文)為 Apache 2.0 開源,其餘模型非商用許可。適合開發隱私優先的語音應用的工程師。涵蓋英文、法文、德文、西班牙文、葡萄牙文。

TurnWise:改進串流影片強化學習的逐步級信用分配
研究提出 TurnWise,一個基於 GRPO 的串流影片 Agent 框架,通過逐步級信用分配和均衡決策權重,改進串流影片理解任務的效能。為什麼重要
TurnWise 解決軌跡級回報與逐步互動的不匹配問題,促進資訊性回應並降低冗餘。適合做影片理解 Agent 的團隊。核心創新在於使用沉默完成前綴評分構造群體相對優勢,並透過逐步均值政策優化平衡回應與等待決策。

NEO-VLA:從像素到行動的原生視覺語言行動政策
NEO-VLA 研究挑戰 VLA 設計假設,發現有效控制受益於早期視覺計算而非語義特化表示,強調視覺表示形成方式的重要性。為什麼重要
此研究對機器人學習和具身 AI 領域有重要貢獻。適合開發視覺語言行動模型(VLA)和機器人控制系統的團隊。發現原生表示對行動轉移效果更佳,即便凍結時仍有效,挑戰了現有 VLM 編碼器移除方法。

FrontierPhysics:端到端物理研究 Agent 評估基準
Hugging Face 發布 FrontierPhysics 基準,包含 56 個物理學家設計的任務,評估 AI Agent 在文獻回顧、研究計劃、實驗和論文撰寫全流程的能力。為什麼重要
此基準測試 22 個模型在 26 種配置下的表現,最佳設置通過率不超過 46/168。適合研究 Agent 在科學研究領域應用的團隊。基準涵蓋理論、計算和實驗物理 9 大領域。專家評估顯示先進 Agent 的主要弱點是推理缺乏嚴謹性和專業直覺不足。

多輪強化學習對 LLM Agent 的真實改進是什麼?
研究評估多輪 Agent 強化學習效能,發現其優勢高度依賴於互動預算,提出 BudgetMix RL 在訓練中調整預算以提升魯棒性。為什麼重要
此研究揭示 Agent 強化學習的部署風險。適合開發生產級 Agent 系統和強化學習框架的團隊。軌跡級 RL 優勢取決於足夠的轉次預算,當預算緊張時顯著下降。Agent RL 主要優勢集中在錯誤恢復和長地平線韌性。

EmoReward:情感影片生成強化學習的自進化獎勵校準
EmoReward 透過自進化獎勵機制和反射式獎勵閘控,改進 GRPO 在情感影片生成任務中的表現,在 HunyuanVideo 上達到多項改進。為什麼重要
此方法解決主觀審美評估難題。適合做影片生成 Agent 和多獎勵融合的團隊。EmoReward 從實際訓練軌跡中提取證據可靠性,自適應調整多獎勵權重,無需更新獎勵模型。在 HunyuanVideo 1.5、Stable Diffusion 3.5 和 FLUX 上驗證有效。

PyRUA-DataFarm:LLM Agent 作為成本高效的機器人遠程操作員
PyRUA-DataFarm 用編碼 Agent 自動化機器人演示生成,通過模擬、光寫實影片渲染和自動驗證生成可部署訓練數據,成本遠低於人工遠程操作。為什麼重要
此系統適合機器人學習資料收集和策略訓練的團隊。平均每任務 API 成本 $21,渲染 $5,每集 $0.80;一小時三視圖數據平均 $107,低於中國遠程操作 $117 和北美勞動成本 $290。策略訓練性能與遠程操作相當或更佳。

StreamDuo:未見遊戲的實況評論 Agent 和研究 Agent
StreamDuo 配對可訓練評論員與凍結研究 Agent,通過檢索遊戲 Wiki 條目改進跨遊戲串流評論,無需在目標遊戲上訓練。為什麼重要
此系統解決跨遊戲串流知識轉移問題。適合做影片理解 Agent 和知識檢索整合的團隊。在 Baldur's Gate 3 上訓練,測試於 10 款未見遊戲,實體回召從 0.082 提升到 0.116,來源遊戲洩露從 9.9% 降至 1.0%。

Model Context Protocol 伺服器版本 2.3.0
MCP 伺服器系列版本 2.3.0 發布,包含 npm 和 PyPI 套件更新,新增工具註解檢查、資源收集範例和 Streamable HTTP 模式等功能。為什麼重要
此版本涵蓋多個官方 MCP 伺服器套件更新。對使用 MCP 建構 Agent 和工具整合的開發團隊有用。版本 2.3.0 改進伺服器端功能和資源管理,包括 server-everything 2.2.1、server-filesystem 2.2.0、server-memory 2.1.0 和伺服器工具套件。

Semantic Kernel Python 1.47.0 版本發布
Semantic Kernel Python 版本更新至 1.47.0,停止支援 Python 3.10,現在需要 Python 3.11 以上版本,支援至 Python 3.14。為什麼重要
Semantic Kernel 是微軟的開源 AI Agent 開發框架,此次主要變更包括 Python 相依套件統一更新與多項 Bug 修復。涉及 .NET 連接器移除(Milvus)以及 Azure 相關套件版本升級。開發者若使用此框架需注意 Python 版本要求的提升,3.10 環境將無法運行新版本。
AI App、部署與雲端9 條
agent-browser:AI Agent 瀏覽器自動化工具
Vercel Labs 推出的 Rust CLI 工具,讓 AI Agent 可透過指令一步步操控瀏覽器,將頁面轉為無障礙樹狀結構供 Agent 理解與互動。為什麼重要
適合構建需要操作真實瀏覽器的 Agent 應用。agent-browser 將 DOM 元素轉為可引用的 ref(如 @e1),Agent 每次執行一個命令並讀取結果反應,支援 Chrome for Testing、CDP、Browserbase 等多種瀏覽器引擎。
GG Coder:高效能編程 Agent 桌面應用
個人開發者推出的桌面編程 Agent,在同等 Claude Haiku 模型測試下速度最快、成本最低(102 秒、$0.014),整合本地程式碼搜尋與自動化檢查。為什麼重要
GG Coder 對標 Claude Code、Cursor、GitHub Copilot CLI 等代理。支援 Claude、ChatGPT、Gemini、Kimi、本地模型等,內建程式碼安全、合規、無障礙、測試檢查。與其他代理相比,速度快 39% 以上、成本低 58% 以上(基於 20 個代理、700 次運行的公開對標測試)。
@ai-sdk/zai@3.0.47 版本發佈
Vercel AI SDK 的 ZaiChat 提供者更新補丁版本,含依賴更新。
@ai-sdk/xai@5.0.39 版本發佈
Vercel AI SDK 的 xAI 提供者新增伺服器端即時音聲擴展、字幕時間戳與影片上傳功能。為什麼重要
xAI Realtime Model 現可透過 getServerWebSocketConfig() 回傳上游語音 WebSocket URL 與認證標頭,無需用戶端處理;新增對逐字記錄時間粒度控制,以及影片生成/編輯的類型化上傳 URL 回傳。
@ai-sdk/workflow-harness@1.0.174 版本發佈
Vercel AI SDK 工作流框架補丁版本,含依賴更新。
「AI Agent 並非人類,但某種程度上是」- Cloudflare 網站運營視角
Cloudflare 分析 AI Agent 作為中介層對網站營運的挑戰,探討身分驗證、聲譽與問責機制如何重新定義使用者與網站間的信任關係。為什麼重要
Agent 流量正快速成長,可能超越傳統人類瀏覽,網站無法像封禁傳統代理那樣簡單阻止 Agent。文章強調需建立新機制讓網站辨識 Agent 背後的真實使用者,維持安全責任邊界。適合考慮 Agent 相容性的網站營運者與 Agent 開發者閱讀。
Ollama v0.40.15 版本發佈
Ollama 本地 LLM 執行工具更新,修復 Linux CUDA 程式庫載入,增加 MiMo V2.6 模型支援。為什麼重要
本次更新改進 Linux 平台 CUDA 程式庫的行程內載入,並新增對 MiMo V2.6 模型的支援,強化本地推理效能。
llama.cpp b12129 版本發佈
llama.cpp 推理引擎更新,重新啟用 AMD 專有驅動 26.10.1+ 上的大規模 coopmat 矩陣運算設定,改善 GPU 推理效能。為什麼重要
本次更新修復 Vulkan 後端在 AMD 顯示卡上的矩陣運算效能,支援多個平台(macOS、Linux、Windows)與加速框架(CUDA、Vulkan、zDNN)。
llama.cpp b12128 版本發佈
llama.cpp 修復 TOPK_MOE 路由層測試中浮點數邊界導致的不穩定問題,並改進邏輯門控函式的逆向計算。為什麼重要
該修復針對 Mixture of Experts 專家門控在浮點精度邊界上的隨機失敗進行解決,確保不同後端(CPU 與 GPU)的路由決策一致。改進測試穩定性後能更準確驗證 MOE 模型的推理正確性。
中文與日文來源14 條
OpenAI 揭露 AI 助理個人化瓶頸,模型難以善用過往對話
OpenAI 公布日常生活任務基準測試 LifeVal,發現即使 AI 助理能存取過往對話,仍可能漏掉完成任務所需的個人資訊,需要查閱歷史對話的評分條件平均達標率僅 33.33%。為什麼重要
LifeVal 涵蓋 169 項任務,包括照護、教育、購物、個人財務與政府服務。研究發現模型運用個人資訊的能力有限:使用 ChatGPT 記憶的評分條件達標率 47.8%,使用背景資訊的達標率 55.8%。當資訊放入歷史對話後,達標率從 55.8% 降至 41.5%,顯示模型難以有效從過往對話中檢索資訊。使用 ChatGPT 或類似 LLM 助理建構個人化系統的開發者應關注此瓶頸。

臺灣公路局擴大推動無人機 AI 巡檢,結合 3D 建模與影像辨識提升橋梁養護效率
臺灣交通部公路局將無人機巡檢數位化與智慧化,利用 3D 建模追蹤橋梁邊坡變化,整合 AI 影像辨識自動偵測裂縫與劣化跡象,準確率已達 8 成以上。為什麼重要
公路局在中區養護工程分局建立 AI 橋梁巡檢示範,使用超過 2 萬張橋梁影像訓練模型,自動辨識裂縫、混凝土剝落、鋼筋裸露等常見缺失。目前已於台1線西螺大橋、台19線自強大橋等進行驗證,預計 2026 年起逐步推廣至其他分局。無人機巡檢降低工程人員作業風險,克服山區地形限制,建立數位化管理基礎。
OpenAI 收購 Pierre,擴充 Codex 程式碼管理與審查能力
OpenAI 宣布收購開發者工具新創 Pierre Computer Company,整合其 Git 版本控制、程式碼儲存及審查技術至 Codex,讓開發者與 AI 代理人能在同一平臺進行程式碼管理與審查工作。為什麼重要
Pierre 專注 Git 版本控制與程式碼審查,提供 Code Storage 服務與開源函式庫(Trees、Diffs、Highlights)。Codex 已採用 Pierre 的工具;收購完成後,Code Storage 功能將進一步整合至 Codex。此舉與 OpenAI 11 月初推出的版本控制後端 Pando 相呼應,反映 AI 代理人參與軟體開發時對大量程式碼變更與版本管理的需求。使用 AI 輔助開發工具的工程團隊應關注此平臺整合。

在 Codex 中使用 AGENTS.md 與 6 項技能
介紹 Codex AI 助手的 AGENTS.md 設定檔與 6 項實用技能,包括文案編修、UI 設計審查、React 效能檢查等,用於提高開發工作流效率。為什麼重要
AGENTS.md 是 Codex 的行為指引檔案,可設定模型的回應語言與工作規則。作者搭配 skills.sh 工具庫,共用 6 項技能:grill-me(討論企畫細節)、natural-japanese(潤色 AI 文案)、yomiyasu(修改自編文案)、web-design-guidelines(UI 可用性審查)、vercel-react-best-practices(React 效能檢查)、frontend-design(UI 視覺設計)。

用 Claude Code 建立「不用輸入的家計簿」── LINEbot 加 AI 團隊
用 Claude Code 將家計簿輸入流程改為 LINE 傳送單據,由 AI 團隊負責分類、集計、報告、查核,解決「家計簿應用難以持續」的問題。為什麼重要
原因是家計簿應用需要逐筆手工輸入,且遺漏網購、轉帳等無紙本單據。作者用 Claude Code 的 Sub-agent 功能,將工作分為資料整理、集計、報表、點檢 4 個角色,各司其職。重點是分工設計按「資金流程順序」,且決策權保留給人類(例如分類爭議時由 AI 提問確認,不自動決定)。已驗證的案例顯示,透過 Sub-agent 分工,能維持一致的分類規則且出錯易追蹤。

Claude 新手入門 ①【認識】怎麼用?使用指南(2026 年 11 月)
介紹 Claude 家族產品與 Claude Code 的差異、使用情境,並說明 Artifacts 功能如何快速製作文件、簡報、設計稿。為什麼重要
Claude 分為聊天版(claude.ai)與本機開發工具 Claude Code;後者直接操作專案檔案,免去複製貼上。Artifacts 是無程式碼生成介面,內建簡報、文件、設計、儀表板範本,支援即時編輯。模型有 4 層(Fable 最聰慧、Opus 平衡、Sonnet 快速、Haiku 輕量),按場景選用。文中並示例用 Artifacts 快速製作介紹文章。

用 Claude Code 重做個人網站,但文案始終差一步
作者用 Claude Code 實作網站後,發現 AI 生成的文案距預期仍有落差,最終改用 ChatGPT 添削後再人工篩選採用。為什麼重要
實作效率高,但文案層面未能一步到位。AI 生成的表達往往過於制式或冗長。最終流程是:Claude Code 產出初稿→ ChatGPT 添削→人工篩選,才達到滿意成果。表明即使是專門寫作的 AI,也需人工介入以確保語調與意圖相符。

AI 翻譯卡關,其實是日文商品說明「不一致」── 翻譯前先對齊 4 項
介紹翻譯前應統一日文商品說明的 4 項規範:單位、素材名、禁止事項、商品名順序,以助 AI 翻譯精確性。為什麼重要
架空案例展示實務困難:容量混寫「350ml」與「容量350ミリリットル」、素材名在不同欄位變化。翻訳前必須統一單位格式(ml vs mL)、素材正式名稱、禁用詞彙、色票顏色名等。文中示範將 563 行冗長規範精簡至實用版本,並給出 AI 翻譯指示範例與檢查清單,強調「翻譯前做好品質閘門」勝於「翻譯後修改」。

日本語輸入系統 Sumibi 開發 Part 35:測試集加入日常表達後,LLM 的容錯力如何?
Sumibi 日文輸入系統將ベンチマーク 從 200 件教科書文例擴至 628 件日常口語,用 6 大 LLM 進行 11,340 次轉換測試,揭示各模型在真實文章上的表現差異。為什麼重要
新測試集(AJIMEE-BENCH-v2)納入口語表達、同音異義、數字混搭等日常場景。結果顯示:最強的 Gemini 4 Argon 與 GPT-6.1 Sol 在日常表達下仍維持低誤率與快速回應(1.4~1.6 秒內);Gemini 3.8 Flash 雖完全命中率高(77.39%),卻因「多嘴」長篇幅輸出導致平均誤率飆升。該研究首次揭示模型在定型文與生活用語間的「崩落差異」。

GRPO 論文實作速覽:相對報酬、同分群組、更新約束
GRPO(群組相對策略最佳化)是 DeepSeekMath 採用的 LLM 強化學習手法,用同問題多回答的相對報酬比較來更新模型。為什麼重要
GRPO 不需獨立價值模型,改用同問題回答群組的統計量(平均、標差)作比較基準。文中詳析實作要點:回答分組與問題對應、標準差定義影響計算結果、同分群處理(全滿分或全零分時無相對信號)、古舊策略與參考策略的區別。並提醒復現實驗應填寫版本、超參、報酬定義、損失函式等表單,避免同名工具實作迥異導致結果不可比。

AI 代理的故障、重試、復原設計──LLM 能信任到何種程度
分析 AI 代理在業務系統操作時,故障復原的設計要點:技術重試、LLM 動態重選、二重執行、業務規則約束。為什麼重要
以經費申報系統為例,傳統 Web 應用的重試策略(HTTP 客戶端、超時、冪等性)對 AI 代理仍適用,但 LLM 會動態選擇重新呼叫或替代操作。設計時需界定:(1) API 最大試行次數(技術層與 LLM 層的重疊控制);(2) 二重提交用冪等性鑰匙防止;(3) 部分失敗復原(例如上傳成功但下稿創建失敗,需確認中間狀態後重試);(4) 業務規則由服務層守護,LLM 提案受限。重點在「LLM 提供材料與選項,決策權由人類保有」。

用 Muse AI + GitHub 做系統開發:從規格書到上版 1 日完成
用 Meta 的個人 AI「Muse」搭配 GitHub,一日內完成教育用概念模型「Agent Run Guard」的規格撰寫、編碼、測試、上版。為什麼重要
流程分 3 版發布:v0.1 本機原型含 5 項測試、v0.2 規格優先(563→211 行)含 35 項測試、QA 修正 2 項後 42 項全過。關鍵學習:(1) 縮減規格時勿砍關鍵細節(鑰匙名、進入口、終止碼);(2) 失敗行為(如檔案部分寫入)也要入規格,採原子寫入模式;(3) 品質檢查需異常輸入測試(例如 risk 收陣列時的型別檢查);(4) 承認閘門防止無意識更改;(5) 測試成為規格證據。

Antigravity CLI 2026 年定價方案——Free/Pro/Ultra 差異與切換時機
介紹 Antigravity CLI(agy)四種定價方案的差異與應用場景,Free 方案每日約 20 次請求、Pro 月費 $20、Ultra 月費 $249.99,並提供以實運用為基礎的切換判斷基準。為什麼重要
Antigravity CLI 是使用者代理開發工具,支援 Gemini、Claude、GPT-OSS 等模型。對於進行個人開發或小型團隊使用者選擇合適定價方案時有參考價值。無免費額度每週超過 3 次時應考慮 Pro 方案;作為主力工具或團隊重度使用才需升級至 Ultra。文章提供具體判斷流程與費用比較,包括代建工程成本考量。

Claude Console 的 IP 許可清單(測試版)與 Admin API 強制登出功能解說
Anthropic 於 2026 年 11 月 5 日發布兩項安全管理測試功能:Claude Console 組織級 IP 許可清單(支援 IPv4/IPv6 與 CIDR,最多 1,000 筆)及 Admin API 全設備強制登出端點 POST /v1/organizations/users/{user_id}/sign_out。為什麼重要
此兩項功能針對 API 金鑰洩漏或帳戶侵害情境。IP 許可清單作為多層防禦策略與金鑰輪替搭配使用,可限制洩漏金鑰的使用來源;強制登出 API 終止所有瀏覽器與裝置工作階段、信任裝置與 OAuth 權杖,適用於退職或端末遺失應急響應。兩項皆為選用功能且為測試版,相關運維人員應納入安全 Runbook 與 CLAUDE.md 管理流程。須注意強制登出不移除組織成員身份,恆久遮斷需搭配使用者管理操作。
本頁由 Maki Chiang 維護,摘要由 Claude(claude-haiku-4-5)產生於 ;每條均附原文連結,事實以原文為準。